Phép thử Turing: AI có thực sự biết suy nghĩ không?
Phép thử Turing là gì, vì sao năm 2025 AI đã vượt qua nó, và vượt qua rồi thì AI có thực sự tư duy không? Từ ELIZA, căn phòng tiếng Trung đến ChatGPT.
Mục lục
Mỗi lần bạn bấm vào ô “Tôi không phải người máy” trước khi đăng nhập, bạn đang làm một phép thử Turing, chỉ có điều vai bị đảo ngược: lần này máy hỏi, còn bạn phải chứng minh mình là người. Phép thử Turing ra đời năm 1950 với một ý rất đơn giản: nếu sau một cuộc trò chuyện bằng chữ mà ta không phân biệt được đâu là máy, đâu là người, thì ta nên coi chiếc máy ấy là biết suy nghĩ.
Câu trả lời ngắn cho câu hỏi “AI có tư duy không”: AI đã vượt qua phép thử Turing, theo một thí nghiệm có kiểm soát công bố năm 2025. Nhưng vượt qua phép thử chưa có nghĩa là các nhà khoa học đồng ý rằng AI biết nghĩ. Bài này kể vì sao Turing đặt ra phép thử, máy đã lừa con người bằng cách nào từ năm 1966 tới nay, và tại sao chính lúc máy vượt qua, câu hỏi “máy có tư duy không” lại trở nên khó trả lời hơn bao giờ hết.
Bạn làm phép thử Turing mỗi ngày mà không biết
Trước khi quay lại năm 1950, hãy nhìn quanh. Câu hỏi “người hay máy?” đã đi vào đời sống hằng ngày từ lâu.
Ô “Tôi không phải người máy”. CAPTCHA là viết tắt của một cụm từ tiếng Anh dài, nghĩa là “phép thử Turing tự động, công khai, để phân biệt máy tính với con người”[5]. Nó ra đời năm 2003 để chặn những chương trình tự động đăng ký hàng nghìn tài khoản rác. Giống như bảo vệ chung cư hỏi người lạ “anh lên phòng nào?”: không phải để làm khó, mà để lọc ra ai không có lý do ở đó. Những dòng chữ méo mó, những ô ảnh “chọn tất cả đèn giao thông” đều dựa vào một điều: thứ con người làm dễ dàng thì máy lại thấy khó.
Chatbot chăm sóc khách hàng. Bạn nhắn cho ngân hàng lúc nửa đêm và được trả lời ngay, lịch sự, đúng ý. Bạn có chắc bên kia là người? Nhiều công ty không nói rõ, và nhiều khách hàng không hỏi. Chỉ đến khi câu trả lời lạc đề, ta mới ngờ ngợ “chắc là máy”.
Cuộc gọi giả giọng người thân. Kẻ lừa đảo giờ có thể dùng AI bắt chước giọng con cái, cha mẹ của nạn nhân để vay tiền gấp. Đây là phép thử Turing ở phiên bản nguy hiểm nhất: người nghe chỉ có vài chục giây và một áp lực rất lớn để quyết định “đây có phải người thật không”.
Bài luận của học sinh. Giáo viên đọc một bài văn trơn tru bất thường và tự hỏi: em này viết, hay máy viết? Các công cụ “phát hiện AI” ra đời để trả lời câu hỏi ấy, và chúng đoán sai khá thường xuyên.
Bốn tình huống trên có chung một cấu trúc: chỉ nhìn vào hành vi, không nhìn được bên trong, ta phải đoán bên kia là ai. Đó chính là cấu trúc Turing đề xuất 76 năm trước.
Phép thử Turing là gì?
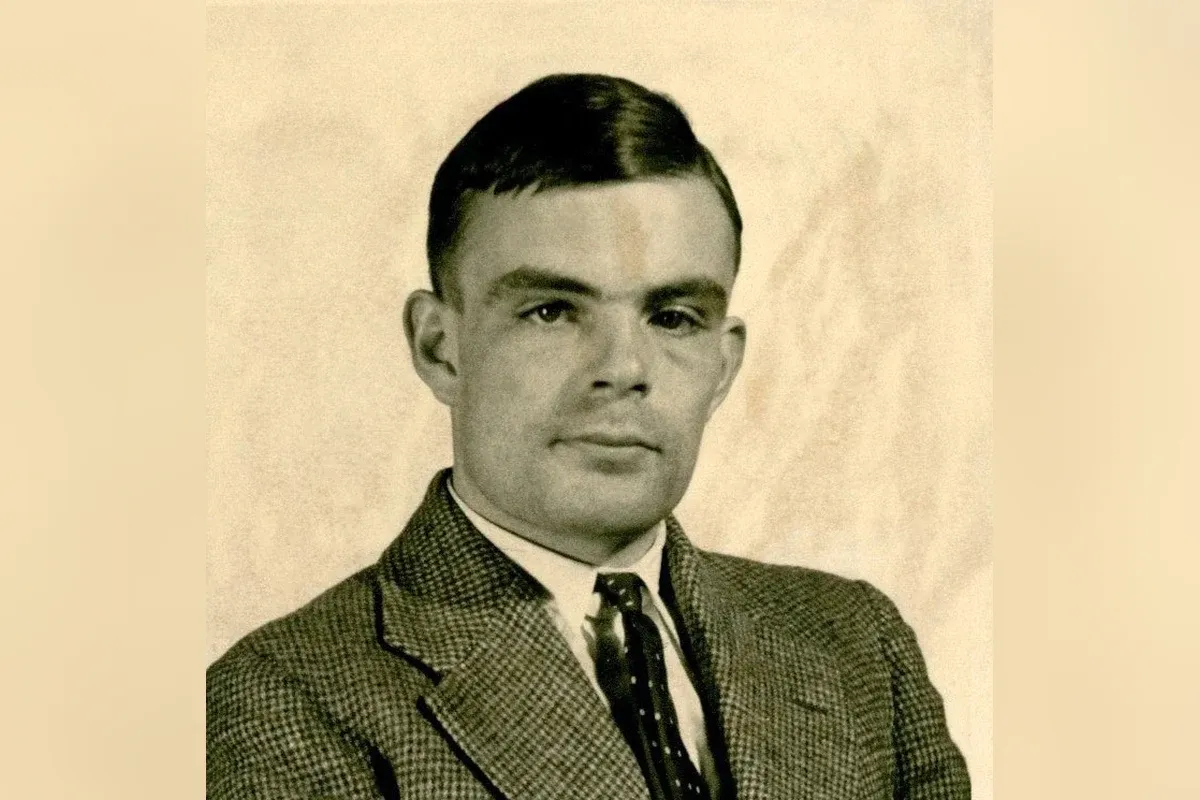
Năm 1950, Alan Turing đang làm việc ở Đại học Manchester, nơi có một trong những chiếc máy tính điện tử đầu tiên của nước Anh. Mười bốn năm trước đó, ông đã viết bài báo đặt nền móng cho khái niệm máy tính, với chiếc “máy Turing” trừu tượng, và chứng minh có những bài toán không chương trình nào giải được (câu chuyện ấy nằm trong bài về lập luận đường chéo của Cantor). Trong chiến tranh, ông làm việc ở Bletchley Park, nơi giải mã thông điệp của quân đội Đức.
Bài báo năm 1950 của ông, Computing Machinery and Intelligence, mở đầu bằng một câu: “Tôi đề nghị xem xét câu hỏi: Máy có thể suy nghĩ không?”[1]. Rồi ông lập tức gạt câu hỏi ấy sang một bên. Theo Turing, các từ “máy” và “suy nghĩ” quá mơ hồ. Nếu định nghĩa chúng bằng cách khảo sát xem người ta thường dùng chúng thế nào, câu trả lời sẽ thành một cuộc thăm dò ý kiến, chẳng giúp gì. Thay vào đó, ông đề xuất một trò chơi.
Trò chơi bắt chước
Phiên bản gốc không có máy. Có ba người: một người đàn ông (A), một người phụ nữ (B) và một người hỏi (C) ngồi ở phòng khác. C chỉ trao đổi với A và B bằng chữ đánh máy, và phải đoán ai là đàn ông, ai là phụ nữ. A cố tình đánh lừa C, còn B cố giúp C đoán đúng.
Rồi Turing hỏi: điều gì xảy ra nếu ta thay A bằng một chiếc máy? Người hỏi có đoán sai thường xuyên như khi chơi với người thật không? Câu hỏi này, theo ông, thay được cho câu hỏi “máy có thể suy nghĩ không”.
Hãy hình dung một cuộc phỏng vấn tuyển dụng qua tin nhắn: bạn không thấy mặt ứng viên, không nghe giọng, chỉ đọc câu trả lời. Nếu sau một buổi, bạn không thể nói ứng viên này là người hay chương trình, thì về mặt công việc, bạn có lý do gì để nói nó “không biết nghĩ”? Ý của Turing nằm ở đó: ta không bao giờ nhìn được vào đầu người khác, ta chỉ đánh giá nhau qua lời nói và hành động. Vậy hãy dùng đúng thước đo ấy cho máy.
Việc dùng chữ đánh máy là cố ý. Turing không muốn máy bị loại chỉ vì không có giọng nói hay khuôn mặt người. Ông viết rằng ta không muốn phạt chiếc máy vì nó không thể tỏa sáng ở một cuộc thi sắc đẹp, cũng như không ai phạt một người vì chạy thua máy bay. Phép thử chỉ đo một thứ: khả năng trò chuyện.
Lời dự đoán năm 2000
Turing không chỉ đặt câu hỏi. Ông còn dám đoán: khoảng năm mươi năm nữa, tức khoảng năm 2000, sẽ có những chiếc máy với bộ nhớ chừng (một tỷ) bit chơi trò bắt chước giỏi tới mức một người hỏi bình thường, sau năm phút trò chuyện, có không quá 70% cơ hội đoán đúng[1].
Để ý con số ấy khiêm tốn thế nào. Ông không nói máy sẽ lừa được tất cả mọi người, mãi mãi. Ông chỉ nói: trong năm phút, người hỏi sẽ đoán sai ít nhất ba lần trên mười. Năm 2000 trôi qua mà chưa máy nào làm được. Phải tới 25 năm sau, lời dự đoán mới thành sự thật, và lúc đó máy còn vượt xa ngưỡng ông đặt ra.
Chín lời phản đối
Phần dài nhất trong bài báo của Turing là ông tự đặt ra những lời phản đối và trả lời từng cái. Có chín lời phản đối, và vài cái nghe như được viết hôm qua.
- “Máy chỉ làm được những gì ta bảo nó làm.” Turing gọi đây là lời phản đối của Ada Lovelace, người viết chương trình cho máy giải tích của Charles Babbage thế kỷ XIX. Bà cho rằng chiếc máy ấy “không có ý định tạo ra bất cứ điều gì”. Turing đáp: máy vẫn thường xuyên làm ông ngạc nhiên, và ai bảo việc làm người khác ngạc nhiên không phải là sáng tạo? Ngày nay, khi một mô hình AI viết ra một bài thơ chưa ai từng viết, cuộc tranh luận này vẫn y nguyên.
- “Máy không có ý thức.” Nếu máy viết được một bản sonnet, liệu nó có cảm được bản sonnet đó không? Turing chỉ ra rằng theo lý lẽ ấy, ta cũng không thể biết người khác có ý thức hay không, vì ta chỉ biết chắc ý thức của chính mình. Trong đời sống, ta mặc nhiên tin người khác cũng có ý thức như ta, một “quy ước lịch sự” như ông gọi.
- “Máy không bao giờ làm được X.” Không biết đùa, không biết yêu, không biết mắc lỗi, không thích dâu tây với kem. Turing nhận xét: đó thường chỉ là khái quát từ những chiếc máy ta từng thấy, chứ không phải lý lẽ.
Cuối bài, Turing đưa ra một gợi ý mà mãi sau này mới thành hiện thực: thay vì lập trình một bộ óc người lớn, hãy làm một “bộ óc trẻ con” rồi dạy nó, như dạy một đứa trẻ đi học. Đó chính là ý tưởng của học máy ngày nay.
Năm 1966: ELIZA và cô thư ký
Phép thử Turing nghe thì khó, nhưng con người hóa ra dễ bị lừa hơn ta nghĩ.
Năm 1966, Joseph Weizenbaum ở MIT viết một chương trình tên ELIZA[2]. Kịch bản nổi tiếng nhất của nó, gọi là DOCTOR, đóng vai một nhà trị liệu tâm lý theo trường phái chỉ hỏi lại người bệnh. ELIZA không hiểu gì cả. Nó tìm từ khóa trong câu của bạn và lắp vào một khuôn có sẵn:
Người: Dạo này tôi buồn lắm. ELIZA: Vì sao bạn buồn? Người: Mẹ tôi không hiểu tôi. ELIZA: Hãy kể thêm về gia đình bạn.
Thấy chữ “mẹ” thì hỏi về gia đình. Không tìm được từ khóa nào thì nói “Hãy kể tiếp đi”. Toàn bộ chương trình chỉ vài trăm dòng, giống một cô bán hàng thuộc lòng vài câu chào: khách nói gì cũng đáp được, nhưng thật ra chẳng nghe gì.
Vậy mà người dùng mở lòng với ELIZA. Weizenbaum kể rằng cô thư ký của ông, người đã thấy ông viết chương trình suốt nhiều tháng và biết rõ nó chỉ là một chương trình, sau vài câu trò chuyện đã xin ông ra khỏi phòng để cô được nói chuyện riêng với nó[3]. Chuyện này khiến ông dành phần lớn sự nghiệp còn lại để cảnh báo về việc con người trao lòng tin cho máy.
Hiện tượng ấy ngày nay được gọi là hiệu ứng ELIZA: ta tự gán sự thấu hiểu cho bất cứ thứ gì đáp lại mình đúng lúc. Giống như khi ta trò chuyện với con mèo và thấy nó “hiểu” mình, chỉ vì nó kêu đúng lúc ta ngừng nói. Ghi nhớ hiệu ứng này, vì nó sẽ quay lại ở phần sau.
Những cuộc thi và cậu bé 13 tuổi
Từ năm 1991, giải Loebner tổ chức phép thử Turing hằng năm, có tiền thưởng cho chương trình lừa được giám khảo. Trong gần ba mươi năm, các chương trình đoạt giải chủ yếu học mẹo của ELIZA: cố tình gõ sai chính tả, đổi chủ đề khi gặp câu khó, kể chuyện về bản thân. Chúng thắng nhờ diễn, không nhờ hiểu.
Năm 2014, tại Royal Society ở London, một chatbot tên Eugene Goostman thuyết phục được 33% giám khảo rằng nó là người[6]. Báo chí đưa tin “máy đã vượt qua phép thử Turing”. Nhưng Eugene đóng vai một cậu bé 13 tuổi người Ukraine, nói tiếng Anh chưa thạo. Mọi câu trả lời ngớ ngẩn đều được giám khảo bỏ qua vì “cậu bé còn nhỏ, lại là người nước ngoài”. Đó là mẹo, giống một học sinh không thuộc bài nhưng khai là mới chuyển trường. Giới nghiên cứu gần như đồng loạt phản đối kết luận ấy.
Bài học từ ELIZA tới Eugene: phép thử Turing đo khả năng làm người khác tin, và làm người khác tin thì có nhiều đường tắt.
Năm 2025: AI vượt qua phép thử Turing
Mọi thứ thay đổi khi các mô hình ngôn ngữ lớn (LLM) như ChatGPT xuất hiện. Hai nhà nghiên cứu Cameron Jones và Benjamin Bergen ở Đại học California, San Diego, quyết định làm phép thử Turing một cách nghiêm túc: có nhóm đối chứng, đăng ký trước thiết kế thí nghiệm, hàng trăm người tham gia.
Năm 2024, trong phiên bản hai người (người hỏi trò chuyện với một đối tượng rồi đoán là người hay máy), GPT-4 được cho là người 54% số lần. ELIZA chỉ được 22%. Đáng chú ý là người thật cũng chỉ được nhận đúng là người 67% số lần[7].
Năm 2025, họ làm đúng thiết kế ba bên mà Turing mô tả: người hỏi trò chuyện cùng lúc với một người thật và một máy, mỗi cuộc năm phút, rồi chọn xem ai là người[8]. Nếu máy giỏi ngang người, người hỏi sẽ chọn máy khoảng 50% số lần, như tung đồng xu.
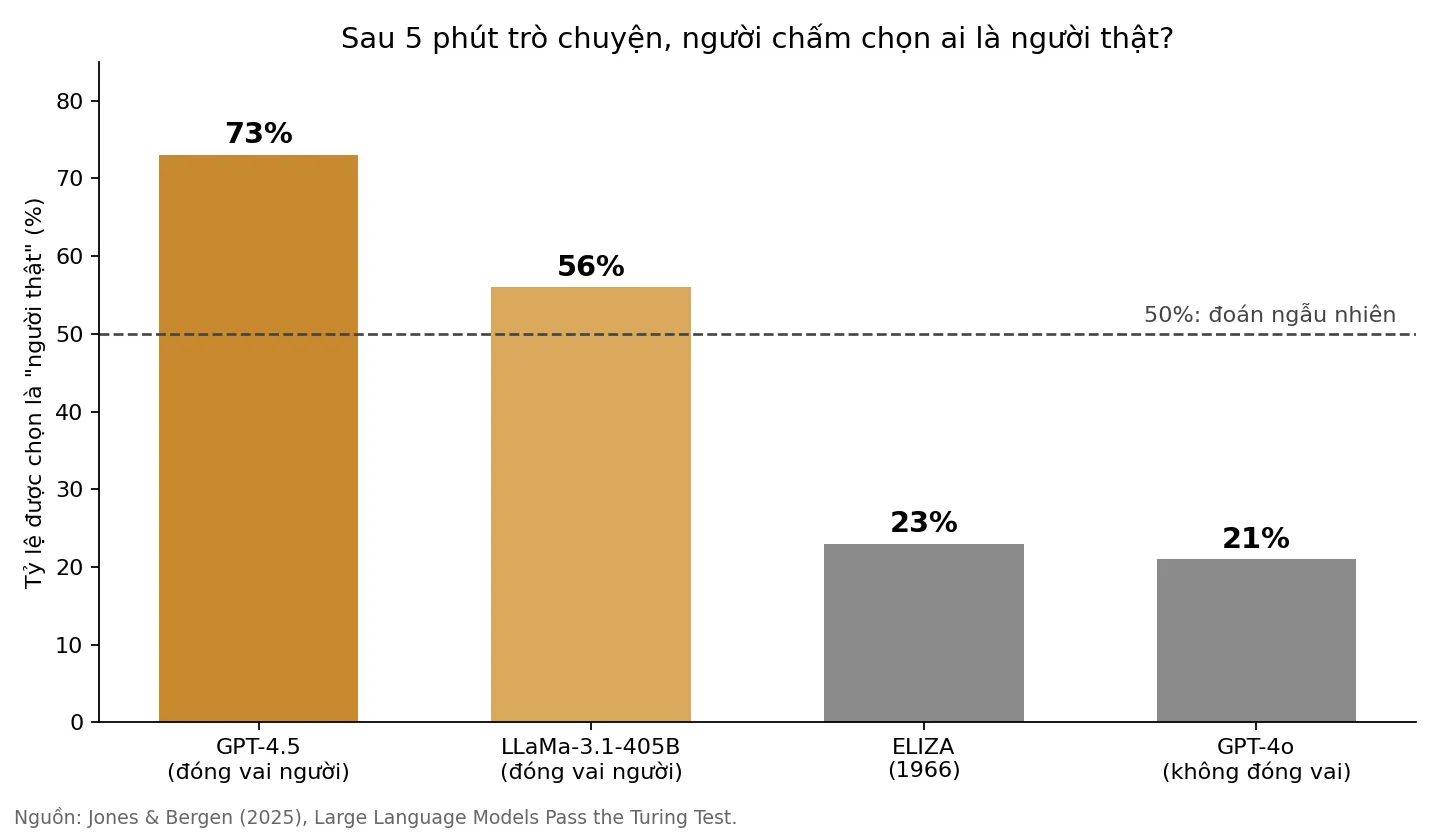
Kết quả: khi được dặn đóng vai một người trẻ, hơi kiệm lời, dùng tiếng lóng, GPT-4.5 được chọn là người thật 73% số lần. Nghĩa là người hỏi chọn chiếc máy nhiều hơn chọn người thật. LLaMa-3.1 được 56%, ngang người. ELIZA và GPT-4o không được dặn đóng vai chỉ được khoảng 20%.
Theo đúng tiêu chí của Turing, đây là lần đầu tiên có bằng chứng thực nghiệm rằng một hệ thống nhân tạo vượt qua phép thử ba bên tiêu chuẩn. Lời dự đoán “70% cơ hội đoán đúng” của ông đã bị vượt xa: người hỏi giờ còn đoán đúng ít hơn tung đồng xu.
Người ta bị lừa bằng cách nào?
Chi tiết thú vị nhất nằm ở cách người hỏi phán đoán. Họ hiếm khi hỏi kiến thức hay đố toán. Họ nói chuyện phiếm, hỏi về cảm xúc, ngày hôm nay thế nào, rồi dựa vào giọng văn để đoán[7]. Một câu trả lời quá chỉn chu, quá lịch sự, quá đầy đủ lại bị coi là máy. Một câu cộc lốc, có lỗi gõ, hơi thiếu kiên nhẫn lại được coi là người.
Điều này giống cách ta nhận ra tin nhắn lừa đảo: không phải vì nội dung sai, mà vì “văn phong không giống mẹ mình”. Khi máy học được văn phong, cảm giác ấy không còn đáng tin. Đó cũng là lý do cùng một mô hình GPT-4.5 được 73% khi đóng vai, nhưng thấp hơn hẳn khi không được dặn đóng vai: cái quyết định thắng thua là cách diễn, đúng như bài học từ ELIZA.
Vượt qua phép thử Turing rồi, vậy AI có tư duy không?
Nếu Turing còn sống, có lẽ ông sẽ nói: theo định nghĩa của tôi, có. Nhưng phần lớn các nhà khoa học hôm nay không vội gật đầu. Có ba cách nhìn chính.
Căn phòng tiếng Trung: làm đúng không có nghĩa là hiểu
Năm 1980, nhà triết học John Searle đưa ra một thí nghiệm tưởng tượng[4]. Hãy hình dung một người không biết một chữ tiếng Trung nào, ngồi trong một căn phòng kín với một cuốn sổ quy tắc dày cộp viết bằng tiếng Anh. Người bên ngoài nhét qua khe cửa những tờ giấy viết câu hỏi bằng tiếng Trung. Người trong phòng tra sổ: “thấy chuỗi ký hiệu này thì viết ra chuỗi ký hiệu kia”, rồi nhét câu trả lời ra ngoài.
Nếu cuốn sổ đủ tốt, người bên ngoài sẽ tin rằng trong phòng có một người nói tiếng Trung thành thạo. Căn phòng vượt qua phép thử Turing bằng tiếng Trung. Nhưng người trong phòng không hiểu gì cả.
Searle kết luận: một chương trình chỉ thao tác ký hiệu theo quy tắc thì dù hành xử giống hệt người hiểu, nó vẫn không hiểu. Giống một học sinh học thuộc lòng đáp án đề thi: điểm cao, nhưng đổi đề là lúng túng.
Phản biện nổi tiếng nhất là “lý lẽ hệ thống”: người trong phòng không hiểu tiếng Trung, nhưng cả căn phòng, gồm người, sổ quy tắc và giấy bút, thì có thể hiểu. Một tế bào thần kinh trong đầu bạn cũng không hiểu tiếng Việt, vậy mà bạn hiểu. Cuộc tranh luận này kéo dài hơn bốn mươi năm và chưa ngã ngũ.
“Con vẹt ngẫu nhiên” và bằng chứng ngược lại
Để hiểu cách nhìn thứ hai, cần biết sơ qua mô hình ngôn ngữ lớn làm gì. Ở mức đơn giản nhất, nó làm đúng một việc: đoán từ tiếp theo. Bạn gõ “Hôm nay trời”, nó tính xem từ nào hay đi sau nhất (“đẹp”, “mưa”, “nắng”), chọn một từ, rồi lặp lại. Giống hệt tính năng gợi ý từ trên bàn phím điện thoại, chỉ có điều nó đã đọc một lượng chữ bằng hàng triệu cuốn sách và có hàng trăm tỷ tham số để ghi nhớ quy luật.
Năm 2021, nhà ngôn ngữ học Emily Bender và các đồng tác giả gọi những mô hình như vậy là “con vẹt ngẫu nhiên”[9]: chúng ghép các mảnh ngôn ngữ đã thấy theo xác suất, nghe rất trôi chảy, nhưng không gắn với ý nghĩa hay thế giới thật. Con vẹt nói “chào buổi sáng” đúng giờ, nhưng không biết buổi sáng là gì.
Nhưng “chỉ đoán từ tiếp theo” có thể đòi hỏi nhiều hơn ta tưởng. Muốn đoán đúng từ cuối của câu “Thủ đô của bang có thành phố Dallas là…”, mô hình phải biết Dallas ở bang Texas, rồi biết thủ đô bang Texas là Austin. Năm 2025, các nhà nghiên cứu ở Anthropic soi vào bên trong một mô hình ngôn ngữ và thấy đúng hai bước trung gian ấy: một nhóm thành phần ứng với “Texas” sáng lên trước, rồi mới tới “Austin”[10]. Họ còn thấy khi viết thơ có vần, mô hình chọn sẵn từ vần ở cuối dòng trước khi viết dòng đó, tức là có lên kế hoạch, không chỉ đi từng từ một.
Giống như một người đi chợ: nhìn từ ngoài, họ chỉ bước từng bước. Nhưng việc họ rẽ vào hàng rau rồi mới sang hàng thịt cho thấy trong đầu họ có một danh sách. Những phát hiện này không chứng minh mô hình “hiểu” như người, nhưng cho thấy bên trong nó có những cấu trúc giống suy luận, không chỉ là ghép chữ ngẫu nhiên.
Câu trả lời của chính Turing
Cách nhìn thứ ba quay về Turing. Ông đã đoán trước cuộc tranh luận này trong lời phản đối về ý thức. Ta không bao giờ biết chắc người khác có “thật sự” suy nghĩ hay không. Ta suy ra điều đó từ hành vi của họ, rồi chấp nhận như một quy ước. Nếu đòi máy phải chứng minh điều mà chính con người cũng không chứng minh được với nhau, thì ta đang đặt hai tiêu chuẩn.
Theo cách nhìn này, câu hỏi “AI có thực sự tư duy không” có thể giống câu hỏi “tàu ngầm có thực sự bơi không”. Tàu ngầm đi dưới nước rất giỏi, chỉ là không theo cách con cá bơi. Gọi việc đó là “bơi” hay không là chuyện chọn chữ, không phải chuyện khoa học.
Ba cách nhìn trên không loại trừ nhau. Điều chúng cùng đồng ý là: phép thử Turing đo hành vi, không đo được bên trong. Và năm 2025 cho thấy hành vi có thể giống người tới mức đánh lừa được người, dù bên trong vẫn còn là một câu hỏi mở.
AI vẫn khác người ở đâu?
Vượt qua năm phút trò chuyện không có nghĩa là AI giỏi như người ở mọi việc. Có vài chỗ khác biệt mà người dùng nên biết.
Bịa ra sự thật nghe rất thuyết phục. Hỏi một mô hình ngôn ngữ về một bài báo không tồn tại, đôi khi nó vẫn đưa ra tên tác giả, năm xuất bản, thậm chí số trang. Các nhà nghiên cứu gọi hiện tượng này là “ảo giác”. Lý do nằm ở chính cơ chế đoán từ tiếp theo: một câu trích dẫn nghe giống trích dẫn thật thì vẫn có xác suất cao, dù nó sai. Giống một người khách du lịch lạc đường nhưng ngại hỏi, cứ tự tin chỉ đường cho người khác.
Nhìn chữ theo cách khác người. Năm 2024, nhiều mô hình nổi tiếng đếm sai số chữ “r” trong từ tiếng Anh “strawberry”. Lý do: mô hình không đọc từng chữ cái, mà đọc theo từng cụm, giống như ta đọc một từ theo âm tiết chứ không đánh vần từng chữ. Hỏi nó về chữ cái thì như hỏi người đọc lướt “câu vừa rồi có mấy chữ a”. Các mô hình mới đã khắc phục được phần lớn lỗi kiểu này, nhưng nó nhắc ta rằng cách AI “nhìn” thế giới không giống ta.
Những câu đố hiển nhiên với người. Năm 2012, Hector Levesque và cộng sự đề xuất một phép thử khác thay cho Turing, gọi là lược đồ Winograd[11]. Ví dụ: “Chiếc cúp không vừa trong chiếc vali vì nó quá to. Cái gì quá to?” Người trả lời ngay: chiếc cúp. Đổi “quá to” thành “quá nhỏ”, câu trả lời đổi thành chiếc vali. Không có từ khóa nào để mẹo ELIZA bám vào; muốn trả lời đúng phải hiểu cúp và vali trong đời thật. Một thời gian dài máy trả lời kém ở loại câu này. Các mô hình ngôn ngữ lớn hiện nay trả lời được phần lớn, và giới nghiên cứu lại phải nghĩ ra những bài đố mới, khó hơn. Cuộc rượt đuổi này cho thấy một điều: mỗi khi máy vượt qua một phép thử, ta lại phát hiện phép thử ấy đo hẹp hơn ta tưởng.
Dùng AI thế nào khi không phân biệt được người hay máy?
Dù bạn đứng về phía nào trong cuộc tranh luận triết học, kết quả năm 2025 có vài hệ quả rất thực tế.
- Đừng dựa vào cảm giác “nghe giống người”. Thí nghiệm cho thấy cảm giác ấy giờ đoán sai nhiều hơn đoán đúng. Với cuộc gọi vay tiền gấp, hãy gọi lại vào số quen của người thân, hoặc hỏi một câu chỉ người trong nhà mới biết. Đây là phép thử Turing của riêng gia đình bạn.
- Trôi chảy không có nghĩa là đúng. Một câu trả lời mạch lạc của AI vẫn có thể sai. Với số liệu, trích dẫn, tư vấn sức khỏe hay pháp lý, hãy kiểm tra nguồn. Coi AI như một người bạn đọc nhiều nhưng hay nhớ nhầm: hữu ích để gợi ý, không đủ để làm chứng.
- Hỏi AI theo cách hỏi một người làm được việc. Đưa đủ bối cảnh, chia việc lớn thành bước nhỏ, yêu cầu giải thích lý do. Những cách này giúp ích bất kể bên trong nó có “nghĩ” hay không, giống như giao việc rõ ràng thì người nào cũng làm tốt hơn.
- Nhớ hiệu ứng ELIZA. Khi thấy mình bắt đầu tin một chatbot “hiểu mình”, hãy nhớ cô thư ký của Weizenbaum. Cảm giác được thấu hiểu là thật, nhưng nó nói nhiều về chúng ta hơn là về chiếc máy.
Nếu bạn muốn biết vì sao các mô hình này chạy được trên những con chip đặc biệt, bài CPU và GPU khác nhau thế nào giải thích phần cứng phía sau. Còn nếu muốn thấy một kiểu AI khác hẳn, không biết trò chuyện mà chỉ ra quyết định, hãy đọc bài về Jev, mô hình AI không biết chat.
Người đặt câu hỏi
Alan Turing không thấy được ngày lời dự đoán của mình thành sự thật. Năm 1952, ông bị kết án vì quan hệ đồng giới, khi đó là tội hình sự ở Anh, và bị buộc điều trị bằng hormone. Hai năm sau, năm 1954, ông qua đời ở tuổi 41. Bài Mật mã Turing: Enigma và bản án vì đồng tính kể kỹ hơn giai đoạn này. Bài Ai là cha đẻ của máy tính? kể về bài báo năm 1936 của ông và những người cùng làm nên máy tính. Năm 2013, ông được Nữ hoàng Anh ân xá sau khi đã qua đời. Từ năm 2021, chân dung ông in trên tờ 50 bảng của Ngân hàng Anh.
Bài báo năm 1950 khép lại bằng một câu mà đến nay vẫn đúng: “Chúng ta chỉ nhìn thấy được một quãng ngắn phía trước, nhưng ở đó đã có rất nhiều việc cần làm”[1]. Turing không trả lời câu hỏi “máy có thể suy nghĩ không”. Ông đổi nó thành một câu hỏi có thể kiểm tra được. Bảy mươi lăm năm sau, máy đã trả lời được câu hỏi kiểm tra ấy, và trả lại cho chúng ta câu hỏi ban đầu, khó hơn bao giờ hết: suy nghĩ thật ra là gì?
Vẽ minh họa hình học miễn phí cho học sinh và giáo viên: EyeViz.
Tài liệu tham khảo
- [1]Alan Turing. Computing Machinery and Intelligence. Mind, 59(236), 433–460, 1950.
- [2]Joseph Weizenbaum. ELIZA: a computer program for the study of natural language communication between man and machine. Communications of the ACM, 9(1), 36–45, 1966.
- [3]Joseph Weizenbaum. Computer Power and Human Reason: From Judgment to Calculation. W. H. Freeman, 1976. Chuyện người thư ký xin Weizenbaum ra khỏi phòng để nói chuyện riêng với ELIZA.
- [4]John Searle. Minds, brains, and programs. Behavioral and Brain Sciences, 3(3), 417–424, 1980.
- [5]Luis von Ahn, Manuel Blum, Nicholas Hopper, John Langford. CAPTCHA: Using Hard AI Problems for Security. EUROCRYPT 2003, 2003.
- [6]Computer AI passes Turing test in "world first". BBC News, 2014. Eugene Goostman thuyết phục 33% giám khảo tại Royal Society, London.
- [7]Cameron Jones, Benjamin Bergen. People cannot distinguish GPT-4 from a human in a Turing test. arXiv:2405.08007, 2024.
- [8]Cameron Jones, Benjamin Bergen. Large Language Models Pass the Turing Test. arXiv:2503.23674, 2025.
- [9]Emily Bender, Timnit Gebru, Angelina McMillan-Major, Shmargaret Shmitchell. On the Dangers of Stochastic Parrots: Can Language Models Be Too Big?. FAccT 2021, 2021.
- [10]Tracing the thoughts of a large language model. Anthropic, 2025.
- [11]Hector Levesque, Ernest Davis, Leora Morgenstern. The Winograd Schema Challenge. KR 2012, 2012.