AI có biết suy nghĩ không? Từ AlphaGo đến ChatGPT
AI có biết suy nghĩ không, hay chỉ là cỗ máy thống kê? Bốn phép thử từ AlphaGo, nước 37 của Lee Sedol tới ChatGPT cho thấy AI hiểu tới đâu và hỏng ở đâu.
Mục lục
Nước 37
Ngày 10 tháng 3 năm 2016, ở một khách sạn tại Seoul, Lee Sedol rời phòng đấu một lúc. Khi ông quay lại, chương trình AlphaGo đã đặt quân thứ 37 của ván cờ lên phía phải bàn cờ. Hai bình luận viên chuyên nghiệp cùng sững lại. Một người nói đó là một nước rất lạ, người kia nghĩ máy đánh nhầm. Lee Sedol mất gần 15 phút mới đáp lại được[1].
Nước đi ấy không nhầm. Nó xoay chuyển ván đấu, và AlphaGo thắng. Sau ván, Lee Sedol nói: “Hôm qua tôi ngạc nhiên. Hôm nay tôi không còn lời nào”[1].
Mười năm sau, câu hỏi từ căn phòng ấy đã đi vào điện thoại của mọi người. AI có biết suy nghĩ không, hay chỉ là một cỗ máy thống kê làm tốt việc được huấn luyện? Câu trả lời ngắn của bài này: AI hiện nay đúng là một cỗ máy thống kê, nhưng câu đó không kết thúc được cuộc tranh luận. Nó chỉ nói AI được tạo ra bằng gì, chưa nói AI làm được gì. Vì vậy, thay vì tranh cãi chữ nghĩa, ta sẽ đưa AI qua bốn phép thử có thể kiểm chứng: sáng tạo, hiểu khái niệm, biết mình đang làm gì, và xử lý một đề bài bị đổi nhẹ.
Kết quả không nghiêng hẳn về bên nào, và chính sự không nghiêng ấy cho biết nhiều điều về AI hơn một câu có hoặc không.
“Biết suy nghĩ” nghĩa là gì?
Muốn trả lời, ta cần một định nghĩa có thể kiểm tra. Bài phép thử Turing đã kể chuyện năm 1950 Alan Turing thay câu hỏi “máy có nghĩ không” bằng một phép thử trò chuyện, và chuyện John Searle phản đối bằng căn phòng tiếng Trung. Hai bên vẫn chưa ngã ngũ, và AI đã vượt qua phép thử trò chuyện năm 2025. Nên bài này chọn một tiêu chí khác, hẹp hơn.
Hình dung hai người lái xe trong cùng một thành phố. Người thứ nhất thuộc lòng một nghìn tuyến đường. Người thứ hai có trong đầu một tấm bản đồ. Trên những tuyến quen, hai người chạy giống hệt nhau, thậm chí người thuộc lòng còn nhanh hơn. Khác biệt chỉ lộ ra vào ngày có một con đường bị cấm. Người có bản đồ tìm lối khác. Người thuộc lòng thì kẹt.
Tiêu chí của bài này là vậy: suy nghĩ thể hiện ở khả năng mang hiểu biết sang tình huống mới, không chỉ ở việc làm tốt trong vùng đã được luyện. Đây không phải định nghĩa duy nhất, và nó không nói gì về ý thức, tức cảm giác bên trong khi nghĩ. Ý thức hiện chưa có phép đo nào đáng tin, nên bài này không phán quyết. Nhưng tấm bản đồ thì có thể kiểm tra: chỉ cần cấm một con đường rồi xem chuyện gì xảy ra.
AlphaGo học đánh cờ thế nào?
Cờ vây có luật đơn giản: hai người lần lượt đặt quân đen, trắng lên bàn 19 × 19 đường, bao vây đất và quân đối phương. Vậy mà số thế cờ nhiều tới mức không máy nào duyệt hết. Tính trước vài nước theo kiểu cờ vua không đủ, vì mỗi lượt có quá nhiều lựa chọn, và rất khó nói ai đang hơn. Kỳ thủ giỏi dựa nhiều vào cảm giác về thế cờ.
AlphaGo được xây để bắt chước đúng hai năng lực ấy[2]. Bộ phận thứ nhất là một mạng nơ-ron, tức một hàm số khổng lồ có hàng triệu núm chỉnh, được chỉnh dần qua dữ liệu. Giống người học nếm phở qua hàng nghìn bát, mạng học gợi ý vài nước đáng xét và ước lượng ai đang có lợi. Ban đầu nó học từ các ván của kỳ thủ giỏi, rồi tự đấu với chính nó hàng triệu ván[1][2].
Bộ phận thứ hai là tìm kiếm: từ những nước được gợi ý, chương trình thử đi tiếp nhiều nhánh trong đầu, rồi chọn nhánh có kết quả tốt nhất. Mạng nơ-ron là trực giác, tìm kiếm là tính toán. Một kỳ thủ cũng vừa cảm thế cờ vừa tính vài nước.
Năm 2017, AlphaGo Zero bỏ luôn các ván của con người. Nó chỉ biết luật, bắt đầu từ các nước ngẫu nhiên, tự đấu với mình, rồi thắng bản đã đánh bại Lee Sedol với tỉ số 100–0[3]. Mọi thứ nó biết về cờ vây đều đến từ việc thống kê kết quả của những ván tự đấu.
Hãy giữ lại một điểm: AlphaGo có một trọng tài tuyệt đối. Ván cờ kết thúc thì biết ngay thắng hay thua, nên mọi sai lầm đều bị bàn cờ phạt. Điều này sẽ quan trọng ở phần sau.
LLM học gì?
LLM (large language model, mô hình ngôn ngữ lớn) là loại mô hình đứng sau ChatGPT, Claude hay Gemini. Việc cốt lõi của nó nghe rất khiêm tốn: đọc một đoạn chữ và đoán từ tiếp theo. Nó giống trò điền vào chỗ trống: “Hà Nội là thủ đô của …”. Lặp lại từ này sang từ khác, nó viết thành câu, thành bài.
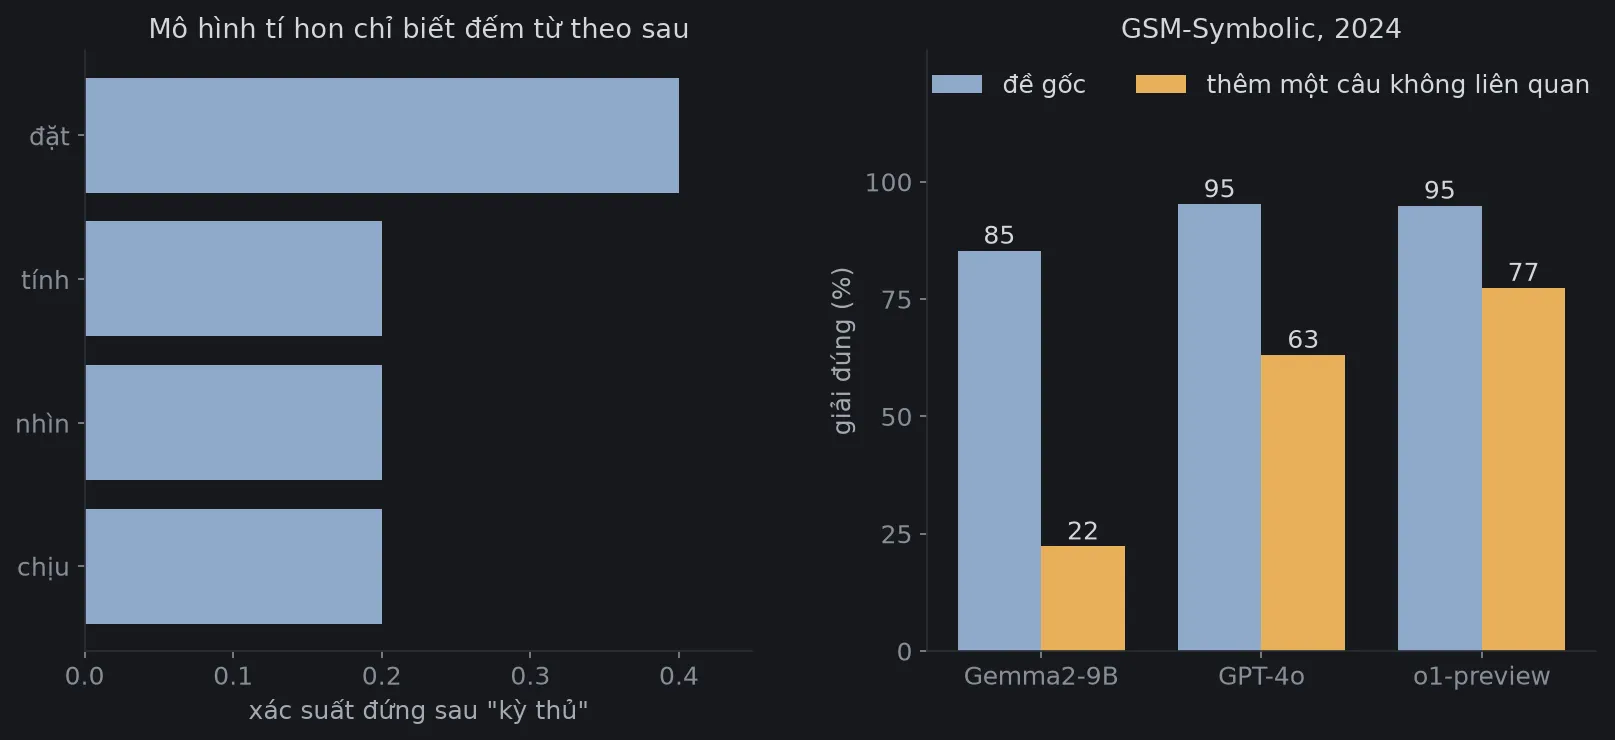
Để đoán tốt, mô hình chỉnh hàng tỉ tham số qua một lượng văn bản khổng lồ. Mỗi từ thành một mũi tên trong không gian nhiều chiều, kiểu mà bài cosine similarity đã kể, và mô hình học được mối liên hệ giữa các mũi tên trong cả đoạn văn dài. Bên trái Hình 1 là bản thu nhỏ đến mức thô sơ mà mình tự chạy: một mô hình chỉ đếm từ nào hay đứng sau từ nào. LLM thật khác xa về quy mô và cách học, nhưng cùng chung một mục tiêu: đoán tiếp.
Mô hình tí hon của mình đọc mười câu về cờ vây rồi viết ra: “kỳ thủ đặt quân trắng bao vây quân trắng lên bàn cờ”. Câu đó đúng nhịp tiếng Việt nhưng hơi vô nghĩa, và mô hình không có cách nào biết điều ấy. Năm 2021, Emily Bender và cộng sự gọi LLM là những “con vẹt ngẫu nhiên”: ghép các mẫu chữ đã thấy theo xác suất, không gắn với ý nghĩa[10].
Bàn cờ có trọng tài, câu chữ thì không
AlphaGo thua là biết thua. LLM không có trọng tài như thế. Khi huấn luyện, nó được chấm xem từ vừa đoán có khớp với văn bản gốc không, tức khớp với điều con người từng viết, không phải với sự thật. Một câu sai mà viết trơn tru vẫn là một câu rất dễ đoán. Giống học sinh học văn mẫu: bài được điểm cao vì giống mẫu, không phải vì em đã tự kiểm chứng từng ý.
Điều này giải thích một hiện tượng ai dùng chatbot cũng gặp: mô hình có thể nói sai bằng giọng rất chắc chắn. Trên bàn cờ, một nước tự tin nhưng sai sẽ bị phạt ngay. Trong câu chữ, không có gì phạt nó cả.
Vì thế, các phòng nghiên cứu đang tìm cách đưa phần “tính trước” của AlphaGo vào LLM. Các mô hình suy luận viết ra những bước trung gian rồi mới chốt câu trả lời, giống người nháp ra giấy trước khi nộp bài. Theo Google, Gemini Deep Think đồng thời khám phá và kết hợp nhiều lời giải khả dĩ, không đi theo một chuỗi suy nghĩ thẳng, và được huấn luyện thêm bằng học tăng cường với dữ liệu chứng minh định lý[9].
Năm 2025, mô hình ấy đạt mức huy chương vàng Olympic Toán quốc tế: giải 5 trong 6 bài, được 35 trên 42 điểm do ban tổ chức chấm, viết bằng ngôn ngữ tự nhiên trong giới hạn 4,5 giờ[9]. Khó gọi đó chỉ là chép lại. “Con vẹt” chưa phải toàn bộ câu chuyện.
Theo mình, không phải tình cờ mà một trong những thành tựu rõ nhất của LLM lại nằm ở toán. Một chứng minh đúng hay sai có thể kiểm tra được, nên toán gần với bàn cờ hơn mọi lĩnh vực khác của ngôn ngữ. Hỏi về một chi tiết lịch sử ít người biết thì không có bàn cờ nào đứng đó để phạt câu trả lời sai. Vậy muốn biết AI hiểu tới đâu, ta không thể chỉ nhìn vào lúc nó thắng. Ta cần những phép thử đặt nó ra khỏi vùng quen thuộc.
Phép thử 1: AI có sáng tạo không?
Trở lại nước 37. David Silver, trưởng nhóm nghiên cứu, kể rằng AlphaGo tự tính xác suất một con người đánh nước ấy chỉ khoảng 1 trên 10.000. Nó vẫn chọn, vì những gì nó học qua tự đấu và tính trước cho thấy đó là nước tốt[1]. Nói cách khác, mạng bắt chước con người bảo “không ai đánh thế”, còn phần còn lại bảo “cứ đánh”.
Fan Hui, nhà vô địch châu Âu từng thua AlphaGo, lúc đầu không tin, rồi nhìn lại và liên tục nói: “Đẹp quá. Đẹp quá”[1]. Michael Redmond gọi nước đi là sáng tạo và độc đáo[4]. Những năm sau, chính cờ vây đổi theo: Lee Sedol kể rằng AI đã lật đổ những quan niệm tồn tại hàng thế kỷ, như việc xâm nhập góc từ sớm, và kỳ thủ giờ dùng chúng thường xuyên[5].
Kết quả phép thử: đạt, theo nghĩa hẹp. Nước 37 không chép từ ván nào, và nó có ích. Nhưng “mới” chưa đồng nghĩa với “hiểu”. Chọn lọc tự nhiên cũng tạo ra những thiết kế mới mà không suy nghĩ gì. Muốn biết AlphaGo có tấm bản đồ hay không, phải cấm một con đường.
Phép thử 2: AI có hiểu khái niệm không?
Ván 4, 13 tháng 3 năm 2016. Lee Sedol đã thua cả trận, đang ở thế khó. Ông suy nghĩ khoảng 30 phút rồi đặt nước 78, một nước chen vào giữa bàn cờ. Hassabis kể AlphaGo không lường trước vì nó tính con người chỉ có khoảng 1 phần 10.000 khả năng đánh nước đó[1]. Một bài báo khác ghi con số 0,007%, nên hãy coi đây là mức độ, không phải số chính xác[5]. Nước đáp của AlphaGo rất tệ, và từ nước 87 nó đánh một loạt nước kém rõ rệt rồi chịu thua[4]. Kỳ thủ Gu Li gọi nước 78 là “nước đi của thần”[4].
Năm 2025, trong hồi ký, Lee Sedol kể lại khác với huyền thoại. Ông nói nước quyết định là nước 68, nước mà ông sẽ không đánh trước một con người, và “mọi nước từ 68 đến 78 đều là mẹo”[5]. Ông không tìm ra chân lý cờ vây. Ông tìm ra chỗ AlphaGo không nhìn thấy. Có thể nói ông đã cấm một con đường.
Bảy năm sau, câu chuyện lặp lại rõ hơn nhiều. Năm 2023, Tony Wang, Adam Gleave và cộng sự huấn luyện một AI chuyên đi tấn công KataGo, chương trình cờ vây mạnh mà ai cũng dùng được. Kẻ tấn công thắng hơn 97% ván trước KataGo ở mức siêu phàm[6]. Điều lạ là nó không đánh cờ giỏi. Nó dụ KataGo vào một thế bao vây vòng tròn: một nhóm quân bị vây trong khi tưởng là an toàn. KataGo không phòng thủ, như thể không nhận ra nhóm quân của mình đang gặp nguy.
Chi tiết sau mới đáng suy ngẫm. Kẻ tấn công này thua cả người chơi nghiệp dư. Người nghiệp dư thắng kẻ tấn công, kẻ tấn công thắng KataGo, KataGo thắng kỳ thủ chuyên nghiệp, như một vòng oẳn tù tì. Và khi các chuyên gia con người hiểu được mẹo vòng tròn, họ tự dùng nó, không cần máy trợ giúp, để liên tục thắng các AI siêu phàm[6]. Con người học được ý tưởng rồi mang đi dùng, còn KataGo dù được huấn luyện phòng thủ vẫn tiếp tục bị khai thác bằng biến thể mới[6].
Kết quả phép thử: chưa đạt, ít nhất với thế hệ AI cờ vây này. Một kỳ thủ mới học biết rằng nhóm quân bị vây kín là nguy hiểm, dù thế cờ có hình gì. Một chương trình mạnh hơn kỳ thủ chuyên nghiệp lại có thể không nắm được điều ấy ở một hình dạng lạ. Đây là người thuộc lòng một triệu tuyến đường, vẫn kẹt ở một đường cấm.
Phép thử 3: AI có biết mình đang làm gì không?
Hỏi một LLM “36 + 59 bằng bao nhiêu?”, nó trả lời 95. Hỏi nó làm thế nào, nó sẽ kể cách cộng cột dọc quen thuộc: 6 cộng 9 bằng 15, viết 5 nhớ 1.
Năm 2025, các nhà nghiên cứu ở Anthropic soi vào bên trong mô hình Claude khi làm phép tính này, và thấy chuyện khác. Mô hình dùng nhiều đường tính song song: một đường ước lượng độ lớn của đáp số, một đường xác định chữ số cuối, rồi hai đường gộp lại. Nó không làm như lời nó kể, và theo nghiên cứu, nó dường như không biết tới cách tính thật của mình[7]. Cũng nghiên cứu ấy cho thấy mô hình đôi khi nêu những bước tính nghe hợp lý mà không hề thực hiện[7].
Giống một người giỏi tính nhẩm được hỏi bí quyết, rồi đọc lại đúng quy tắc trong sách, trong khi đầu họ vận hành khác. Công bằng mà nói, con người cũng không luôn biết mình nghĩ thế nào: bạn nhận ra mặt bạn thân tức thì, nhưng khó giải thích từng bước. Lời giải thích của ta cũng nhiều khi được dựng lên sau đó.
Kết quả phép thử: chưa đạt, và con người cũng không đạt trọn vẹn. Khác biệt nằm ở chỗ lời giải thích của LLM trôi chảy tới mức dễ khiến ta tin. Khi AI “trình bày suy nghĩ”, đó có thể là suy nghĩ thật, cũng có thể chỉ là một văn bản nghe giống suy nghĩ.
Phép thử 4: đổi nhẹ đề bài
Đây là phép thử trực tiếp nhất với tiêu chí tấm bản đồ. Tháng 10 năm 2024, một nhóm nghiên cứu ở Apple tạo bộ đề GSM-Symbolic từ các bài toán phổ thông, rồi đổi tên, đổi số, hoặc thêm một câu nghe liên quan mà không ảnh hưởng tới đáp số[8]. Đây là đề được họ nêu làm ví dụ, tạm dịch:
Oliver hái 44 quả kiwi hôm thứ Sáu, 58 quả hôm thứ Bảy. Chủ nhật, anh hái gấp đôi hôm thứ Sáu, nhưng có 5 quả nhỏ hơn bình thường một chút. Oliver có bao nhiêu quả kiwi?
Kích thước quả không làm số quả thay đổi, nên đáp số là . Nhiều mô hình lại trừ đi 5 và ra 185. Một học sinh có thể cũng bị vấp, nhưng sẽ không vì thế mà sụt nửa số điểm trong cả bài kiểm tra.
Bên phải Hình 1 là con số: chỉ thêm những câu thừa như thế, GPT-4o từ 95% giải đúng xuống 63%, mô hình mở Gemma2-9B từ 85% xuống 22%, còn o1-preview, loại mô hình suy luận từng bước, từ 95% xuống 77%[8]. Tác giả kết luận rằng cách suy luận của các mô hình này mong manh, có lẽ gần với khớp mẫu tinh vi hơn là suy luận logic thật[8].
Hãy đọc cột thứ ba của biểu đồ và mốc năm 2025 ở trên cùng lúc. o1-preview sụt ít hơn hẳn, và chỉ một năm sau đã có mô hình đạt mức huy chương vàng toán. Con số năm 2024 là ảnh chụp một thời điểm, không phải giới hạn vĩnh viễn. Nhưng nghiên cứu ấy vẫn cho thấy một kiểu lỗi mà ta nên tự kiểm tra với mô hình đang dùng.
Kết quả phép thử: đạt một phần, và đang cải thiện.
Bốn phép thử nói gì?
| Phép thử | Bằng chứng | Kết quả |
|---|---|---|
| Sáng tạo | Nước 37, các chiến lược cờ mới | Đạt theo nghĩa hẹp |
| Hiểu khái niệm | Nước 78, mẹo vòng tròn với KataGo | Chưa đạt |
| Biết mình đang làm gì | Phép cộng 36 + 59 | Chưa đạt, con người cũng không trọn vẹn |
| Đổi nhẹ đề bài | GSM-Symbolic, Olympic Toán 2025 | Đạt một phần, đang cải thiện |
Bảng này cho thấy chữ “thống kê” và chữ “suy nghĩ” không loại trừ nhau. Não người cũng là những tế bào truyền tín hiệu, không ai đọc được ý nghĩa từ một neuron, nên việc AI được tạo từ phép nhân ma trận chưa đủ để kết luận nó không nghĩ. Ngược lại, việc AI nói trôi chảy cũng chưa đủ để kết luận nó hiểu.
Điều phân biệt rõ nhất là hình dạng của năng lực. Năng lực con người tương đối liền mạch: giỏi ở một mức thường kéo theo việc không sai ở mức dễ hơn. Năng lực AI hiện nay lởm chởm: có thể vượt người giỏi nhất thế giới, rồi hỏng ở một chỗ mà trẻ em không hỏng. Chính sự lởm chởm ấy là bằng chứng rằng bên trong nó không vận hành như ta, dù bề ngoài có thể cho cùng đáp án.
Vì sao con người vẫn phải giám sát AI?
Bốn phép thử dẫn tới một kết luận rất thực tế: với AI hiện nay, con người vẫn cần ngồi ở ghế trọng tài, vì ba lý do.
AI chưa biết chắc khi nào mình sai. Trên bàn cờ, luật chơi tự chấm điểm. Trong báo cáo, hợp đồng hay chẩn đoán, không có bàn cờ nào như thế. Phép thử 3 cho thấy lời giải thích trôi chảy của mô hình không bảo đảm bước tính ấy có thật, nên phải có người đối chiếu với thực tế.
Lỗi của AI nằm ở chỗ khó đoán. Một nhân viên mới thường sai ở việc khó. AI có thể làm xong việc khó rồi vấp ở việc dễ, như KataGo trước mẹo vòng tròn. Chính con người đã hiểu được điểm mù ấy và học cách khai thác nó[6].
Trách nhiệm vẫn thuộc về con người. Năm 2022, sau khi bà của một hành khách qua đời, chatbot của Air Canada trả lời sai về chính sách vé tang lễ. Ra tòa, hãng lập luận rằng không phải chịu trách nhiệm về thông tin do chatbot đưa ra. Năm 2024, tòa giải quyết tranh chấp ở British Columbia bác lập luận ấy và buộc hãng bồi thường[12]. Máy có thể soạn câu trả lời, nhưng người hoặc tổ chức dùng nó phải đứng tên chịu trách nhiệm.
Điều này không có nghĩa AI vô dụng, cũng không chứng minh được rằng AI sẽ mãi không thay được con người. Tương lai thì chưa ai đo được. Nó chỉ nói rằng trong khi năng lực của AI còn lởm chởm, việc giao hoàn toàn cho máy ở những chỗ có hậu quả là một quyết định rủi ro. Lee Sedol, người từng ngồi đối diện máy, cũng đi tới kết luận gần như vậy: con người cần làm việc cùng AI để tạo ra điều mới[5]. Giám sát ở đây phải là kiểm tra thật, không phải chỉ lướt qua rồi bấm đồng ý.
Ba cách hiểu sai về AI
“Chỉ là thống kê thì không có gì đáng kể.” Thống kê đủ lớn đã tạo ra nước 37 và những lời giải toán Olympic. Nhãn “thống kê” nói về cách làm, không nói về giới hạn của kết quả. Đánh giá thấp AI chính là sai lầm mà Lee Sedol nhắc tới trong hồi ký: người ta đang lặp lại việc ông từng làm, không lường được tốc độ tiến bộ của AI[5].
“Nói lưu loát nghĩa là hiểu.” Ngôn ngữ là tín hiệu ta quen dùng để đánh giá người khác. Một người nói mạch lạc thường là người hiểu. Với LLM, phép suy luận ấy không còn an toàn, như phép thử 3 đã cho thấy. Bài phép thử Turing kể ta đã từng bị lừa từ năm 1966 bởi một chương trình rất đơn giản.
“Giỏi việc này thì giỏi mọi việc.” KataGo mạnh hơn kỳ thủ chuyên nghiệp nhưng thua một mẹo mà chuyên gia học được. Một mô hình giải toán Olympic vẫn có thể bịa một trích dẫn. Giỏi ở bài kiểm tra chưa nói được nó đáng tin ở việc của bạn. Ta không giao xe cho người chỉ thuộc đường mà chưa từng gặp đường cấm.
Tự tay dựng một mô hình đoán từ
Đoạn Python dưới đây dựng mô hình tí hon ở trên: đọc mười câu, đếm từ nào đứng sau từ nào, rồi viết tiếp bằng cách rút ngẫu nhiên theo xác suất. Nó cũng đưa số liệu của GSM-Symbolic vào biểu đồ và vẽ Hình 1. Seed cố định là 42. Cần numpy và matplotlib. Đây là minh họa ý tưởng đoán từ, không phải cách một LLM thật được xây dựng.
from collections import Counter, defaultdict
import matplotlib.pyplot as pltimport numpy as np
plt.rcParams.update({"figure.facecolor": "#16181c", "axes.facecolor": "#16181c", "text.color": "#d4d7dc",                     "axes.edgecolor": "#2a2e35", "axes.labelcolor": "#a4a9b2",                     "xtick.color": "#878d97", "ytick.color": "#878d97", "font.size": 12})rng = np.random.default_rng(42)
# Phần 1: một mô hình ngôn ngữ tí hon, chỉ đếm xem từ nào hay đứng sau từ nàoVAN_BAN = """kỳ thủ đặt quân đen lên bàn cờ .kỳ thủ đặt quân trắng lên bàn cờ .máy đặt quân trắng lên bàn cờ .máy tính nước đi rất nhanh .kỳ thủ tính nước đi rất lâu .quân đen bao vây quân trắng .quân trắng bao vây quân đen .kỳ thủ nhìn bàn cờ rất lâu .máy nhìn bàn cờ rất nhanh .ván cờ kết thúc khi kỳ thủ chịu thua .""".split()
dem = defaultdict(Counter)for tu, tu_sau in zip(VAN_BAN, VAN_BAN[1:]):    dem[tu][tu_sau] += 1

def doan(tu):    """Xác suất của từng từ có thể đứng sau `tu`, chỉ dựa vào số lần đếm được."""    tong = sum(dem[tu].values())    return {t: c / tong for t, c in dem[tu].most_common()}

def viet_tiep(tu, so_tu=12):    """Sinh câu: mỗi bước rút ngẫu nhiên một từ theo xác suất. Không có khái niệm đúng sai."""    cau = [tu]    while len(cau) < so_tu and cau[-1] != "." and dem[cau[-1]]:        kha_nang = doan(cau[-1])        cau.append(rng.choice(list(kha_nang), p=list(kha_nang.values())))    return " ".join(cau)

print("sau 'thủ':", {t: round(p, 2) for t, p in doan("thủ").items()})for _ in range(4):    print("máy viết:", viet_tiep("kỳ"))print("sau 'mèo':", doan("mèo") if dem["mèo"] else "chưa từng gặp, không có gì để đoán")
# Phần 2: độ chính xác (%) trong nghiên cứu GSM-Symbolic, trước và sau khi thêm một câu không liên quanGSM = {"Gemma2-9B": (85.3, 22.3), "GPT-4o": (95.2, 63.1), "o1-preview": (94.9, 77.4)}for ten, (goc, them_cau) in GSM.items():    print(f"{ten}: {goc}% xuống {them_cau}%, giảm {goc - them_cau:.1f} điểm phần trăm")
# Vẽfig, (ax, ax2) = plt.subplots(1, 2, figsize=(13, 5.2), gridspec_kw={"wspace": 0.26})kha_nang = doan("thủ")ax.barh(list(kha_nang)[::-1], list(kha_nang.values())[::-1], color="#8fa9c9")ax.set_xlabel("xác suất đứng sau \"kỳ thủ\"")ax.set_title("Mô hình tí hon chỉ biết đếm từ theo sau", color="#d4d7dc", fontsize=13)ax.set_xlim(0, 0.45)vi_tri = np.arange(len(GSM))ax2.bar(vi_tri - 0.19, [v[0] for v in GSM.values()], 0.38, color="#8fa9c9", label="đề gốc")ax2.bar(vi_tri + 0.19, [v[1] for v in GSM.values()], 0.38, color="#e8b05a", label="thêm một câu không liên quan")for x, (a, b) in zip(vi_tri, GSM.values()):    ax2.text(x - 0.19, a + 1.5, f"{a:.0f}", ha="center", color="#d4d7dc")    ax2.text(x + 0.19, b + 1.5, f"{b:.0f}", ha="center", color="#d4d7dc")ax2.set_xticks(vi_tri, list(GSM))ax2.set_ylim(0, 128)ax2.set_yticks(range(0, 101, 25))ax2.set_ylabel("giải đúng (%)")ax2.set_title("GSM-Symbolic, 2024", color="#d4d7dc", fontsize=13)ax2.legend(frameon=False, loc="upper center", ncol=2)for a_ in (ax, ax2):    for sp in ("top", "right"):        a_.spines[sp].set_visible(False)fig.savefig("doan-tu-tiep-theo.png", dpi=150, bbox_inches="tight")
Kết quả in ra:
sau 'thủ': {'đặt': 0.4, 'tính': 0.2, 'nhìn': 0.2, 'chịu': 0.2}máy viết: kỳ thủ tính nước đi rất lâu .máy viết: kỳ thủ đặt quân trắng bao vây quân trắng lên bàn cờmáy viết: kỳ thủ nhìn bàn cờ kết thúc khi kỳ thủ đặt quânmáy viết: kỳ thủ nhìn bàn cờ .sau 'mèo': chưa từng gặp, không có gì để đoánGemma2-9B: 85.3% xuống 22.3%, giảm 63.0 điểm phần trămGPT-4o: 95.2% xuống 63.1%, giảm 32.1 điểm phần trămo1-preview: 94.9% xuống 77.4%, giảm 17.5 điểm phần trămDòng cuối phần đoán từ là chỗ đáng xem nhất. Gặp chữ “mèo”, mô hình này không có gì để nói, vì nó chỉ có các con đường đã đi qua. LLM thật đã vượt xa giới hạn ấy nhờ biểu diễn từ bằng mũi tên, nên nó tổng quát hóa được sang câu chưa từng thấy. Câu hỏi của bài này chính là: nó tổng quát hóa được tới đâu.
Quay lại với Lee Sedol
Tháng 11 năm 2019, Lee Sedol giải nghệ, nói rằng ngay cả khi đứng số một, vẫn “có một thực thể không thể đánh bại”[11]. Đây là điều ông nói trước công chúng, và không nên đọc thành nguyên nhân duy nhất của cả một sự nghiệp. Trong hồi ký, ông nói ván thua khiến ông day dứt nhất là ván 5, vì ông thấy không thoải mái khi đã thắng ván 4 bằng mẹo[5].
Một cỗ máy không day dứt như thế, hoặc ít nhất chưa ai đo được điều đó. AI có thể tìm ra nước 37. Nó chưa cho thấy biết mình vừa làm gì. Phần còn lại của câu hỏi có lẽ không nằm trong bàn cờ: nếu một ngày AI vượt qua cả bốn phép thử này, ta sẽ phải quyết định chữ “suy nghĩ” nghĩa là gì, thay vì chờ máy trả lời hộ.
Vẽ minh họa hình học miễn phí cho học sinh và giáo viên: EyeViz.
Tài liệu tham khảo
- [1]Cade Metz. In Two Moves, AlphaGo and Lee Sedol Redefined the Future. WIRED, 2016.
- [2]D. Silver và cộng sự. Mastering the game of Go with deep neural networks and tree search. Nature 529, 484–489, 2016.
- [3]D. Silver và cộng sự. Mastering the game of Go without human knowledge. Nature 550, 354–359, 2017.
- [4]AlphaGo versus Lee Sedol. Wikipedia.
- [5]Grandmaster Lee Se-dol reveals how he beat AlphaGo: 'Every move was a trick'. Korea JoongAng Daily, 2025.
- [6]T. T. Wang, A. Gleave và cộng sự. Adversarial Policies Beat Superhuman Go AIs. ICML 2023, 2023.
- [7]Tracing the thoughts of a large language model. Anthropic, 2025.
- [8]S. Mirzadeh và cộng sự. GSM-Symbolic: Understanding the Limitations of Mathematical Reasoning in Large Language Models. arXiv, 2024.
- [9]Advanced version of Gemini with Deep Think officially achieves gold-medal standard at the International Mathematical Olympiad. Google DeepMind, 2025.
- [10]E. M. Bender, T. Gebru, A. McMillan-Major, M. Mitchell. On the Dangers of Stochastic Parrots: Can Language Models Be Too Big?. FAccT 2021, 2021.
- [11]South Korean Go master retires, says AI cannot be defeated. Global News, 2019.
- [12]Moffatt v. Air Canada, 2024 BCCRT 149. Civil Resolution Tribunal, British Columbia, 2024.