Cosine similarity là gì? Vì sao AI đo góc, không đo xa
Cosine similarity là gì? Từ ly cà phê sữa tới thí nghiệm trên 47 bài blog: vì sao AI so văn bản bằng góc giữa hai mũi tên, và khi nào cách đo này hỏng.
Mục lục
Bài nào giống con mèo Schrödinger nhất?
Mình cho máy tính đọc 47 bài trên blog này rồi hỏi một câu đơn giản: bài nào giống bài Con mèo Schrödinger nhất? Nếu đo khoảng cách thông thường giữa hai bài, máy trả lời: bài về tìm kiếm bằng hình ảnh. Bài ấy nói về đôi giày và điểm ảnh, gần như không dính gì tới mèo hay lượng tử.
Đổi sang cosine similarity (độ tương đồng cosin), cùng dữ liệu, máy trả lời: bài về máy tính lượng tử. Cosine similarity là thước đo xem hai mũi tên chỉ về cùng hướng tới đâu, không quan tâm mũi tên nào dài hơn. AI biến văn bản, ảnh, bài hát thành những mũi tên như thế. Cùng hướng nghĩa là cùng nội dung, còn độ dài phần nhiều chỉ nói thứ ấy to hay nhỏ.
Bài này giải thích vì sao đo góc lại thắng đo khoảng cách, bắt đầu từ một ly cà phê. Sau đó ta xem thí nghiệm trên chính blog này, xem người đã biến văn bản thành mũi tên từ những năm 1960, và xem những lúc cosine cho kết quả sai.
Ly cà phê sữa: vì sao không đo khoảng cách?
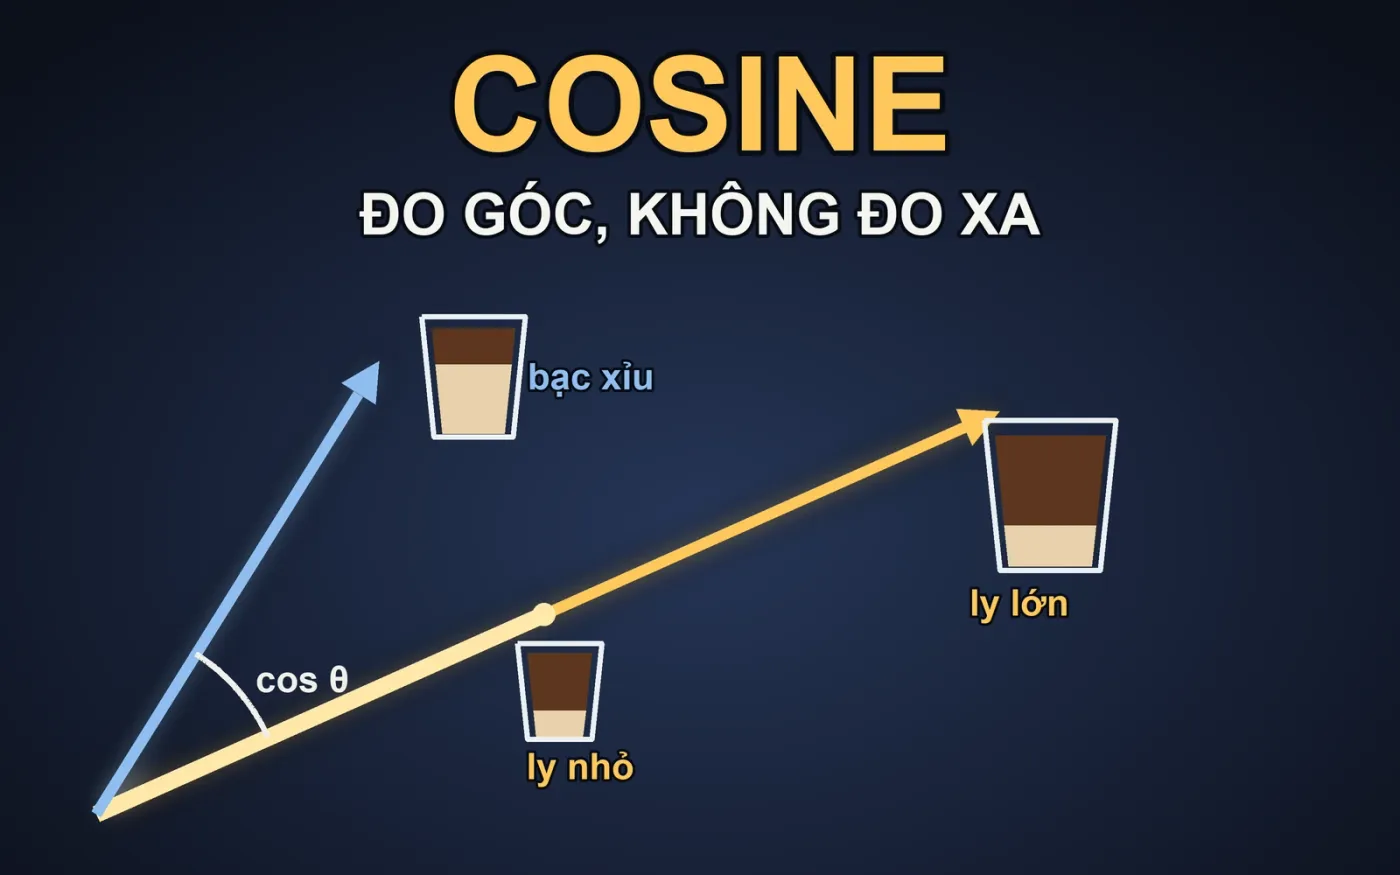
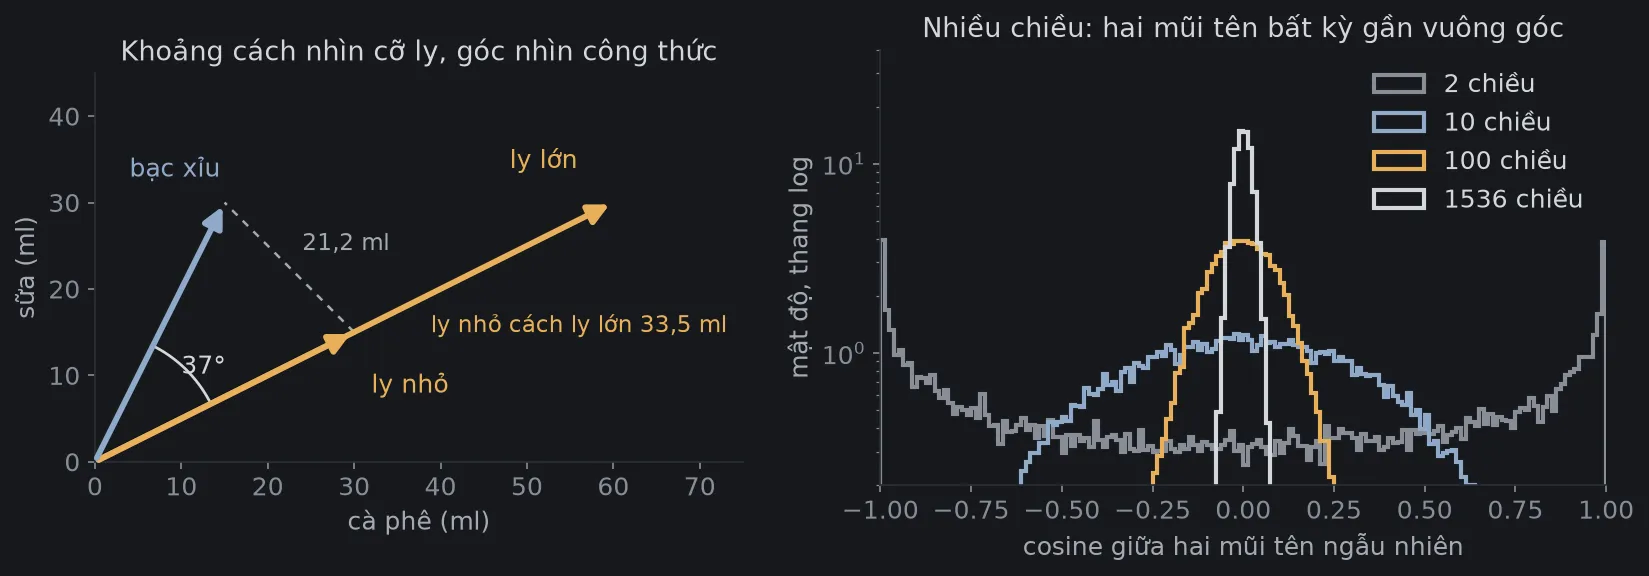
Quán có ba ly đồ uống. Ly cà phê sữa nhỏ có 30 ml cà phê và 15 ml sữa. Ly cà phê sữa lớn pha đúng công thức ấy nhưng gấp đôi: 60 ml và 30 ml. Ly bạc xỉu nhiều sữa hơn hẳn: 15 ml cà phê và 30 ml sữa.
Ghi mỗi ly thành hai con số, ta có thể vẽ nó thành một mũi tên trên giấy: trục ngang là cà phê, trục dọc là sữa. Danh sách số như vậy gọi là một vector, hiểu đơn giản là một công thức pha chế viết bằng số.
Giờ hỏi: ly nào vị giống ly cà phê sữa nhỏ nhất? Ai uống cũng trả lời là ly lớn, vì nó chỉ khác cỡ. Nhưng khoảng cách Euclid, tức độ dài đoạn thẳng nối hai đầu mũi tên, lại nói khác:
| So với ly nhỏ | Khoảng cách | Góc | Cosine similarity |
|---|---|---|---|
| Cà phê sữa ly lớn | 33,5 ml | 0° | 1,00 |
| Bạc xỉu | 21,2 ml | 37° | 0,80 |
Khoảng cách cho rằng bạc xỉu giống hơn, vì nó trộn lẫn hai câu hỏi: pha thế nào và bao nhiêu. Góc thì chỉ trả lời câu thứ nhất. Hai ly cùng công thức nằm trên cùng một hướng dù to nhỏ khác nhau, như bên trái Hình 1.
Văn bản cũng thế. Một bài dài và một bài ngắn cùng chủ đề giống ly lớn và ly nhỏ: cùng công thức, khác cỡ. Muốn so nội dung, ta cần thước đo không bị cỡ ly đánh lừa.
Cosine similarity là gì?
Tên gọi nói đúng việc nó làm: lấy cosin của góc giữa hai mũi tên. Không cần đo góc bằng thước đo độ. Chỉ cần nhân tương ứng các con số rồi chia cho độ dài[9]:
Tử số gọi là tích vô hướng. Hãy nghĩ nó như điểm hợp gu của hai người: món cả hai cùng thích nhiều thì cộng nhiều điểm, món chỉ một người thích thì gần như không cộng gì. Mẫu số chia bớt phần “to” của từng mũi tên, giống quy đổi mọi ly về cùng một cỡ trước khi nếm.
Tính thử ly nhỏ với bạc xỉu. Tích vô hướng là . Hai độ dài đều là . Vậy cosine là , đúng góc khoảng 37°.
Kết quả luôn nằm giữa −1 và 1:
- 1: cùng hướng, cùng công thức.
- 0: vuông góc, hai thứ không có gì chung. Bài về phở và bài về máy bay, nếu không dùng chung từ nào, nhận đúng số 0.
- −1: ngược hướng hẳn. Với số đếm chữ thì không xảy ra vì không có số âm, nhưng embedding của AI thì có thể ra số âm.
Vì sao không bao giờ vượt quá 1, kể cả với hàng nghìn con số? Đó chính là bất đẳng thức Cauchy–Schwarz, mà bài bất đẳng thức Cauchy đã nhắc tới. Một công thức hồi cấp ba lặng lẽ bảo đảm rằng chữ “góc” vẫn có nghĩa trong không gian không ai vẽ được. Nếu trừ mỗi dãy số đi trung bình của nó rồi mới tính cosine, ta thu được hệ số tương quan Pearson, con số trong bài hồi quy về trung bình.
Người biến văn bản thành mũi tên
Ý tưởng dùng phép đo này cho chữ gắn với Gerard Salton. Ông sinh năm 1927 ở Nuremberg với tên Gerhard Anton Sahlmann. Chiến tranh buộc gia đình chạy khỏi Đức, và hai anh em được dẫn qua biên giới vào ban đêm để tránh lính gác[2]. Salton sang Mỹ năm 1947, học toán, rồi là nghiên cứu sinh cuối cùng của Howard Aiken ở Harvard[2][3].
Đầu thập niên 1960, Salton thiết kế SMART, một hệ thống tìm kiếm văn bản mà suốt khoảng 30 năm là nơi thử nghiệm các phương pháp tìm kiếm[3]. Thời đó, tìm kiếm thường là logic đúng sai: tài liệu khớp từ khóa thì lấy, không khớp thì bỏ, giống người gác cổng chỉ biết nói có hoặc không.
Nhóm của Salton nghĩ khác: mỗi từ trong ngôn ngữ là một trục, mỗi tài liệu là một mũi tên, câu hỏi cũng là một mũi tên. Tìm kiếm trở thành việc xếp hạng theo độ tương đồng giữa các mũi tên, với cosin là thước đo tiêu biểu, không còn là trả lời có hoặc không[1][3][9]. Bài báo năm 1975 của Salton, Wong và Yang trình bày cách nhìn này với tên mô hình không gian vector. Bản tưởng niệm ở Cornell có câu: “Salton là ngành truy xuất thông tin”[2]. Ông qua đời năm 1995.
TF-IDF: vì sao chữ “là” không được bỏ phiếu
Đếm chữ thô có một vấn đề: bài nào cũng đầy những từ “là”, “của”, “và”. Hai bài có thể giống nhau chỉ vì cùng dùng tiếng Việt.
Năm 1972, Karen Spärck Jones đề xuất một ý rất gọn: từ xuất hiện trong càng ít tài liệu thì càng đáng chú ý[4]. Giống tìm người trong đám đông: “mặc áo” chẳng giúp gì, “đội mũ cối màu đỏ” thì tìm ra ngay. Kết hợp số lần từ xuất hiện trong bài (TF) với độ hiếm của từ (IDF), ta có TF-IDF, một công thức đã được dùng rộng rãi nhiều thập kỷ. Từ phổ biến gần như mất tiếng, từ đặc trưng như “lượng tử” hay “Galois” được nói to hơn.
Thí nghiệm trên 47 bài blog
Giờ quay lại câu hỏi đầu bài. Mình lấy 47 bài tiếng Việt trên blog tại thời điểm viết, chưa tính bài này, bỏ code và công thức. Mỗi cụm hai tiếng liên tiếp là một trục, vì tiếng Việt nhiều từ gồm hai tiếng. Kết quả là những mũi tên trong không gian 63.800 chiều, tính theo TF-IDF.
| Bài gốc | Gần nhất theo cosine | Gần nhất theo khoảng cách Euclid |
|---|---|---|
| Con mèo Schrödinger | Máy tính lượng tử (0,105) | Tìm kiếm bằng hình ảnh |
| Galois | Abel và lá thư đến muộn hai ngày (0,160) | Consistent hashing |
| Bài toán gà và chó | Tính toán bằng ánh sáng (0,063) | Tìm kiếm bằng hình ảnh |
Cột cosine chưa hoàn hảo, nhưng có lý: Galois và Abel là hai bài cùng kể về phương trình bậc năm, còn bài gà chó và bài tính toán bằng ánh sáng cùng nói nhiều về ma trận. Cột Euclid thì gần như cố định. Tính cả kho bài, ba bài tìm kiếm hình ảnh, chip 3nm và consistent hashing xuất hiện trong top 5 của 46 trên 46 bài còn lại. Có 97% lựa chọn top 5 của Euclid rơi vào 10 bài ngắn nhất kho; với cosine, con số này là 15%.
Lý do giống hệt ly cà phê. Bài ngắn có mũi tên ngắn, nằm gần gốc tọa độ, nên “gần” mọi thứ. Bài dài có mũi tên dài, nên “xa” mọi thứ. Khoảng cách đang xếp theo cỡ ly, không xếp theo nội dung.
Thử thêm một phép kiểm tra: dán bài Con mèo Schrödinger thành ba lần. Nội dung không đổi, cosine với bản gốc vẫn là 1,00. Khoảng cách Euclid tới bản gốc là 477, trong khi tới bài gần nhất theo Euclid chỉ khoảng 278. Theo khoảng cách, chính bài ấy khác bài ấy nhiều hơn so với một bài về đôi giày.
Từ đếm chữ tới embedding
TF-IDF có một điểm mù lớn: “ô tô” và “xe hơi” là hai trục khác nhau, nên hai câu đồng nghĩa có thể nhận cosine bằng 0.
Năm 2013, nhóm của Tomas Mikolov ở Google công bố word2vec, cách để máy tự học vector cho từng từ từ việc đọc văn bản[5]. Vector kiểu này gọi là embedding. Thay vì một trục cho mỗi từ, mỗi từ thành vài trăm con số, giống một hồ sơ hương vị: độ ngọt, độ đậm, độ béo, chỉ khác là máy tự chọn tiêu chí và tiêu chí không có tên. Từ dùng trong ngữ cảnh giống nhau thì chỉ về hướng gần nhau, nên “ô tô” nằm gần “xe hơi”.
Ví dụ nổi tiếng nhất: lấy vector của “king”, trừ “man”, cộng “woman”, rồi tìm từ có cosine cao nhất, ta được “queen”[6]. Ví dụ này có phần được kể quá đà. Mã tính phép tương tự thường loại chính các từ đầu vào khỏi đáp án, và Nissim cùng cộng sự cho thấy quy tắc ấy có thể làm kết quả trông đẹp hơn thực tế[7].
Hôm nay, embedding có thể biểu diễn cả câu, đoạn văn, hay ảnh. Mô hình text-embedding-3-small của OpenAI biến một đoạn văn thành mũi tên 1.536 chiều[8]. Khi một chatbot trả lời từ tài liệu của công ty, nó biến câu hỏi của bạn thành một mũi tên, rồi tìm những đoạn tài liệu chỉ về hướng gần nhất, như bài tìm kiếm bằng hình ảnh đã kể. Hệ thống gợi ý trong bài YouTube và TikTok cũng so những mũi tên như vậy.
Mẹo khiến nó chạy nhanh: cùng một cỡ ly
Tính căn bậc hai cho hàng tỷ vector là việc tốn công. Nên người ta làm trước một bước: chia mỗi vector cho độ dài của nó, để mọi mũi tên đều dài đúng 1. Ở quán cà phê, đó là quy đổi mọi ly về cùng cỡ ngay từ đầu.
Sau bước chuẩn hóa này, mẫu số bằng 1, cosine chỉ còn là tích vô hướng, một phép nhân rồi cộng mà GPU làm rất nhanh. OpenAI chuẩn hóa sẵn embedding của họ về độ dài 1 và ghi rõ điều này trong tài liệu[8].
Có một hệ quả đáng ngạc nhiên: khi mọi mũi tên đã dài bằng nhau, khoảng cách Euclid và cosine xếp hạng y hệt nhau, vì [8]. Vậy Euclid không hề sai. Thứ làm nó lệch ở thí nghiệm trên là độ dài. Bỏ độ dài đi, hai thước đo trở thành một.
Cosine 0,1 là cao hay thấp?
Ở bảng trên, 0,105 là mức giống nhất với Con mèo Schrödinger. Nghe thấp, nhưng trong kho bài này, cosine trung vị giữa hai bài bất kỳ chỉ khoảng 0,018, nên 0,105 đã gấp gần sáu lần.
Không gian nhiều chiều có tính chất phản trực giác: hai mũi tên ngẫu nhiên gần như luôn vuông góc. Bên phải Hình 1 là mô phỏng của mình. Ở 2 chiều, cosine ngẫu nhiên trải khắp từ −1 tới 1. Ở 1.536 chiều, 95% cặp ngẫu nhiên nằm trong khoảng ±0,05. Giống như có quá nhiều hướng để đi, nên hai người chọn bừa gần như không bao giờ đi cùng đường.
Vì thế không có ngưỡng chung kiểu “trên 0,8 là giống”. Con số phụ thuộc vào cách tạo vector. Với mỗi hệ thống, nên thử trên dữ liệu thật rồi chọn ngưỡng, không chép ngưỡng từ hệ thống khác.
Khi nào cosine similarity hỏng?
Khi độ lớn có ý nghĩa. Một người chấm mọi phim 1 sao và một người chấm mọi phim 5 sao có vector cùng hướng, cosine bằng 1, dù một người chê tất cả, người kia khen tất cả. Khi độ lớn mang thông tin, như số lượng mua hay mức độ quan tâm, tích vô hướng hoặc khoảng cách có thể hợp hơn. Tích vô hướng cũng có thiên vị riêng: trong thí nghiệm trên, nó hay chọn những bài dài.
Khi một từ đảo ngược ý nghĩa. Với cách đếm chữ, “phở quán này ngon” và “phở quán này không ngon” có cosine 0,89, dù hai câu nói ngược nhau. Embedding hiện đại làm tốt hơn đếm chữ, nhưng hai câu chung chủ đề mà trái ý vẫn thường nằm khá gần nhau. Cosine chỉ đo được những gì vector ghi lại.
Khi so vector của hai mô hình khác nhau. Hai mô hình dùng hai bộ trục khác nhau, như công thức pha theo ml và công thức pha theo thìa mà lại trộn lẫn. Đổi mô hình thì phải tính lại toàn bộ vector.
Khi coi điểm cao là sự thật. Cosine cao chỉ nói hai thứ dùng từ hoặc ngữ cảnh giống nhau. Một đoạn tài liệu rất giống câu hỏi vẫn có thể sai hoặc đã lỗi thời.
Tự tay chạy cosine similarity
Đoạn Python dưới đây tính lại bảng ly cà phê, thử hai phép kiểm tra trên câu đánh giá, đo cosine ngẫu nhiên theo số chiều, kiểm tra công thức , và vẽ Hình 1. Seed cố định là 42. Cần numpy và matplotlib. Thí nghiệm 47 bài dùng cùng hàm cosine, chạy trên văn bản của blog, nên không nằm trong đoạn code này.
from collections import Counter
import matplotlib.pyplot as pltimport numpy as np
plt.rcParams.update({"figure.facecolor": "#16181c", "axes.facecolor": "#16181c", "text.color": "#d4d7dc",                     "axes.edgecolor": "#2a2e35", "axes.labelcolor": "#a4a9b2",                     "xtick.color": "#878d97", "ytick.color": "#878d97", "font.size": 12})rng = np.random.default_rng(42)

def cosine(a, b):    """Độ tương đồng cosin: tích vô hướng chia cho tích hai độ dài."""    return a @ b / (np.linalg.norm(a) * np.linalg.norm(b))

# Phần 1: ba ly cà phê, mỗi ly là một mũi tên (ml cà phê, ml sữa)NHO = np.array([30.0, 15.0])    # cà phê sữa ly nhỏLON = np.array([60.0, 30.0])    # cà phê sữa ly lớn, cùng công thứcBAC_XIU = np.array([15.0, 30.0])print(f"ly nhỏ - ly lớn:  khoảng cách {np.linalg.norm(NHO - LON):.1f}, cosine {cosine(NHO, LON):.2f}")print(f"ly nhỏ - bạc xỉu: khoảng cách {np.linalg.norm(NHO - BAC_XIU):.1f}, cosine {cosine(NHO, BAC_XIU):.2f}")print(f"góc ly nhỏ - bạc xỉu: {np.degrees(np.arccos(cosine(NHO, BAC_XIU))):.1f} độ")

# Phần 2: văn bản thành mũi tên bằng cách đếm chữdef dem(*cau):    tu_vung = sorted({t for c in cau for t in c.split()})    return [np.array([Counter(c.split())[t] for t in tu_vung], float) for c in cau]

a, b, c = dem("phở quán này ngon", "phở quán này ngon " * 3, "phở quán này không ngon")print(f"một đánh giá và chính nó lặp ba lần: cosine {cosine(a, b):.2f}, khoảng cách {np.linalg.norm(a - b):.1f}")print(f"'ngon' và 'không ngon':              cosine {cosine(a, c):.2f}")
# Phần 3: hai mũi tên ngẫu nhiên, càng nhiều chiều càng gần vuông gócCAC_CHIEU = [2, 10, 100, 1536]cos_ngau_nhien = {}for d in CAC_CHIEU:    x, y = rng.normal(size=(2, 20_000, d))    x /= np.linalg.norm(x, axis=1, keepdims=True)    y /= np.linalg.norm(y, axis=1, keepdims=True)    cos_ngau_nhien[d] = (x * y).sum(axis=1)    print(f"{d:5d} chiều: 95% cặp có cosine trong khoảng ±{np.quantile(np.abs(cos_ngau_nhien[d]), 0.95):.3f}")
# Sau khi chuẩn hóa, khoảng cách và cosine xếp hạng như nhau: d² = 2 - 2·cosineprint(f"kiểm tra: d² = {np.sum((x[0] - y[0]) ** 2):.4f}, 2 - 2·cosine = {2 - 2 * x[0] @ y[0]:.4f}")
# Vẽfig, (ax, ax2) = plt.subplots(1, 2, figsize=(13, 5.8), gridspec_kw={"wspace": 0.2, "width_ratios": [1, 1.12]})for v, mau, ten, lech in [(NHO, "#e8b05a", "ly nhỏ", (2, -7)), (LON, "#e8b05a", "ly lớn", (-12, 4)),                          (BAC_XIU, "#8fa9c9", "bạc xỉu", (-11, 3))]:    ax.annotate("", xy=v, xytext=(0, 0), arrowprops={"arrowstyle": "-|>", "color": mau, "lw": 2.8, "mutation_scale": 20})    ax.text(v[0] + lech[0], v[1] + lech[1], ten, color=mau, fontsize=12)ax.plot(*zip(NHO, BAC_XIU), color="#a4a9b2", ls=(0, (3, 3)), lw=1.2)ax.text(24, 24.5, "21,2 ml", color="#a4a9b2", fontsize=11)ax.text(56, 15, "ly nhỏ cách ly lớn 33,5 ml", color="#e8b05a", fontsize=11, ha="center")goc = np.radians(np.linspace(26.57, 63.43, 40))ax.plot(15 * np.cos(goc), 15 * np.sin(goc), color="#d4d7dc", lw=1.3)ax.text(10, 10.2, "37°", color="#d4d7dc", fontsize=12)ax.set_xlim(0, 75)ax.set_ylim(0, 45)ax.set_aspect("equal")ax.set_xlabel("cà phê (ml)")ax.set_ylabel("sữa (ml)")ax.set_title("Khoảng cách nhìn cỡ ly, góc nhìn công thức", color="#d4d7dc", fontsize=13)
mau_chieu = ["#878d97", "#8fa9c9", "#e8b05a", "#d4d7dc"]for d, mau in zip(CAC_CHIEU, mau_chieu):    ax2.hist(cos_ngau_nhien[d], bins=np.linspace(-1, 1, 161), density=True, histtype="step", lw=2, color=mau, label=f"{d} chiều")ax2.set_yscale("log")ax2.set_ylim(0.2, 40)ax2.set_xlim(-1, 1)ax2.set_xlabel("cosine giữa hai mũi tên ngẫu nhiên")ax2.set_ylabel("mật độ, thang log")ax2.set_box_aspect(0.6)ax2.set_title("Nhiều chiều: hai mũi tên bất kỳ gần vuông góc", color="#d4d7dc", fontsize=13)ax2.legend(frameon=False)for a_ in (ax, ax2):    for sp in ("top", "right"):        a_.spines[sp].set_visible(False)fig.savefig("cosine-similarity.png", dpi=150, bbox_inches="tight")
Kết quả in ra:
ly nhỏ - ly lớn: khoảng cách 33.5, cosine 1.00ly nhỏ - bạc xỉu: khoảng cách 21.2, cosine 0.80góc ly nhỏ - bạc xỉu: 36.9 độmột đánh giá và chính nó lặp ba lần: cosine 1.00, khoảng cách 4.0'ngon' và 'không ngon': cosine 0.89 2 chiều: 95% cặp có cosine trong khoảng ±0.997 10 chiều: 95% cặp có cosine trong khoảng ±0.598 100 chiều: 95% cặp có cosine trong khoảng ±0.196 1536 chiều: 95% cặp có cosine trong khoảng ±0.050kiểm tra: d² = 2.0650, 2 - 2·cosine = 2.0650Dòng “chính nó lặp ba lần” cho thấy điều mà thí nghiệm 47 bài đã thấy ở quy mô lớn: cosine giữ nguyên ở 1,00, còn khoảng cách đã nhảy lên 4,0 dù nội dung không đổi. Bạn có thể đổi BAC_XIU thành công thức ly bạn hay uống để xem góc thay đổi ra sao.
Quay lại ly cà phê
Gerard Salton không có embedding hay GPU, chỉ có những trục tương ứng với từng từ và một phép chia cho độ dài. Sáu thập kỷ sau, chatbot có hàng nghìn chiều do máy tự học, nhưng câu hỏi cuối cùng vẫn là hai mũi tên có chỉ về cùng hướng hay không.
Phần việc của cosine chỉ là một câu rất ngắn: đừng để cỡ ly đánh lừa khi đang hỏi về công thức. Ở 47 bài blog này, thay đổi ấy đủ để máy nhận ra Con mèo Schrödinger là chuyện lượng tử, không phải chuyện đôi giày.
Vẽ minh họa hình học miễn phí cho học sinh và giáo viên: EyeViz.
Tài liệu tham khảo
- [1]G. Salton, A. Wong, C. S. Yang. A vector space model for automatic indexing. Communications of the ACM 18(11), 613–620, 1975.
- [2]In Memoriam: Gerard Salton. Khoa Khoa học Máy tính, Đại học Cornell, 1996.
- [3]Gerard Salton. IEEE Computer Society, Computer Pioneers.
- [4]Karen Spärck Jones. A statistical interpretation of term specificity and its application in retrieval. Journal of Documentation 28(1), 11–21, 1972.
- [5]T. Mikolov, K. Chen, G. Corrado, J. Dean. Efficient Estimation of Word Representations in Vector Space. arXiv, 2013.
- [6]T. Mikolov, W. Yih, G. Zweig. Linguistic Regularities in Continuous Space Word Representations. NAACL-HLT 2013, 2013.
- [7]M. Nissim, R. van Noord, R. van der Goot. Fair Is Better than Sensational: Man Is to Doctor as Woman Is to Doctor. Computational Linguistics 46(2), 487–497, 2020.
- [8]Vector embeddings. Tài liệu OpenAI API.
- [9]Cosine similarity. Wikipedia.