Tìm kiếm bằng hình ảnh: chụp đôi giày, ra đúng mẫu đó
Tìm kiếm bằng hình ảnh hoạt động thế nào: AI biến ảnh thành dãy số, rồi tìm ảnh "gần nhất" trong hàng tỷ ảnh mà không phải so từng ảnh một.
Mục lục
Bạn thấy một đôi giày đẹp ngoài phố, chụp một tấm, và vài giây sau ứng dụng mua sắm hiện ra đúng mẫu ấy, kèm những đôi na ná. Không ai gõ chữ “giày thể thao trắng đế cao viền xanh”. Tìm kiếm bằng hình ảnh hoạt động bằng hai bước: một mô hình AI biến mỗi ảnh thành một dãy số, sao cho ảnh giống nhau thì dãy số gần nhau; rồi hệ thống tìm những dãy số gần nhất với ảnh bạn chụp, trong hàng triệu tới hàng tỷ ảnh, mà không phải so với từng ảnh một.
Bài này kể hai bước ấy: vì sao một ảnh có thể thành một điểm trong không gian, vì sao tìm “hàng xóm gần nhất” trong hàng tỷ điểm lại là một bài toán khó, và những mẹo giúp nó chạy trong vài mili giây. Cũng chính kỹ thuật này đang đứng sau các chatbot AI biết trả lời từ tài liệu của riêng bạn.
Một ảnh thành một dãy số
Máy tính không “thấy” đôi giày. Nó thấy hàng triệu điểm ảnh, mỗi điểm là ba con số đỏ, xanh lá, xanh dương. So hai ảnh theo từng điểm ảnh thì vô dụng: cùng một đôi giày chụp ở góc khác, ánh sáng khác là mọi con số đều khác.
Cách làm hiện nay là dùng một mạng nơ-ron đã được huấn luyện trên rất nhiều ảnh, biến mỗi ảnh thành một dãy vài trăm con số, gọi là embedding. Mạng được huấn luyện sao cho những ảnh cùng một thứ cho ra dãy số gần nhau, những ảnh khác nhau cho ra dãy số xa nhau. Mỗi ảnh vì thế thành một điểm trong một không gian vài trăm chiều: giày thể thao trắng tụ một chỗ, túi xách da tụ một chỗ khác, và hai tấm ảnh cùng một đôi giày nằm sát nhau dù chụp ở góc nào.
Bước tiến lớn năm 2021 là mô hình CLIP của OpenAI, học từ khoảng 400 triệu cặp ảnh và chú thích lấy trên Internet. CLIP đặt ảnh và chữ vào cùng một không gian: tấm ảnh một con chó và dòng chữ “một con chó” nằm gần nhau[1]. Nhờ vậy bạn có thể gõ “con mèo ngồi trên vali” để tìm trong kho ảnh của mình mà không cần ai gắn nhãn cho từng tấm.
Ý tưởng “mỗi thứ là một điểm, thứ giống nhau nằm gần nhau” cũng chính là tấm bản đồ khẩu vị trong bài hệ thống gợi ý của YouTube, TikTok, chỉ khác là điểm ở đây là ảnh thay vì người xem.
Tìm hàng xóm gần nhất: dễ nói, khó làm
Khi mọi ảnh đã thành điểm, câu hỏi “ảnh nào giống ảnh này nhất?” trở thành: điểm nào gần điểm này nhất? Đây là bài toán tìm hàng xóm gần nhất (nearest neighbor search). Độ “gần” thường được đo bằng góc giữa hai dãy số, thước đo gọi là cosine similarity.
Cách thật thà là đo khoảng cách từ ảnh của bạn tới mọi ảnh trong kho, rồi chọn mười ảnh gần nhất. Với một nghìn ảnh thì xong ngay. Với một tỷ ảnh, mỗi ảnh vài trăm con số, mỗi lần tìm phải làm hàng trăm tỷ phép nhân, mà hệ thống phải trả lời hàng nghìn người mỗi giây.
Trong bài binary search và index trong database, một chỉ mục giúp tìm nhanh vì dữ liệu xếp được theo thứ tự trên một trục. Nhưng điểm trong không gian vài trăm chiều thì không xếp được thành một hàng: hai ảnh gần nhau theo chiều này có thể xa nhau theo chiều khác. Cần những ý tưởng khác.
Ba mẹo để tìm trong hàng tỷ ảnh
Cả ba mẹo đều chấp nhận một điều: gần đúng là đủ. Nếu kết quả tốt nhất thật sự là đôi giày thứ nhất, mà hệ thống trả về đôi thứ hai giống gần y hệt, người dùng không hề thấy khác biệt. Đổi một chút độ chính xác lấy tốc độ gấp hàng trăm lần, đó là tìm kiếm hàng xóm gần đúng (approximate nearest neighbor).
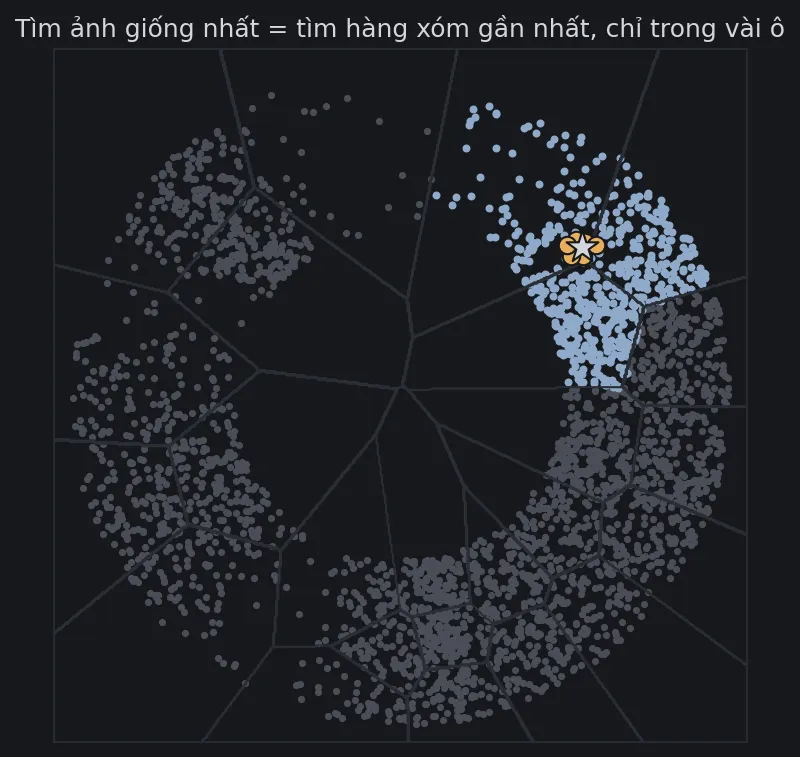
Chia ô. Trước, gom các ảnh thành vài nghìn nhóm, mỗi nhóm có một điểm đại diện. Khi tìm, chỉ so ảnh của bạn với các điểm đại diện, chọn vài nhóm gần nhất, rồi mới so kỹ với các ảnh trong những nhóm ấy. Ảnh đầu bài minh họa ý này trên mặt phẳng: ngôi sao là ảnh cần tìm, chỉ ba ô gần nó được mở, phần còn lại bỏ qua. Ở cuối bài, mô phỏng với 50.000 ảnh giả lập cho thấy chỉ cần quét 8% dữ liệu là đã tìm đúng 91% trong mười ảnh giống nhất.
Nén mỗi ảnh. Một dãy vài trăm con số thực tốn hàng nghìn byte. Kỹ thuật lượng tử hóa tích (product quantization) cắt dãy ấy thành nhiều đoạn ngắn, rồi thay mỗi đoạn bằng mã của mẫu gần nhất trong một bảng mẫu nhỏ. Mỗi ảnh chỉ còn vài chục byte, nên cả tỷ ảnh vừa trong bộ nhớ, và khoảng cách được tính gần đúng bằng cách tra bảng[5].
Đi theo đồ thị. Nối mỗi ảnh với vài ảnh gần nó nhất, thành một mạng lưới. Muốn tìm, xuất phát từ một ảnh bất kỳ, nhảy sang hàng xóm nào gần đích hơn, cứ thế đến khi không gần hơn được nữa. Phương pháp HNSW còn xếp mạng lưới thành nhiều tầng: tầng trên thưa để nhảy xa, tầng dưới dày để tìm kỹ, giống đi đường cao tốc trước rồi mới vào đường nhỏ[4].
Thư viện FAISS của Meta gộp những kỹ thuật này lại và chạy trên GPU. Bài báo giới thiệu nó có tựa đề nói lên quy mô: tìm kiếm độ tương đồng ở mức hàng tỷ vector[3].
Ngoài đời: từ Pinterest tới chatbot AI
Năm 2015, Pinterest mô tả hệ thống tìm kiếm bằng hình ảnh của họ: người dùng chọn một vùng trong ảnh, như chiếc đèn trong một tấm ảnh phòng khách, và hệ thống tìm các ảnh có đồ vật tương tự. Đặc điểm của ảnh được trích ra bằng mạng nơ-ron, rồi tìm những ảnh gần nhất trong kho ảnh khổng lồ của họ[2].
Ứng dụng lớn nhất hiện nay có lẽ lại không liên quan tới ảnh. Khi một chatbot AI trả lời dựa trên tài liệu của một công ty, nó thường làm thế này: cắt tài liệu thành từng đoạn, biến mỗi đoạn thành embedding, cất vào một cơ sở dữ liệu vector. Khi bạn hỏi, câu hỏi cũng được biến thành embedding, hệ thống tìm những đoạn văn gần nhất, rồi đưa chúng cho mô hình ngôn ngữ đọc trước khi trả lời. Cách làm này có tên sinh văn bản có truy xuất (retrieval-augmented generation, RAG)[6]. Ở đây, “tìm hàng xóm gần nhất” là thứ quyết định chatbot đọc đúng tài liệu hay không.
Chạy cho hàng triệu người dùng
Đưa ý tưởng ấy thành một hệ thống thật còn vài câu hỏi thiết kế.
- Chọn độ chính xác bao nhiêu. Mở nhiều ô hơn thì đúng hơn nhưng chậm hơn (Hình 1). Mỗi hệ thống tự chọn điểm cân bằng: tìm đồ để mua thì sai một chút không sao; tìm ảnh trùng để chặn nội dung vi phạm thì cần chính xác hơn.
- Lọc theo điều kiện. Người dùng muốn “giày giống thế này, dưới 1 triệu đồng, còn cỡ 40”. Kết hợp tìm theo khoảng cách với lọc theo giá, cỡ, tồn kho là một trong những phần khó nhất của cơ sở dữ liệu vector.
- Cập nhật. Mỗi ngày có hàng triệu ảnh mới. Một số chỉ mục, như chia ô, phải dựng lại định kỳ khi dữ liệu thay đổi nhiều; đồ thị thì thêm điểm mới dễ hơn nhưng tốn bộ nhớ.
- Chia nhỏ. Một tỷ vector không vừa một máy. Dữ liệu được chia ra nhiều máy, mỗi máy tìm trong phần của mình, rồi gộp kết quả. Thêm máy, bớt máy thế nào mà không phải chuyển lại toàn bộ dữ liệu là một bài toán riêng, quen thuộc trong mọi hệ thống phân tán.
- Embedding và chỉ mục phải đi cùng nhau. Đổi sang một mô hình AI mới tốt hơn nghĩa là mọi ảnh phải được tính lại embedding, và chỉ mục phải dựng lại từ đầu, vì dãy số của mô hình cũ và mô hình mới không so được với nhau.
Tự tay chạy: quét bao nhiêu thì đủ?
Đoạn Python dưới đây giả lập 50.000 “ảnh” thuộc 300 nhóm đồ vật, mỗi ảnh là một vector 64 chiều, và 200 ảnh cần tìm. Nó tìm mười ảnh giống nhất bằng cách quét toàn bộ (đáp án chuẩn), rồi bằng chỉ mục chia ô (chia dữ liệu thành 100 ô bằng thuật toán k-means), với số ô được mở tăng dần. Mỗi lần, nó đo phần dữ liệu phải quét và tỷ lệ tìm đúng. Đây là dữ liệu giả lập để thấy hình dạng của sự đánh đổi; con số cụ thể trên ảnh thật sẽ khác. Cần numpy và matplotlib.
import numpy as npimport matplotlib.pyplot as plt
plt.rcParams.update({"figure.facecolor": "#16181c", "axes.facecolor": "#16181c", "text.color": "#d4d7dc",                     "axes.edgecolor": "#2a2e35", "xtick.color": "#878d97", "ytick.color": "#878d97", "font.size": 12})rng = np.random.default_rng(2026)

def make_data(n, centers, noise):    """n vector giả lập "ảnh": mỗi ảnh thuộc một nhóm (giày, túi, áo...), nằm quanh tâm nhóm."""    labels = rng.integers(0, len(centers), n)    x = centers[labels] + rng.normal(0, noise, (n, centers.shape[1]))    return x / np.linalg.norm(x, axis=1, keepdims=True)    # chuẩn hóa: so sánh bằng góc (cosine)

def kmeans(x, k, steps=20):    c = x[rng.choice(len(x), k, replace=False)]    for _ in range(steps):        assign = np.argmax(x @ c.T, axis=1)                # gán mỗi vector vào tâm gần nhất        for j in range(k):            if np.any(assign == j):                c[j] = x[assign == j].mean(0)        c /= np.linalg.norm(c, axis=1, keepdims=True)    return c, np.argmax(x @ c.T, axis=1)

# ── Thí nghiệm: 50.000 "ảnh", mỗi ảnh là vector 64 chiều; 200 truy vấn; tìm 10 ảnh giống nhất.N, DIM, TOPK, NLIST = 50_000, 64, 10, 100groups = rng.normal(0, 1, (300, DIM))                       # 300 nhóm đồ vậtdata = make_data(N, groups, 1.2)queries = make_data(200, groups, 1.2)                       # ảnh bạn chụp cũng thuộc một nhóm đã có trong khoexact = np.argsort(-(queries @ data.T), axis=1)[:, :TOPK]  # quét toàn bộ: chính xác nhưng tốn kém
centroids, cell = kmeans(data, NLIST)                       # chỉ mục IVF: chia dữ liệu thành 100 ômembers = [np.nonzero(cell == j)[0] for j in range(NLIST)]results = []for nprobe in [1, 2, 4, 8, 16, 32, 100]:    recall, scanned = 0, 0    for q, truth in zip(queries, exact):        cells = np.argsort(-(centroids @ q))[:nprobe]       # chỉ mở nprobe ô gần truy vấn nhất        cand = np.concatenate([members[j] for j in cells])        top = cand[np.argsort(-(data[cand] @ q))[:TOPK]]        recall += len(set(top) & set(truth)) / TOPK        scanned += len(cand)    results.append((nprobe, scanned / len(queries) / N, recall / len(queries)))    print(f"mở {nprobe:>3} ô: quét {scanned / len(queries) / N:6.1%} dữ liệu, tìm đúng {recall / len(queries):6.1%} trong 10 ảnh giống nhất")
# Hình 1: quét ít dữ liệu đến đâu mà vẫn tìm đúng.fig, ax = plt.subplots(figsize=(9, 5))xs = [100 * s for _, s, _ in results]ys = [100 * r for _, _, r in results]ax.plot(xs, ys, "o-", color="#e8b05a", lw=2.5, ms=8)for (p, s, r), x, y in zip(results, xs, ys):    ax.annotate(f"mở {p} ô", (x, y), xytext=(8, -16), textcoords="offset points", color="#a4a9b2", fontsize=10)ax.set_xscale("log")ax.set_xticks([1, 2, 4, 8, 16, 32, 100], ["1%", "2%", "4%", "8%", "16%", "32%", "100%"])ax.minorticks_off()ax.set_xlabel("phần dữ liệu phải quét (thang log)", color="#a4a9b2")ax.set_ylabel("tìm đúng trong 10 ảnh giống nhất (%)", color="#a4a9b2")ax.set_title("Chỉ mục chia ô: quét một phần nhỏ, vẫn tìm gần đúng", color="#d4d7dc", fontsize=12)ax.grid(color="#22262c")fig.savefig("quet-it-van-tim-dung.png", dpi=150, bbox_inches="tight")
# Hình bìa: cùng ý tưởng trên mặt phẳng — dữ liệu chia thành ô, truy vấn chỉ mở vài ô gần nhất.pts = make_data(3000, rng.normal(0, 1, (12, 2)), 0.25) * rng.uniform(0.5, 1.0, (3000, 1))c2 = pts[rng.choice(len(pts), 24, replace=False)]for _ in range(15):    a2 = np.argmin(((pts[:, None] - c2[None]) ** 2).sum(-1), axis=1)    c2 = np.array([pts[a2 == j].mean(0) if np.any(a2 == j) else c2[j] for j in range(len(c2))])q2 = np.array([0.55, 0.45])open_cells = np.argsort(((c2 - q2) ** 2).sum(-1))[:3]gx, gy = np.meshgrid(np.linspace(-1.05, 1.05, 500), np.linspace(-1.05, 1.05, 500))grid_cell = np.argmin(((np.stack([gx, gy], -1)[..., None, :] - c2) ** 2).sum(-1), axis=-1)fig, ax = plt.subplots(figsize=(9, 6))ax.contour(gx, gy, grid_cell, levels=np.arange(len(c2)) + 0.5, colors="#2a2e35", linewidths=1)inside = np.isin(a2, open_cells)ax.scatter(*pts[~inside].T, s=6, color="#4a4e57")ax.scatter(*pts[inside].T, s=8, color="#8fa9c9")near = np.argsort(((pts - q2) ** 2).sum(-1))[:10]ax.scatter(*pts[near].T, s=70, color="#e8b05a", edgecolors="#16181c", zorder=3)ax.scatter(*q2, marker="*", s=260, color="#d4d7dc", edgecolors="#16181c", zorder=4)ax.set_xticks([]); ax.set_yticks([]); ax.set_aspect("equal")ax.set_xlim(-1.05, 1.05); ax.set_ylim(-1.05, 1.05)ax.set_title("Tìm ảnh giống nhất = tìm hàng xóm gần nhất, chỉ trong vài ô", color="#d4d7dc", fontsize=12)fig.savefig("hang-xom-gan-nhat.png", dpi=150, bbox_inches="tight")
mở 1 ô: quét 1.0% dữ liệu, tìm đúng 76.2% trong 10 ảnh giống nhấtmở 2 ô: quét 2.1% dữ liệu, tìm đúng 81.9% trong 10 ảnh giống nhấtmở 4 ô: quét 4.1% dữ liệu, tìm đúng 86.0% trong 10 ảnh giống nhấtmở 8 ô: quét 8.0% dữ liệu, tìm đúng 91.2% trong 10 ảnh giống nhấtmở 16 ô: quét 16.0% dữ liệu, tìm đúng 94.9% trong 10 ảnh giống nhấtmở 32 ô: quét 32.2% dữ liệu, tìm đúng 97.9% trong 10 ảnh giống nhấtmở 100 ô: quét 100.0% dữ liệu, tìm đúng 100.0% trong 10 ảnh giống nhất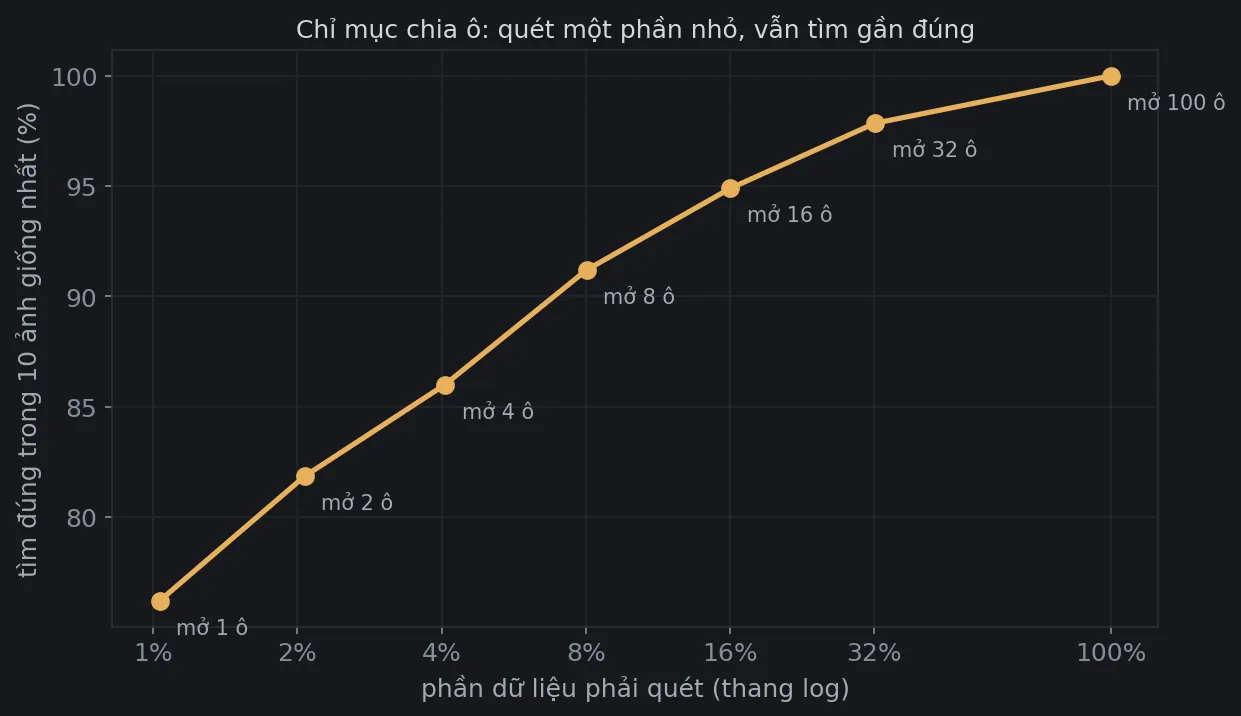
Chỉ mở một ô, tức quét 1% dữ liệu, hệ thống đã tìm đúng khoảng ba phần tư trong mười ảnh giống nhất. Mở 8 ô (quét 8%) thì đúng 91%, nhanh hơn quét toàn bộ khoảng mười hai lần. Những ảnh bị bỏ sót thường nằm ở rìa một ô láng giềng, đúng chỗ mà đường biên giữa các ô cắt ngang một nhóm ảnh giống nhau, như bạn có thể thấy ở ảnh đầu bài.
Bạn có thể đổi NLIST (số ô) hay độ nhiễu 1.2 để thấy đường cong dịch chuyển: dữ liệu càng tụ thành nhóm rõ ràng, chỉ mục chia ô càng hiệu quả.
Giống nhau là một khoảng cách
Tìm kiếm bằng hình ảnh, gợi ý video, chatbot đọc tài liệu: ba thứ nghe rất khác nhau đều dựa trên cùng một ý tưởng. Biến mọi thứ thành điểm trong một không gian, sao cho “giống nhau” nghĩa là “gần nhau”, rồi tìm hàng xóm thật nhanh, chấp nhận đúng gần như tuyệt đối thay vì tuyệt đối. Lần tới khi ứng dụng tìm ra đúng đôi giày bạn vừa chụp, phía sau là một ngôi sao nhỏ giữa hàng tỷ điểm, và vài ô được mở ra quanh nó.
Vẽ minh họa hình học miễn phí cho học sinh và giáo viên: EyeViz.
Tài liệu tham khảo
- [1]Alec Radford và cộng sự. Learning Transferable Visual Models From Natural Language Supervision (CLIP). ICML 2021, 2021.
- [2]Yushi Jing và cộng sự. Visual Search at Pinterest. KDD ’15, 2015.
- [3]Jeff Johnson, Matthijs Douze và Hervé Jégou. Billion-scale similarity search with GPUs. IEEE Transactions on Big Data, 2019.
- [4]Yu. A. Malkov và D. A. Yashunin. Efficient and robust approximate nearest neighbor search using Hierarchical Navigable Small World graphs. IEEE Transactions on Pattern Analysis and Machine Intelligence, 42(4), 2020.
- [5]Hervé Jégou, Matthijs Douze và Cordelia Schmid. Product Quantization for Nearest Neighbor Search. IEEE Transactions on Pattern Analysis and Machine Intelligence, 33(1), 2011.
- [6]Patrick Lewis và cộng sự. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. NeurIPS 2020, 2020.