Hệ thống gợi ý: vì sao YouTube, TikTok biết bạn thích gì?
Hệ thống gợi ý hoạt động thế nào: YouTube, TikTok nghe tín hiệu gì, ý tưởng "người giống bạn", bài học từ giải Netflix 1 triệu USD.
Mục lục
Bạn xem một video nấu phở, và trang chủ YouTube lập tức đầy video nấu ăn. Bạn dừng lại hai giây ở một clip bóng đá trên TikTok, và mười clip tiếp theo toàn bóng đá. Phía sau là một hệ thống gợi ý (recommendation system): một cỗ máy học từ hành vi của hàng triệu người để đoán thứ bạn muốn xem tiếp. Ý tưởng cốt lõi của nó đơn giản đến bất ngờ: những người từng thích giống bạn, đã thích gì tiếp theo?
Bài này kể hệ thống gợi ý hoạt động thế nào: nó nghe những tín hiệu gì từ bạn, vì sao máy có thể hiểu “khẩu vị” mà không ai dạy nó chủ đề của video, bài học từ giải thưởng 1 triệu USD của Netflix, và cách YouTube chọn ra vài chục video từ hàng triệu video trong chớp mắt. Cuối bài có một đoạn code để bạn tự tay dựng một hệ thống gợi ý tí hon.
Hệ thống gợi ý nghe gì từ bạn?
YouTube cho biết hệ thống gợi ý của họ học mỗi ngày từ hơn 80 tỷ tín hiệu: bạn bấm vào video nào, xem bao lâu, trả lời khảo sát ra sao, chia sẻ, thích, không thích[1].
Thứ tự ấy có lịch sử của nó. Ban đầu, cú bấm là tín hiệu chính. Nhưng năm 2011, YouTube nhận ra bấm vào một video không có nghĩa là bạn thật sự xem nó, vì tiêu đề giật gân có thể lừa bất kỳ ai bấm. Năm 2012 họ thêm thời gian xem. Rồi họ nhận ra thời gian xem cũng chưa đủ: bạn có thể xem hết một video mà vẫn thấy phí thời gian. Vì vậy YouTube hỏi trực tiếp một số người xem chấm điểm video từ một đến năm sao, và chỉ coi là “thời gian xem có giá trị” những video được chấm bốn, năm sao. Vì phần lớn mọi người không trả lời khảo sát, họ huấn luyện một mô hình để dự đoán câu trả lời cho tất cả[1].
TikTok mô tả hệ thống của họ dựa trên ba nhóm tín hiệu[2]:
- Bạn tương tác thế nào: video bạn thích hay chia sẻ, tài khoản bạn theo dõi, bình luận bạn viết, nội dung bạn tạo.
- Thông tin của video: chú thích, âm thanh, hashtag.
- Thiết bị và tài khoản: ngôn ngữ, quốc gia, loại máy. Nhóm này được tính nhẹ hơn, vì đó không phải thứ bạn chủ động chọn.
Điểm chung của cả hai: hệ thống không đọc suy nghĩ của bạn. Nó chỉ nhìn bạn làm gì, rồi so với những gì hàng triệu người khác đã làm.
“Người giống bạn”: ý tưởng cốt lõi của hệ thống gợi ý
Giả sử An và Bình cùng xem hết năm video làm bánh, cùng bỏ dở ba video bóng đá. Hôm nay Bình xem hết một video làm bánh mì mà An chưa thấy. Đoán xem An có thích video ấy không?
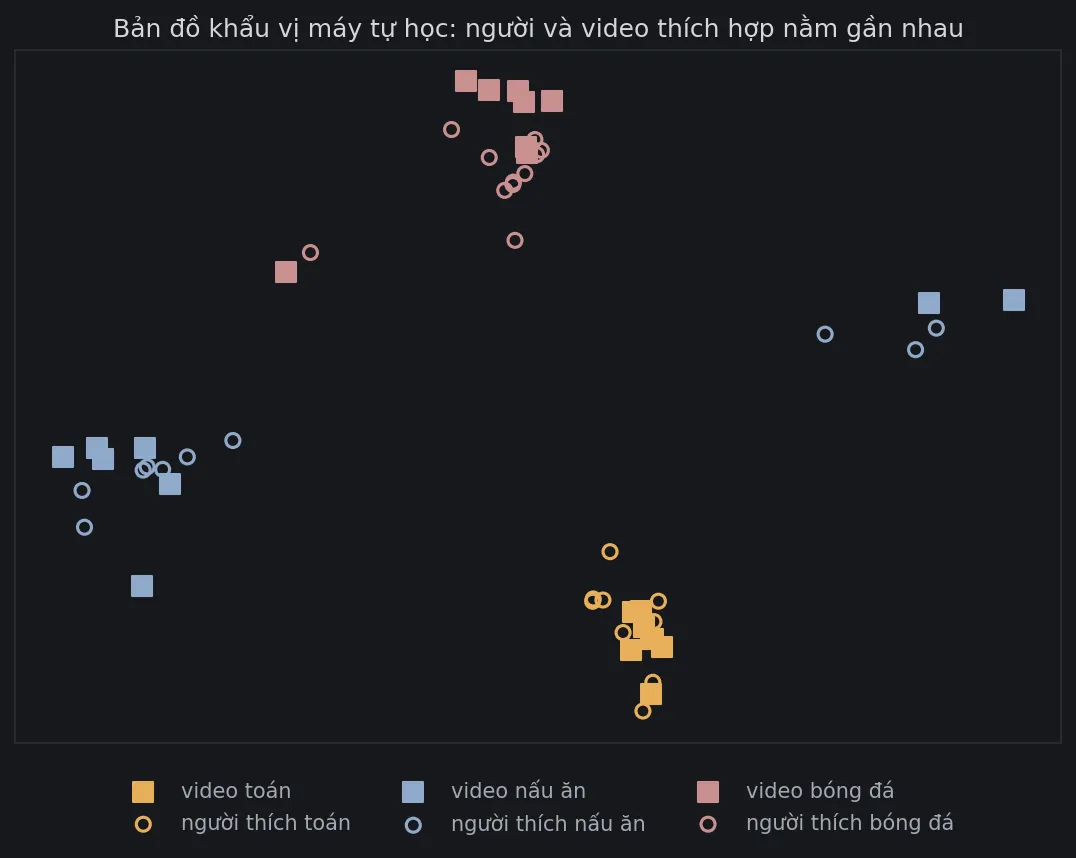
Đó là lọc cộng tác (collaborative filtering): không cần biết video nói về gì, chỉ cần biết ai đã xem gì. Nhưng so từng cặp người với nhau thì quá chậm khi có hàng tỷ người dùng. Cách làm hiệu quả hơn là đặt mỗi người và mỗi video thành một điểm trên một tấm bản đồ khẩu vị, sao cho người nằm gần những video họ thích. Muốn gợi ý cho An, chỉ cần tìm những video nằm gần An mà An chưa xem.
Điều kỳ diệu là tấm bản đồ ấy tự học ra từ dữ liệu. Ảnh đầu bài là một ví dụ do đoạn code ở cuối bài tạo ra: 30 người xem, 24 video thuộc ba chủ đề toán, nấu ăn, bóng đá. Máy không được cho biết video nào thuộc chủ đề nào, chỉ được biết mỗi người đã xem hết bao nhiêu phần trăm của khoảng một phần tư số video. Vậy mà các video tự xếp thành ba cụm, và mỗi người nằm cạnh đúng cụm mình thích.
Trên các hệ thống thật, mỗi người và mỗi video không phải một điểm trên mặt phẳng mà là một dãy vài chục tới vài trăm con số, gọi là embedding. Các chiều của nó không có tên. Có thể một chiều vô tình ứng với “thích nội dung dài”, một chiều khác với “thích hài hước”, nhưng không ai đặt tên trước cho chúng. Máy tự tìm ra những trục nào giải thích hành vi tốt nhất.
Giải thưởng 1 triệu USD của Netflix
Năm 2006, Netflix, khi ấy còn chủ yếu cho thuê đĩa DVD qua bưu điện, mở một cuộc thi: ai cải thiện được độ chính xác của hệ thống dự đoán số sao người dùng chấm cho phim thêm 10% sẽ nhận 1 triệu USD. Họ công bố khoảng 100 triệu lượt chấm điểm (đã ẩn danh) để mọi người thử.
Một trong những phát hiện quan trọng nhất của cuộc thi chính là tấm bản đồ khẩu vị ở trên, dưới tên phân rã ma trận (matrix factorization): coi bảng “người × phim” là một ma trận khổng lồ gần như trống, rồi tìm hai bảng nhỏ (vector của người, vector của phim) mà nhân với nhau thì khớp với những ô đã biết nhất. Những người trong đội thắng cuộc về sau viết lại phương pháp này thành một bài báo kinh điển[4].
Năm 2009, đội BellKor’s Pragmatic Chaos đạt mốc 10% và nhận giải. Nhưng phần thú vị nhất đến sau. Năm 2012, Netflix viết rằng họ đã đưa vào sản xuất hai thuật toán tốt nhất từ giải thưởng phụ năm 2007, trong đó có phân rã ma trận, nhưng không dùng lời giải thắng giải lớn. Lời giải ấy là sự pha trộn của hơn 800 mô hình, và phần chính xác tăng thêm không đáng với công sức kỹ thuật để chạy nó trong hệ thống thật. Hơn nữa, khi ấy Netflix đã chuyển sang phát trực tuyến, nơi người ta chọn phim ngay lập tức chứ không đợi đĩa tới vài ngày sau, và bài toán gợi ý đã khác. Cũng trong bài viết ấy, Netflix cho biết khoảng 75% những gì người dùng xem đến từ một dạng gợi ý nào đó[5].
Bài học ấy quen thuộc với bất kỳ ai làm hệ thống: mô hình chính xác nhất trên giấy chưa chắc là mô hình tốt nhất để chạy cho hàng triệu người mỗi ngày.
Chọn vài chục video từ hàng triệu video
YouTube có hàng triệu video ứng viên cho mỗi người, và phải trả lời trong vài trăm mili giây. Chấm điểm kỹ từng video là không thể. Năm 2016, các kỹ sư YouTube mô tả hệ thống của họ chia làm hai tầng[3]:
- Tạo ứng viên (candidate generation): từ hàng triệu video, nhanh chóng chọn ra vài trăm video có vẻ liên quan. Tầng này dùng chính ý tưởng bản đồ khẩu vị: biến người dùng thành một vector rồi tìm những video có vector gần nhất, một phép tìm kiếm cực nhanh.
- Xếp hạng (ranking): với vài trăm ứng viên ấy, một mô hình kỹ hơn, dùng nhiều tín hiệu hơn, chấm điểm từng video rồi sắp xếp.
Ở tầng xếp hạng, YouTube chọn dự đoán thời gian xem thay vì khả năng bấm vào. Lý do được viết thẳng trong bài báo: xếp theo tỷ lệ bấm thường đẩy lên những video lừa đảo mà người xem không xem hết[3]. Bài báo cũng kể một mẹo nhỏ: khi huấn luyện, họ cho mô hình biết mỗi dữ liệu đã cũ bao nhiêu ngày; khi gợi ý thật, họ đặt tuổi ấy bằng 0. Nhờ vậy mô hình không thiên vị những video đã nổi từ lâu, và video mới có cơ hội được gợi ý[3].
Kiến trúc “lọc thô nhanh, xếp hạng kỹ sau” xuất hiện ở khắp nơi trong các hệ thống lớn, cùng tinh thần với Bloom filter đứng gác trước cơ sở dữ liệu: dùng một bước rẻ để loại phần lớn khả năng, rồi mới dùng bước đắt cho phần còn lại. Chính Bloom filter từng được Medium dùng để bỏ những bài bạn đã đọc ra khỏi danh sách gợi ý.
Thêm một mảnh nữa: việc huấn luyện mô hình thường chạy định kỳ trên kho dữ liệu khổng lồ, còn việc gợi ý phải chạy tức thì mỗi khi bạn mở ứng dụng. Hai phần ấy thường tách thành hai hệ thống riêng: một bên chạy chậm, nặng, theo lô; một bên nhanh, nhẹ, dùng kết quả đã tính sẵn.
Người mới, video mới và bong bóng lọc
Khởi đầu lạnh (cold start). Một người vừa cài ứng dụng chưa có lịch sử, một video vừa đăng chưa ai xem: hệ thống không biết đặt họ ở đâu trên bản đồ. TikTok cho biết với người mới, họ bắt đầu từ những sở thích bạn chọn khi đăng ký; nếu bạn không chọn, họ cho xem một nguồn video phổ biến chung để có dữ liệu ban đầu[2]. Video mới thì được thử với một nhóm nhỏ người xem trước khi biết nó hợp với ai. Thí nghiệm ở cuối bài cho thấy rõ vấn đề này: chỗ có ít dữ liệu nhất bị đoán sai nhiều nhất.
Bong bóng lọc. Hệ thống gợi ý tối ưu cho những gì bạn đã thích, nên dễ chỉ cho bạn xem thêm đúng những thứ ấy, và càng xem càng hẹp. Vì vậy các nền tảng cố tình chèn vào một phần nội dung khác với thói quen của bạn, chấp nhận gợi ý “kém chính xác” hơn một chút để biết thêm về bạn và để bạn không bị nhốt trong một góc. TikTok cho biết họ có những cơ chế đa dạng hóa nội dung trong nguồn “Dành cho bạn”[2]. Đây là thế giằng co kinh điển giữa khai thác (gợi ý thứ chắc chắn bạn thích) và khám phá (thử thứ mới để học thêm).
Tự tay dựng một hệ thống gợi ý tí hon
Đoạn Python dưới đây tạo một thế giới nhỏ: 30 người xem, mỗi người có khẩu vị ẩn với ba chủ đề, và 24 video. Mỗi người mới xem khoảng một phần tư số video, và “điểm” là tỷ lệ xem hết. Hệ thống chỉ thấy những ô đã xem, rồi dùng phân rã ma trận để đoán các ô còn lại.
Cách học là bình phương nhỏ nhất luân phiên: giữ nguyên vector của các video, tìm vector của từng người khớp nhất với những gì họ đã xem, theo đúng tinh thần bình phương nhỏ nhất của Gauss; rồi giữ nguyên người, tìm lại vector của từng video; lặp lại. Các hệ thống lớn thường dùng gradient descent thay vì công thức này, nhưng ý tưởng giống nhau. Đoạn code tạo ra cả ảnh đầu bài và Hình 1. Cần numpy và matplotlib.
import numpy as npimport matplotlib.pyplot as plt
plt.rcParams.update({"figure.facecolor": "#16181c", "axes.facecolor": "#16181c", "text.color": "#d4d7dc",                     "axes.edgecolor": "#2a2e35", "xtick.color": "#878d97", "ytick.color": "#878d97", "font.size": 12})rng = np.random.default_rng(2026)  # cố định seed để chạy lại ra cùng kết quả
# 30 người xem, 24 video thuộc 3 chủ đề. Mỗi người có "khẩu vị" ẩn: thích chủ đề nào bao nhiêu.TOPICS = ["toán", "nấu ăn", "bóng đá"]n_users, n_videos = 30, 24video_topic = np.repeat(np.arange(3), n_videos // 3)user_main = rng.integers(0, 3, n_users)                    # chủ đề mỗi người thích nhấttaste = np.full((n_users, 3), 0.15) + rng.uniform(0, 0.1, (n_users, 3))taste[np.arange(n_users), user_main] = rng.uniform(0.75, 0.95, n_users)# Điểm thật: tỷ lệ xem hết video (0…1) — người ta xem hết video đúng khẩu vị.truth = np.clip(taste[:, video_topic] + rng.normal(0, 0.05, (n_users, n_videos)), 0, 1)
# Mỗi người mới xem 25% số video. Phần còn lại là thứ hệ thống phải đoán.seen = rng.random((n_users, n_videos)) < 0.25print(f"đã biết {seen.sum()} / {seen.size} ô ({seen.mean():.0%})")
# Phân rã ma trận: mỗi người và mỗi video là một vector 3 chiều; điểm dự đoán = tích vô hướng.# Học bằng cách luân phiên: cố định video, tìm vector người khớp nhất với các ô đã biết (bình phương nhỏ nhất),# rồi cố định người, tìm vector video; lặp lại.K, reg = 3, 0.1U = rng.normal(0, 0.3, (n_users, K))V = rng.normal(0, 0.3, (n_videos, K))for step in range(50):    for u in range(n_users):        Vs = V[seen[u]]        U[u] = np.linalg.solve(Vs.T @ Vs + reg * np.eye(K), Vs.T @ truth[u, seen[u]])    for v in range(n_videos):        Us = U[seen[:, v]]        V[v] = np.linalg.solve(Us.T @ Us + reg * np.eye(K), Us.T @ truth[seen[:, v], v])pred = np.clip(U @ V.T, 0, 1)
unseen = ~seenmae = np.abs(pred - truth)[unseen].mean()baseline = np.abs(truth[seen].mean() - truth)[unseen].mean()  # đoán ai cũng xem mức trung bìnhhit = np.mean([video_topic[np.argmax(np.where(unseen[u], pred[u], -1))] == user_main[u] for u in range(n_users)])print(f"sai số trung bình ở ô chưa xem: {mae:.3f} (đoán bừa theo trung bình: {baseline:.3f})")print(f"video gợi ý số 1 đúng chủ đề người đó thích nhất: {hit:.0%} số người")
# Hình 1: bảng điểm đã biết (trái) và bảng hệ thống tự điền (phải).order_u = np.argsort(user_main, kind="stable")fig, axes = plt.subplots(1, 2, figsize=(11, 5.2))shown = np.where(seen, truth, np.nan)[order_u]for ax, data, title in [(axes[0], shown, "Hệ thống biết: 25% ô (xám = chưa xem)"),                        (axes[1], pred[order_u], "Hệ thống tự điền phần còn lại")]:    ax.set_facecolor("#2a2e35")    ax.imshow(data, cmap="magma", vmin=0, vmax=1, aspect="auto")    ax.set_title(title, color="#d4d7dc", fontsize=12)    ax.set_xticks([4, 12, 20], TOPICS)    ax.set_yticks([])    ax.set_xlabel("24 video, xếp theo chủ đề", color="#a4a9b2")axes[0].set_ylabel("30 người xem, xếp theo sở thích", color="#a4a9b2")fig.tight_layout()fig.savefig("bang-diem-tu-dien.png", dpi=150, bbox_inches="tight")
# Hình bìa: mỗi người và mỗi video thành một điểm trên "bản đồ khẩu vị" mà máy tự học ra# (vector 3 chiều, chiếu xuống mặt phẳng bằng PCA để vẽ).both = np.vstack([U, V])_, _, axes_pc = np.linalg.svd(both - both.mean(0), full_matrices=False)U2, V2 = (U - both.mean(0)) @ axes_pc[:2].T, (V - both.mean(0)) @ axes_pc[:2].Tcolors = ["#e8b05a", "#8fa9c9", "#c98f8f"]fig, ax = plt.subplots(figsize=(9, 6))for t in range(3):    ax.scatter(V2[video_topic == t, 0], V2[video_topic == t, 1], marker="s", s=90, color=colors[t], label=f"video {TOPICS[t]}")    ax.scatter(U2[user_main == t, 0], U2[user_main == t, 1], marker="o", s=45, facecolors="none", edgecolors=colors[t], lw=1.5,               label=f"người thích {TOPICS[t]}")ax.set_title("Bản đồ khẩu vị máy tự học: người và video thích hợp nằm gần nhau", color="#d4d7dc", fontsize=12)ax.set_xticks([]); ax.set_yticks([])ax.legend(frameon=False, labelcolor="#a4a9b2", fontsize=10, ncol=3, loc="lower center", bbox_to_anchor=(0.5, -0.16))fig.savefig("ban-do-khau-vi.png", dpi=150, bbox_inches="tight")
đã biết 185 / 720 ô (26%)sai số trung bình ở ô chưa xem: 0.133 (đoán bừa theo trung bình: 0.289)video gợi ý số 1 đúng chủ đề người đó thích nhất: 100% số người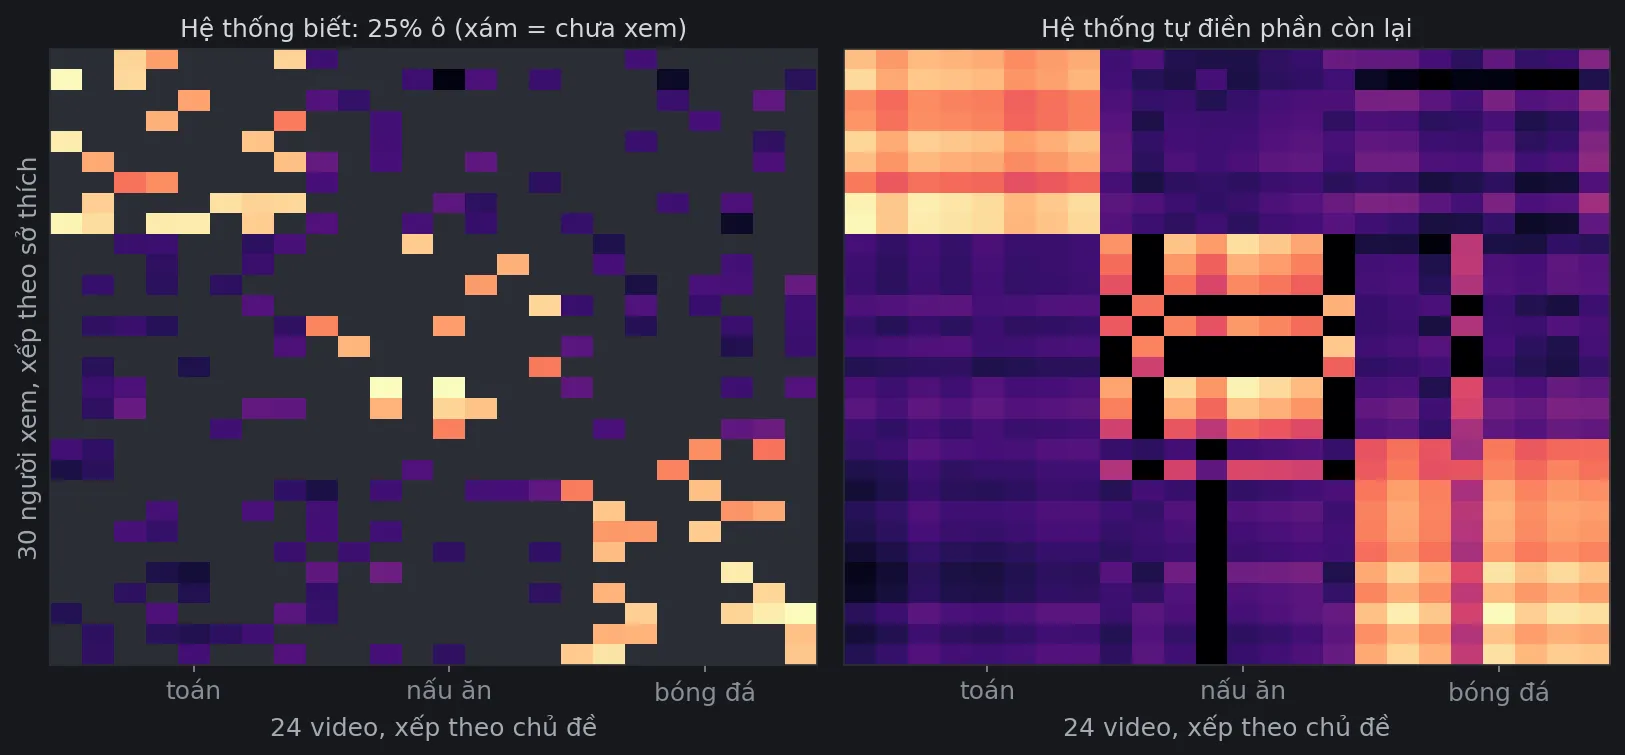
Với chỉ khoảng một phần tư dữ liệu, sai số trung bình ở những ô chưa xem giảm từ 0,289 (đoán ai cũng xem như trung bình) xuống 0,133, và video được gợi ý đầu tiên cho mỗi người đều đúng chủ đề người đó thích nhất. Những sọc tối ở bảng phải đều nằm ở vùng nấu ăn, chỗ dữ liệu mỏng nhất: trong 10 người thích nấu ăn, 7 người mới xem đúng một video nấu ăn, và có video nấu ăn chỉ một người thích nấu ăn từng xem. Vùng này chỉ có 14 ô đã biết, so với 23 và 25 ở hai vùng kia, và sai số ở đó cao gấp bốn, năm lần (0,48 so với 0,09 và 0,12). Dữ liệu quá ít để máy đặt vài người và vài video đúng chỗ trên bản đồ.
Bạn có thể thử đổi tỷ lệ 0.25 thành 0.1 để xem điều gì xảy ra khi dữ liệu ít đi, hoặc đổi K = 3 thành K = 2 để thấy điều gì xảy ra khi bản đồ khẩu vị có ít chiều hơn số chủ đề: máy không còn đủ chỗ để tách ba nhóm, và gợi ý sai hẳn.
Bạn cũng đang dạy nó
Hệ thống gợi ý không biết bạn là ai. Nó chỉ biết bạn đứng ở đâu trên một tấm bản đồ do hàng triệu người khác cùng vẽ, và mỗi lần bạn xem hết, bỏ qua hay bấm thích, bạn dịch chỗ của mình một chút. Hiểu điều đó, bạn có thể chủ động hơn: bấm “không quan tâm” khi cần, tìm kiếm thứ mới thay vì chỉ lướt, và nhớ rằng nguồn video của bạn là kết quả của chính những gì bạn đã cho nó thấy.
Vẽ minh họa hình học miễn phí cho học sinh và giáo viên: EyeViz.
Tài liệu tham khảo
- [1]Cristos Goodrow. On YouTube’s recommendation system. YouTube Official Blog, 2021.
- [2]How TikTok recommends videos #ForYou. TikTok Newsroom, 2020.
- [3]Paul Covington, Jay Adams và Emre Sargin. Deep Neural Networks for YouTube Recommendations. RecSys ’16, 2016.
- [4]Yehuda Koren, Robert Bell và Chris Volinsky. Matrix Factorization Techniques for Recommender Systems. IEEE Computer, 42(8), 30–37, 2009.
- [5]Xavier Amatriain và Justin Basilico. Netflix Recommendations: Beyond the 5 stars (Part 1). Netflix Technology Blog, 2012.