Gradient descent: thuật toán đứng sau gần như mọi mô hình AI
Một mô hình AI có hàng trăm tỷ tham số, không ai chỉnh tay được. Thứ làm việc đó là một ý tưởng từ năm 1847: đứng giữa sương mù, cảm nhận độ dốc dưới chân và bước xuống. Từ đạo hàm, tốc độ học, ví dụ cước taxi đến lan truyền ngược, SGD, Adam và overfitting.
Mục lục
Làm sao chọn 175 tỷ con số?
GPT-3, mô hình ngôn ngữ được OpenAI công bố năm 2020, có 175 tỷ tham số[2]. Mỗi tham số là một con số. Toàn bộ “hiểu biết” của mô hình, từ ngữ pháp tiếng Anh tới cách viết một đoạn code, nằm trong việc 175 tỷ con số ấy mang giá trị gì.
Không ai ngồi chọn từng con số. Vậy chúng được chọn bằng cách nào?
Ý nghĩ đầu tiên có thể là: thử hết mọi khả năng và giữ lại bộ tốt nhất. Nhưng ngay cả một mô hình chỉ có 10 tham số, mỗi tham số thử 100 giá trị, đã có tổ hợp. Máy tính thử một tỷ tổ hợp mỗi giây vẫn cần khoảng ba nghìn năm. Với 175 tỷ tham số, con số này vượt xa mọi thứ có thể tưởng tượng.
Câu trả lời thực tế đơn giản đến bất ngờ, và đã có từ năm 1847: gradient descent, thuật toán “đi xuống theo độ dốc”.
Xuống núi trong sương mù
Hãy tưởng tượng bạn đứng trên sườn núi, sương mù dày đặc, không nhìn thấy gì quá một bước chân. Bạn muốn xuống tới thung lũng. Bạn sẽ làm gì?
Cách tự nhiên nhất: dò chân quanh mình, cảm nhận hướng nào dốc xuống nhiều nhất, rồi bước một bước theo hướng đó. Lặp lại. Không cần bản đồ, không cần nhìn thấy đích. Chỉ cần độ dốc ngay dưới chân.
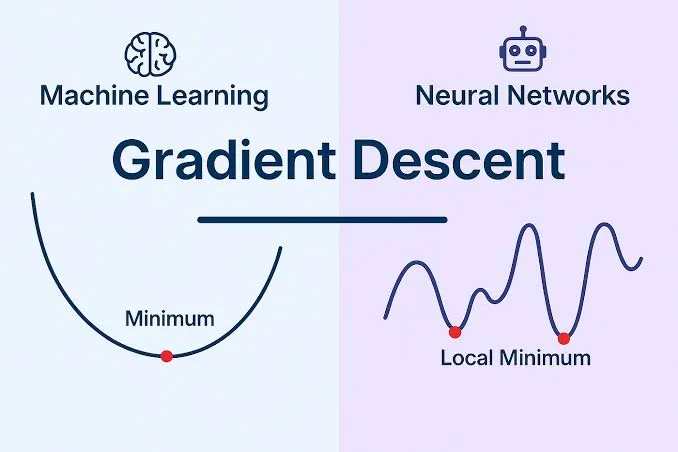
Đó chính là gradient descent. Trong học máy, “ngọn núi” là một hàm số gọi là hàm mất mát (loss function), đo xem mô hình đang sai nhiều hay ít. Mô hình dự đoán càng lệch so với thực tế, “độ cao” càng lớn. Còn “vị trí” của bạn trên núi là bộ giá trị hiện tại của các tham số. Huấn luyện mô hình là đi tìm vị trí thấp nhất: bộ tham số khiến mô hình sai ít nhất.
Năm 1847, nhà toán học Pháp Augustin-Louis Cauchy đề xuất đúng ý tưởng này, dù mục đích của ông là giải hệ phương trình trong tính toán thiên văn chứ không phải huấn luyện máy[1].
Độ dốc, đạo hàm và gradient
Với một hàm một biến , độ dốc tại một điểm chính là đạo hàm . Đạo hàm dương nghĩa là đi sang phải thì hàm tăng; muốn giảm thì phải đi sang trái. Đạo hàm âm thì ngược lại. Vì vậy quy tắc rất gọn: luôn bước ngược dấu với đạo hàm.
Con số (đọc là “eta”) gọi là tốc độ học (learning rate): nó quyết định mỗi bước dài bao nhiêu.
Khi hàm có nhiều biến, ví dụ hàng tỷ tham số, ta tính đạo hàm theo từng biến và gom lại thành một vector gọi là gradient, ký hiệu . Gradient chỉ về hướng hàm tăng nhanh nhất. Đi ngược hướng gradient là đi xuống dốc nhanh nhất. Quy tắc cập nhật cho mọi tham số cùng lúc:
Toàn bộ thuật toán chỉ có vậy. Phần còn lại của bài này là những chi tiết khiến dòng công thức ngắn ngủi ấy hoạt động được trên một mô hình có hàng tỷ tham số.
Bước dài hay bước ngắn?
Thử với một hàm đơn giản mà ta đã biết đáp án: , cực tiểu tại . Đạo hàm là . Bắt đầu từ và thử ba tốc độ học:
# Tìm cực tiểu của f(x) = (x - 3)^2 bằng gradient descent, với ba tốc độ học khác nhaudef grad(x):    return 2 * (x - 3)          # đạo hàm của (x - 3)^2
for lr in (0.05, 0.45, 1.05):    x = 0.0    trail = [x]    for _ in range(6):        x = x - lr * grad(x)    # bước về phía ngược với độ dốc        trail.append(x)    print(f"η = {lr:<4}: " + " → ".join(f"{v:.2f}" for v in trail))
η = 0.05: 0.00 → 0.30 → 0.57 → 0.81 → 1.03 → 1.23 → 1.41η = 0.45: 0.00 → 2.70 → 2.97 → 3.00 → 3.00 → 3.00 → 3.00η = 1.05: 0.00 → 6.30 → -0.63 → 6.99 → -1.39 → 7.83 → -2.31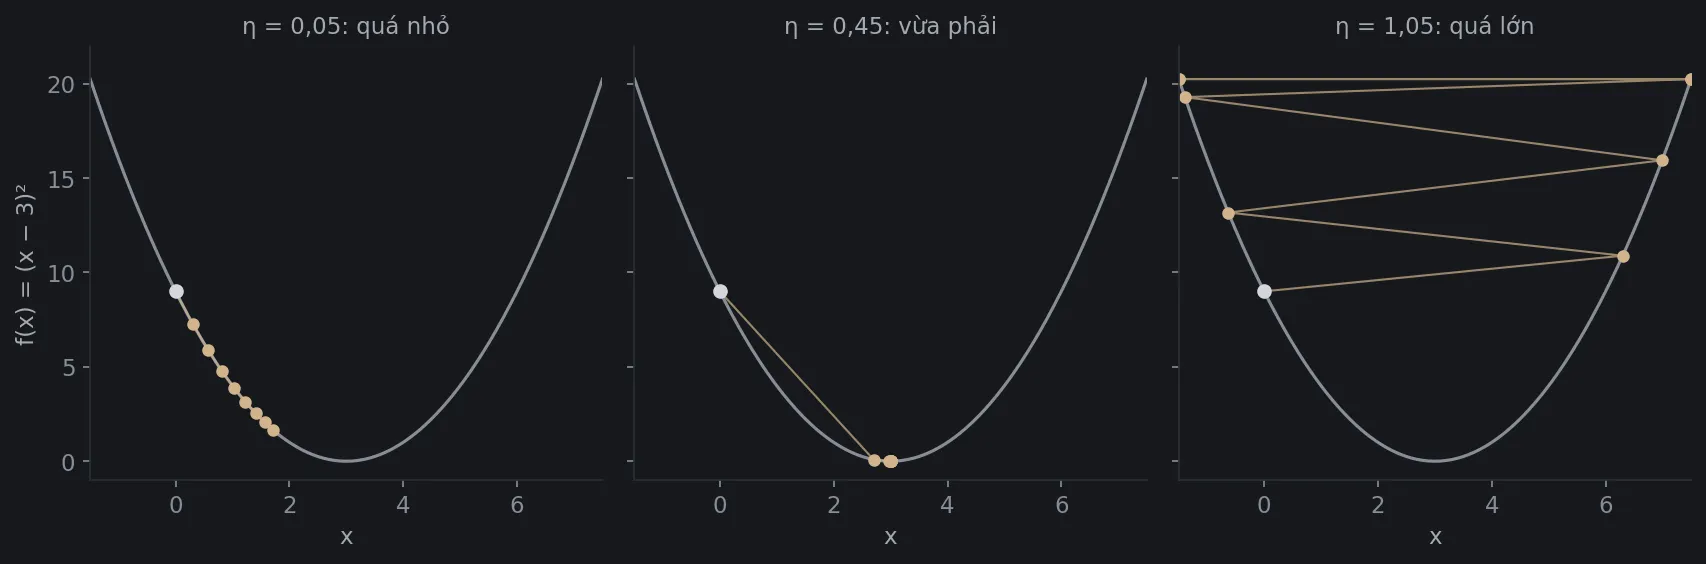
Tốc độ học nhỏ quá, thuật toán đi đúng hướng nhưng chậm như rùa. Vừa phải, nó tới đáy sau vài bước. Lớn quá, mỗi bước nhảy vượt qua đáy sang sườn bên kia, cao hơn chỗ cũ, và càng đi càng văng xa.
Chọn tốc độ học là một trong những việc phiền toái nhất khi huấn luyện mô hình thật, vì ta không biết trước hình dạng của ngọn núi.
Ví dụ: đoán cách tính cước taxi
Bây giờ thử một bài toán có hai tham số và dữ liệu “thật” hơn. Giả sử bạn ghi lại số km và tiền cước của 30 chuyến taxi. Bạn đoán hãng tính cước theo công thức:
trong đó là phí mở cửa, là đơn giá mỗi km. Nhưng bạn không biết và . Dữ liệu cũng có nhiễu: kẹt xe, làm tròn, phụ phí.
Hàm mất mát là sai số bình phương trung bình: với mỗi cặp , tính tiền cước dự đoán cho từng chuyến, lấy chênh lệch so với cước thật, bình phương lên rồi lấy trung bình. Gradient descent sẽ tự tìm khiến con số này nhỏ nhất. Đoạn code dưới đây tạo dữ liệu giả lập với cước “thật” là 12 nghìn mở cửa cộng 15 nghìn mỗi km, rồi để thuật toán tự đoán:
import random
# Dữ liệu giả lập: 30 chuyến taxi. Cước thật = 12 nghìn mở cửa + 15 nghìn/km, cộng nhiễu (kẹt xe, làm tròn...)rng = random.Random(7)km = [round(rng.uniform(1, 20), 1) for _ in range(30)]fare = [12 + 15 * x + rng.gauss(0, 6) for x in km]n = len(km)
def loss(b, w):  # sai số bình phương trung bình    return sum((b + w * x - y) ** 2 for x, y in zip(km, fare)) / n
b, w, lr = 0.0, 0.0, 0.005          # bắt đầu từ 0; lr là tốc độ họcfor step in range(1, 5001):    err = [b + w * x - y for x, y in zip(km, fare)]    grad_b = 2 * sum(err) / n                               # đạo hàm của loss theo b    grad_w = 2 * sum(e * x for e, x in zip(err, km)) / n    # đạo hàm của loss theo w    b, w = b - lr * grad_b, w - lr * grad_w                 # bước xuống dốc    if step in (1, 10, 100, 1000, 5000):        print(f"bước {step:>6}: mở cửa {b:6.2f} nghìn, đơn giá {w:5.2f} nghìn/km, loss {loss(b, w):8.2f}")
# Đối chiếu với công thức chính xác của hồi quy tuyến tính (bình phương nhỏ nhất)mx, my = sum(km) / n, sum(fare) / nw_ols = sum((x - mx) * (y - my) for x, y in zip(km, fare)) / sum((x - mx) ** 2 for x in km)print(f"công thức chính xác: mở cửa {my - w_ols * mx:6.2f} nghìn, đơn giá {w_ols:5.2f} nghìn/km")
bước 1: mở cửa 1.38 nghìn, đơn giá 16.07 nghìn/km, loss 77.28bước 10: mở cửa 1.67 nghìn, đơn giá 15.74 nghìn/km, loss 65.76bước 100: mở cửa 4.41 nghìn, đơn giá 15.51 nghìn/km, loss 48.88bước 1000: mở cửa 12.83 nghìn, đơn giá 14.80 nghìn/km, loss 24.75bước 5000: mở cửa 13.48 nghìn, đơn giá 14.75 nghìn/km, loss 24.63công thức chính xác: mở cửa 13.48 nghìn, đơn giá 14.75 nghìn/kmSau 5.000 bước, gradient descent tìm ra phí mở cửa 13,48 nghìn và đơn giá 14,75 nghìn/km, trùng khớp với đáp án của công thức hồi quy tuyến tính. Con số không đúng bằng 12 và 15 vì dữ liệu có nhiễu: đây là cách giải thích dữ liệu tốt nhất có thể, chứ không phải “sự thật” đứng sau nó.
Với bài toán đường thẳng, ta có công thức giải trực tiếp nên không thật sự cần gradient descent. Nhưng với một mạng nơ-ron có hàng tỷ tham số và vô số lớp phi tuyến chồng lên nhau, không tồn tại công thức nào như vậy. Đi bộ xuống núi là cách duy nhất.
Thung lũng hẹp và dài
Nhìn kỹ kết quả in ra, có một điều lạ. Đơn giá gần đúng ngay sau một bước, còn phí mở cửa phải mất khoảng một nghìn bước. Tại sao hai tham số lại học với tốc độ chênh nhau như vậy?
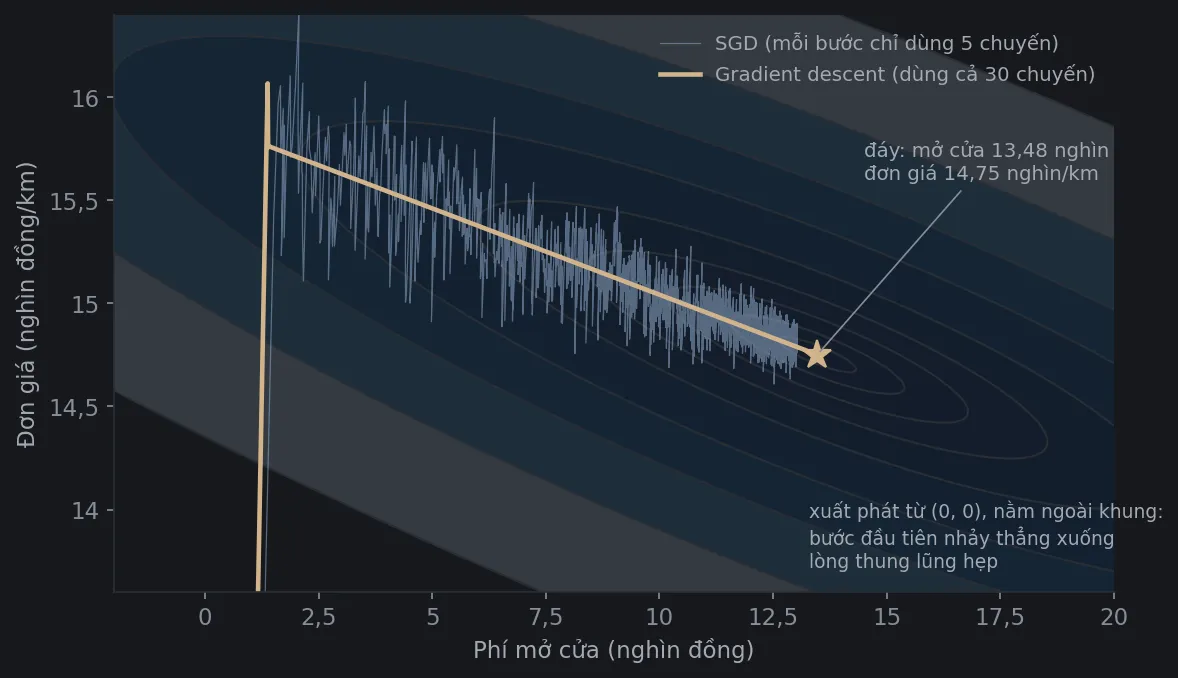
Hình 2 trả lời câu hỏi đó. Đó là bản đồ độ cao của hàm mất mát theo hai tham số, vẽ bằng các đường đồng mức như bản đồ địa hình. Hình dạng của nó không phải một cái bát tròn, mà là một thung lũng hẹp và dài.
Lý do nằm ở dữ liệu. Số km dao động từ 1 tới 20, nên chỉ cần đổi đơn giá một chút là tiền cước thay đổi rất nhiều: theo hướng đơn giá, sườn núi rất dốc. Còn phí mở cửa chỉ cộng thêm một khoản cố định: theo hướng này, sườn núi rất thoải. Gradient descent bước thẳng xuống theo hướng dốc, rơi ngay vào lòng thung lũng, rồi phải lê từng bước nhỏ dọc theo lòng thung lũng gần như bằng phẳng để tới đáy.
Không thể tăng tốc độ học cho nhanh hơn, vì theo hướng dốc, bước lớn sẽ khiến thuật toán văng ra như trường hợp ở trên. Đây là một vấn đề rất phổ biến trong thực tế, và có hai cách khắc phục thường dùng: chuẩn hóa dữ liệu để các hướng có độ dốc tương đương nhau, và dùng những biến thể thông minh hơn của gradient descent mà ta sẽ gặp ở phần sau.
Hàng tỷ chiều: lan truyền ngược
Với hai tham số, tính đạo hàm bằng tay rất dễ. Với một mạng nơ-ron gồm hàng chục lớp và hàng tỷ tham số, tính đạo hàm của hàm mất mát theo từng tham số nghe như một khối lượng công việc khổng lồ.
Lời giải đến từ quy tắc đạo hàm của hàm hợp (chain rule) trong giải tích. Một mạng nơ-ron là một chuỗi phép biến đổi nối tiếp nhau: đầu ra của lớp này là đầu vào của lớp sau. Ảnh hưởng của một tham số ở lớp đầu lên kết quả cuối cùng là tích của những ảnh hưởng nhỏ qua từng lớp. Nếu tính ngược từ cuối lên đầu, ta có thể dùng lại kết quả của các lớp phía sau để tính cho các lớp phía trước, thay vì tính lại từ đầu cho từng tham số.
Kỹ thuật này gọi là lan truyền ngược (backpropagation). Ý tưởng tính đạo hàm theo chiều ngược đã xuất hiện từ trước, nhưng bài báo năm 1986 của Rumelhart, Hinton và Williams trên tạp chí Nature đã cho thấy nó giúp mạng nơ-ron nhiều lớp học được những biểu diễn hữu ích, và làm nó trở nên phổ biến[3]. Nhờ lan truyền ngược, chi phí tính gradient cho toàn bộ tham số chỉ vào cỡ vài lần chi phí của một lượt tính dự đoán thông thường.
Gradient descent cho biết đi hướng nào. Lan truyền ngược cho biết hướng đó ở đâu, với chi phí chấp nhận được. Hai ý tưởng này gần như luôn đi cùng nhau.
Không cần nhìn hết dữ liệu: SGD
Còn một trở ngại nữa. Hàm mất mát là trung bình sai số trên toàn bộ dữ liệu huấn luyện. Với một mô hình ngôn ngữ, dữ liệu có thể là hàng nghìn tỷ từ. Tính gradient chính xác trên toàn bộ chỗ đó chỉ để đi một bước là quá đắt.
Giải pháp: mỗi bước chỉ lấy ngẫu nhiên một nhóm nhỏ dữ liệu (mini-batch), tính gradient trên nhóm đó, và bước theo nó. Gradient từ một nhóm nhỏ không chính xác, nhưng trung bình thì đúng hướng. Đây là stochastic gradient descent (SGD), gradient descent ngẫu nhiên. Nền tảng toán học của nó có thể lần về công trình năm 1951 của Robbins và Monro về phương pháp xấp xỉ ngẫu nhiên[4].
Trong Hình 2, đường màu xanh là SGD cho bài toán taxi, mỗi bước chỉ dùng 5 trong 30 chuyến. Nó lảo đảo, giật qua giật lại, nhưng vẫn đi về gần đáy. Và mỗi bước của nó rẻ hơn nhiều lần so với một bước dùng đủ dữ liệu.
Điều thú vị là phần “lảo đảo” này không hẳn là nhược điểm. Với những ngọn núi gồ ghề của mạng nơ-ron, chút nhiễu ngẫu nhiên có thể giúp thuật toán thoát khỏi những chỗ lõm nhỏ hay những vùng bằng phẳng mà gradient descent chính xác dễ bị mắc kẹt.
Địa hình của mạng nơ-ron
Hàm mất mát của bài toán taxi là một cái thung lũng đơn giản: chỉ có một đáy. Hàm mất mát của một mạng nơ-ron thì khác: nó sống trong không gian hàng tỷ chiều, với vô số đồi, hố và đèo.
Nỗi lo tự nhiên là thuật toán bị kẹt ở một cực tiểu cục bộ, một cái hố nhỏ trên sườn núi, tưởng là đáy nhưng không phải. Nghiên cứu của Dauphin và cộng sự năm 2014 gợi ý một bức tranh khác: trong không gian nhiều chiều, những điểm “phẳng” có sai số cao thường không phải hố, mà là điểm yên ngựa (saddle point): lõm theo một số hướng nhưng lồi theo những hướng khác, như yên ngựa hay một con đèo giữa hai ngọn núi[5]. Ở đó, gradient gần bằng 0, và thuật toán có thể chậm lại rất lâu dù vẫn còn đường đi xuống.
Hai cải tiến giúp gradient descent đi qua những địa hình như vậy:
- Momentum (quán tính): thay vì chỉ nhìn độ dốc tại chỗ, thuật toán nhớ hướng đi của những bước trước, như một quả bóng lăn xuống dốc tích lũy vận tốc. Quả bóng lăn qua được vùng bằng phẳng, và trong thung lũng hẹp như bài toán taxi, những dao động qua lại hai bên sườn triệt tiêu nhau còn chuyển động dọc lòng thung lũng được cộng dồn.
- Adam, do Kingma và Ba đề xuất năm 2014, kết hợp quán tính với việc tự điều chỉnh tốc độ học riêng cho từng tham số, dựa trên độ lớn của các gradient gần đây[6]. Tham số nào có gradient lớn và thất thường thì bước ngắn lại; tham số nào gradient nhỏ thì bước dài ra. Đó chính là liều thuốc cho căn bệnh “thung lũng hẹp và dài”. Adam và các biến thể của nó hiện là lựa chọn mặc định khi huấn luyện rất nhiều mô hình học sâu.
Dù có bao nhiêu cải tiến, cốt lõi vẫn là dòng công thức của Cauchy: tính độ dốc, bước ngược lại.
Tối ưu quá giỏi cũng là một cái bẫy
Gradient descent rất giỏi làm đúng việc được giao: tìm bộ tham số khiến hàm mất mát trên dữ liệu huấn luyện nhỏ nhất. Nhưng đó không phải điều ta thật sự muốn. Ta muốn mô hình hoạt động tốt trên dữ liệu nó chưa từng thấy.
Hai mục tiêu này có thể tách rời nhau. Một mô hình đủ lớn có thể học thuộc lòng cả những chi tiết ngẫu nhiên của dữ liệu huấn luyện, như việc chuyến taxi thứ 17 tình cờ bị kẹt xe. Hiện tượng này gọi là quá khớp (overfitting): hàm mất mát trên dữ liệu huấn luyện rất thấp, nhưng mô hình dự đoán kém khi gặp dữ liệu mới.
Vì vậy, trong thực tế người ta luôn giữ riêng một phần dữ liệu để kiểm tra, không bao giờ dùng để huấn luyện. Khi sai số trên phần kiểm tra bắt đầu tăng trong khi sai số huấn luyện vẫn giảm, đó là dấu hiệu nên dừng lại. Ngọn núi mà gradient descent leo xuống chỉ là một bản đồ gần đúng của thế giới thật, và đi xuống quá sâu trên tấm bản đồ ấy có thể đưa ta ra xa thực tế.
Mỗi bước xuống núi đều tốn điện
Trên giấy, gradient descent chỉ là một dòng công thức. Trên thực tế, với một mô hình lớn, mỗi bước là một lượt tính toán trên hàng nghìn GPU, và quá trình huấn luyện có thể gồm hàng trăm nghìn bước kéo dài nhiều tuần. Theo báo cáo của nhóm tác giả, huấn luyện GPT-3 cần khoảng phép tính dấu phẩy động[2], và các mô hình ra đời sau đó còn lớn hơn nhiều.
Đó là lý do việc huấn luyện AI gắn liền với câu chuyện điện năng, làm mát và lưới điện trong bài AI không chỉ cần chip. Mỗi cải tiến giúp gradient descent tới đáy nhanh hơn vài phần trăm, ở quy mô này, có nghĩa là tiết kiệm hàng nghìn giờ GPU.
Một thuật toán từ năm 1847
Quay lại câu hỏi đầu bài: làm sao chọn được 175 tỷ con số?
Câu trả lời không phải một thuật toán thông minh đến mức nhìn thấy đáp án. Nó là một quy trình rất khiêm tốn: đứng ở chỗ hiện tại, đo độ dốc, bước một bước nhỏ xuống dưới, và lặp lại hàng trăm nghìn lần. Lan truyền ngược giúp đo độ dốc nhanh. SGD giúp mỗi bước rẻ. Momentum và Adam giúp đi qua những địa hình khó. Dữ liệu kiểm tra nhắc ta biết khi nào nên dừng.
Gradient descent không đứng một mình. Kiến trúc mô hình, dữ liệu và phần cứng đều quan trọng không kém. Nhưng gần như mọi mô hình AI hiện đại, từ nhận dạng ảnh tới các mô hình ngôn ngữ lớn, đều được huấn luyện bằng gradient descent hoặc một biến thể của nó. Ý tưởng của Cauchy gần hai thế kỷ trước vẫn đang chạy, hàng tỷ lần mỗi giây, trong những trung tâm dữ liệu lớn nhất thế giới.
Tài liệu tham khảo
- [1]Augustin-Louis Cauchy. Méthode générale pour la résolution des systèmes d'équations simultanées. Comptes Rendus de l'Académie des Sciences, 25, 536–538, 1847.
- [2]Tom B. Brown và cộng sự. Language Models are Few-Shot Learners. arXiv:2005.14165, 2020.
- [3]David E. Rumelhart, Geoffrey E. Hinton và Ronald J. Williams. Learning representations by back-propagating errors. Nature, 323, 533–536, 1986.
- [4]Herbert Robbins và Sutton Monro. A Stochastic Approximation Method. The Annals of Mathematical Statistics, 22(3), 400–407, 1951.
- [5]Yann Dauphin và cộng sự. Identifying and attacking the saddle point problem in high-dimensional non-convex optimization. arXiv:1406.2572, 2014.
- [6]Diederik P. Kingma và Jimmy Ba. Adam: A Method for Stochastic Optimization. arXiv:1412.6980, 2014.