Binary search: từ trò đoán số đến index trong database
Ba mươi lần so sánh là đủ để tìm một dòng trong một tỷ dòng. Nhưng database không dùng binary search theo cách sách giáo khoa dạy: nó dùng B-tree, một cây được thiết kế để mỗi bước nhảy là một lần đọc đĩa chứ không phải một phép so sánh.
Mục lục
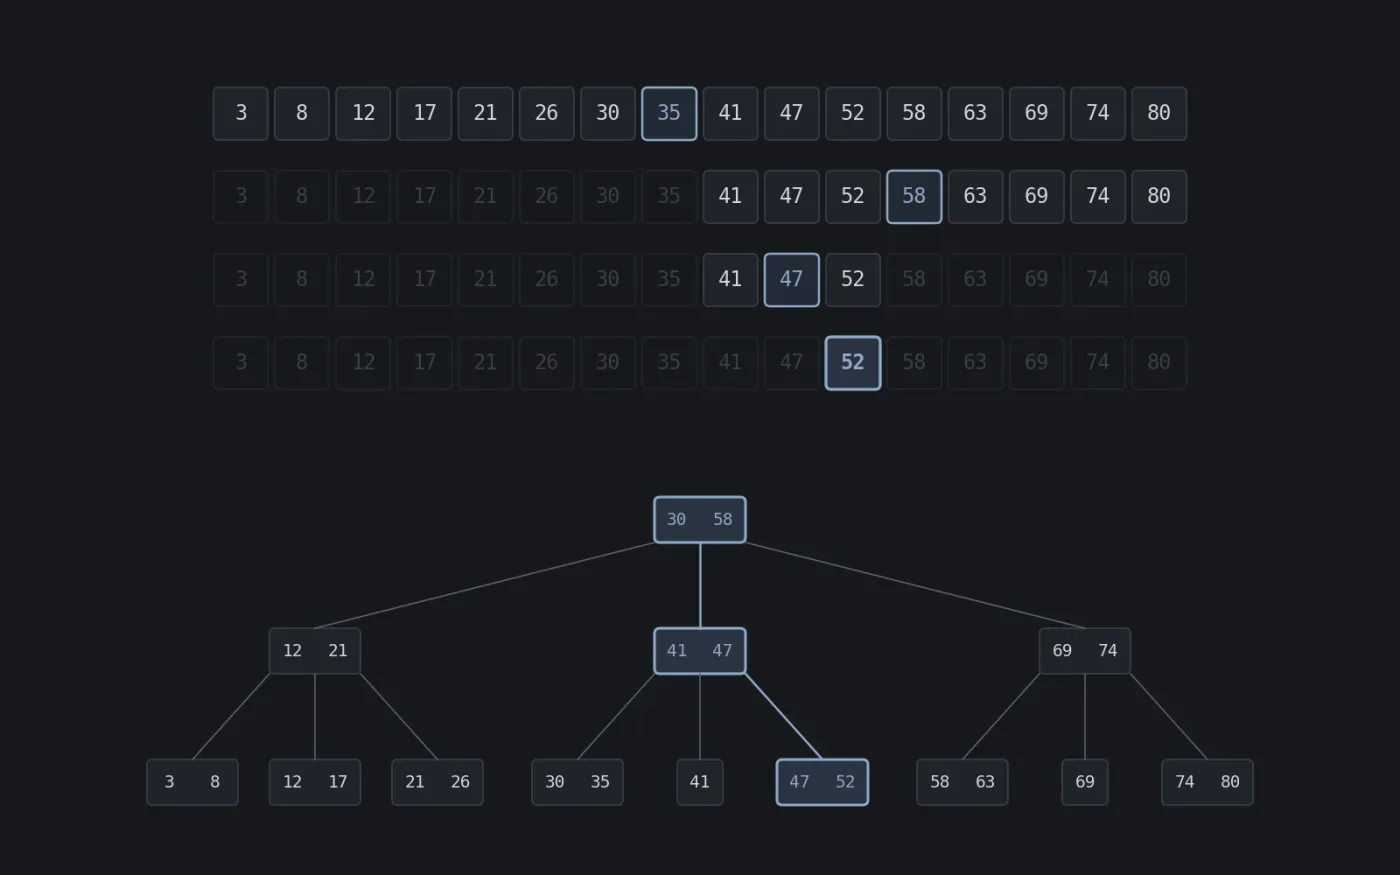
Tôi nghĩ một số từ 1 đến 100, bạn đoán, tôi chỉ trả lời “lớn hơn” hoặc “nhỏ hơn”. Người chơi lần đầu thường đoán bừa: 37, rồi 80, rồi 52. Người chơi có kinh nghiệm luôn bắt đầu bằng 50, rồi 25 hoặc 75, mỗi lần loại đi một nửa số khả năng còn lại. Họ không bao giờ cần quá 7 lần đoán.
Cách chơi ấy có tên là binary search (tìm kiếm nhị phân). Nó có lẽ là thuật toán đầu tiên mà sinh viên ngành máy tính được học, và cũng là thuật toán chạy âm thầm sau mỗi câu SELECT ... WHERE id = 42 mà bạn gửi cho database. Nhưng database không dùng nó theo đúng cách sách giáo khoa dạy. Bài này đi từ trò đoán số tới chỗ đó, và giải thích vì sao.
Chia đôi, rồi chia đôi nữa
Binary search chỉ cần một điều kiện: dữ liệu đã được sắp xếp. Muốn tìm khoá trong mảng có phần tử:
- Nhìn phần tử ở giữa vùng đang xét.
- Nếu nó nhỏ hơn , thì (nếu có) chỉ có thể nằm ở nửa bên phải. Bỏ nửa trái.
- Ngược lại, bỏ nửa phải.
- Lặp lại tới khi vùng đang xét không còn gì.
Mỗi bước loại một nửa, nên sau bước chỉ còn phần tử. Vùng tìm kiếm co về một phần tử khi , tức là sau khoảng
bước. Con số này tăng chậm đến mức khó tin:
| Số phần tử | Quét lần lượt (trung bình) | Binary search (tối đa) |
|---|---|---|
| 100 | 50 | 7 |
| 1.000.000 | 500.000 | 20 |
| 1.000.000.000 | 500.000.000 | 30 |
| 8 tỷ (dân số thế giới) | 4 tỷ | 33 |
Tăng dữ liệu lên một nghìn lần chỉ tốn thêm khoảng 10 bước, vì . Đây là lý do mọi hệ thống lưu trữ đều cố giữ dữ liệu ở dạng có thứ tự bằng cách này hay cách khác: thứ tự biến một bài toán tuyến tính thành một bài toán logarit.
Thuật toán đơn giản nhất mà ai cũng viết sai
Nghe đơn giản như vậy, nhưng binary search nổi tiếng là khó viết đúng. Trong cuốn Programming Pearls, Jon Bentley kể rằng ông giao bài này cho các lập trình viên chuyên nghiệp trong những khoá học của mình, cho họ thời gian thoải mái, và chỉ khoảng một phần mười nộp được chương trình đúng[1].
Lỗi thường gặp nằm ở các biên: vòng lặp chạy thêm một lần hoặc thiếu một lần, cập nhật hi = mid thay vì hi = mid - 1 khiến vòng lặp không bao giờ dừng, hoặc trả về sai vị trí khi khoá xuất hiện nhiều lần.
Lỗi nổi tiếng nhất thì tinh vi hơn. Năm 2006, Joshua Bloch, người viết hàm binary search trong thư viện chuẩn của Java, công bố rằng hàm ấy đã có lỗi suốt chín năm[2]. Dòng gây lỗi là dòng tính điểm giữa, mid = (lo + hi) / 2. Khi mảng có hơn khoảng một tỷ phần tử, tổng lo + hi vượt quá giới hạn của số nguyên 32 bit () và bị tràn thành số âm. Cách sửa là viết mid = lo + (hi - lo) / 2. Bloch chỉ ra rằng chính phiên bản Bentley đã chứng minh là đúng trong Programming Pearls cũng mắc lỗi này: chứng minh đúng với số nguyên toán học, nhưng máy tính không dùng số nguyên toán học.
Phiên bản lower_bound quan trọng hơn phiên bản “tìm đúng giá trị”, vì nó trả lời được cả câu hỏi “nếu không có thì sẽ nằm ở đâu?”. Database cần đúng câu hỏi đó cho truy vấn khoảng, như ta sẽ thấy ở dưới.
Vì sao database không dùng thẳng một mảng sắp xếp?
Nếu binary search tốt như vậy, sao database không lưu bảng thành một file lớn đã sắp xếp theo khoá rồi tìm trên đó? Có hai lý do.
Lý do thứ nhất: thêm dữ liệu rất đắt. Chèn một dòng vào giữa một mảng sắp xếp nghĩa là dịch chuyển mọi dòng phía sau nó. Với một tỷ dòng, mỗi lần INSERT có thể phải ghi lại hàng trăm megabyte.
Lý do thứ hai, và quan trọng hơn: đĩa không đọc từng dòng. Database đọc và ghi theo đơn vị page (trang), một khối có kích thước cố định: 8 KB với PostgreSQL[5], 16 KB mặc định với InnoDB của MySQL[7]. Để so sánh với dòng thứ mid, database phải đọc cả page chứa dòng ấy. Và mỗi bước binary search nhảy tới một vị trí cách xa vị trí trước, nên gần như mỗi bước là một page khác, tức là một lần đọc ngẫu nhiên từ đĩa.
Phép so sánh trong RAM tốn vài nano giây. Một lần đọc ngẫu nhiên từ SSD tốn cỡ một trăm micro giây, và từ ổ cứng quay tốn cỡ mười mili giây (đây là các bậc độ lớn để minh hoạ, máy cụ thể sẽ khác). Nghĩa là đọc đĩa chậm hơn so sánh hàng chục nghìn tới hàng triệu lần. Với database, thứ cần đếm không phải là số phép so sánh, mà là số page phải đọc.
Hình 1 đếm đúng con số ấy cho ba cách tìm một dòng, với giả định mỗi page chứa 100 dòng:
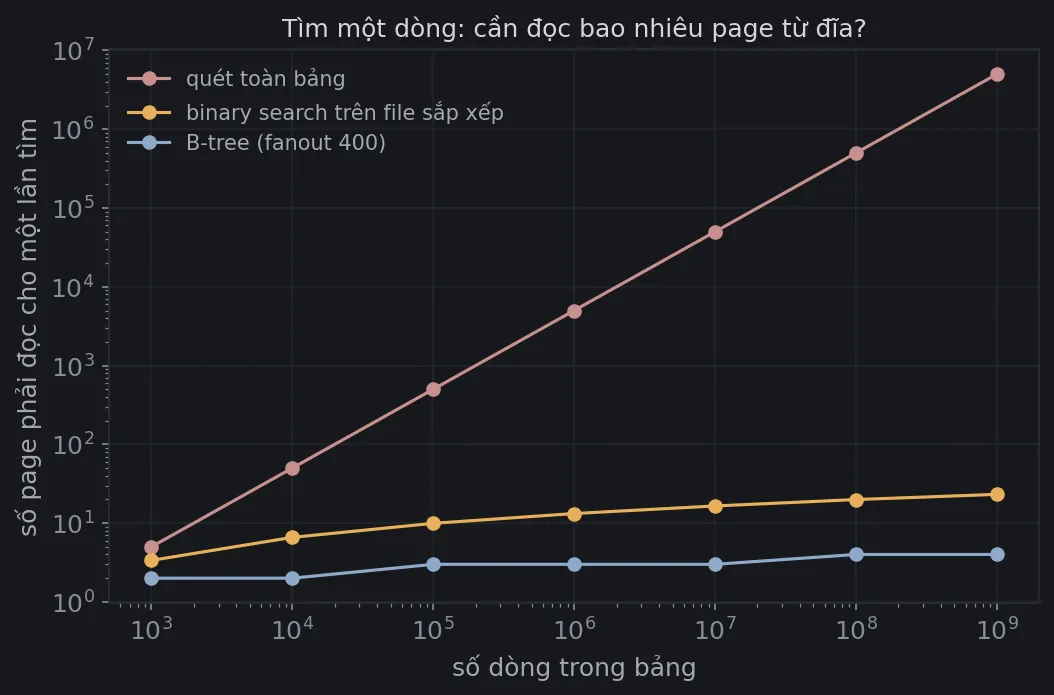
Với một tỷ dòng, binary search trên file sắp xếp đọc khoảng 23 page. Chỉ vài bước cuối, khi vùng tìm kiếm đã thu nhỏ vào trong một page, là không tốn thêm lần đọc nào. Còn B-tree chỉ cần 4 page.
B-tree: chia trăm, thay vì chia đôi
B-tree được Rudolf Bayer và Edward McCreight công bố đầu những năm 1970[3]. Tới cuối thập niên ấy, một bài tổng quan đã gọi nó là cấu trúc “có mặt ở khắp nơi” (ubiquitous)[4], và đến nay nó vẫn là index mặc định của PostgreSQL, MySQL, SQLite, Oracle, SQL Server.
Ý tưởng cốt lõi rất gần với binary search. Binary search mỗi bước chia vùng tìm kiếm làm hai, và mỗi bước tốn một lần đọc đĩa. Vậy nếu mỗi lần đọc đĩa đằng nào cũng lấy về cả một page 8 KB, sao không tận dụng hết page ấy để chia vùng tìm kiếm làm vài trăm phần?
Mỗi node của B-tree là một page. Một node trong chứa vài trăm khoá đã sắp xếp, xen giữa là con trỏ tới các node con: mọi khoá nhỏ hơn khoá đầu tiên nằm ở nhánh thứ nhất, mọi khoá nằm giữa khoá thứ nhất và thứ hai nằm ở nhánh thứ hai, và cứ thế. Tầng dưới cùng là các lá, chứa dữ liệu thật (hoặc con trỏ tới dòng dữ liệu).
Số nhánh mỗi node gọi là fanout, ký hiệu . Một cây cao tầng chứa được khoảng khoá, nên muốn chứa khoá chỉ cần
tầng. Với thì , nên chiều cao giảm gần chín lần so với cây nhị phân. Một tỷ dòng chỉ cần bốn tầng.
Còn một chi tiết khiến con số thực tế nhỏ hơn nữa. Bốn tầng ấy không đều nhau: tầng gốc chỉ có một page, tầng thứ hai vài chục page, tầng thứ ba vài chục nghìn page. Ba tầng trên cộng lại chỉ khoảng 200 MB với page 8 KB, đủ nằm gọn trong bộ nhớ đệm của database. Trong thực tế, tìm một dòng giữa một tỷ dòng thường chỉ tốn một hoặc hai lần đọc đĩa thật sự.
Binary search vẫn ở đó, bên trong mỗi page
B-tree không thay thế binary search. Nó chỉ dời binary search vào đúng chỗ rẻ nhất: bên trong một page đã nằm trong RAM. Khi tới một node, database cần tìm xem khoá cần tìm rơi vào nhánh nào trong vài trăm nhánh, và nó làm việc đó bằng binary search trên các khoá của node.
- PostgreSQL làm việc này trong hàm
_bt_binsrch. Hàm trả về vị trí đầu tiên có khoá khoá cần tìm, tức đúng làlower_bound, với bất biến được ghi ngay trong comment[6]. - InnoDB dùng một biến thể. Các dòng trong page được nối thành danh sách liên kết theo thứ tự khoá, và cuối page có một “thư mục” (page directory) gồm các ô, mỗi ô quản lý khoảng 4 tới 8 dòng. InnoDB binary search trên thư mục để tìm đúng nhóm, rồi đi tuần tự vài dòng trong nhóm[8]. Cách này làm cho việc chèn rẻ hơn: hầu hết lần chèn không phải dịch chuyển gì trong thư mục.
Điều thú vị là tổng số phép so sánh hầu như không đổi. Binary search trên một tỷ dòng cần khoảng 30 phép so sánh. B-tree bốn tầng, mỗi tầng binary search trên vài trăm khoá, cũng tốn khoảng 30 phép so sánh. B-tree không giảm số phép so sánh, nó giảm số lần đọc đĩa. Trong thế giới mà một lần đọc đĩa đắt bằng hàng nghìn phép so sánh, đó là thứ duy nhất đáng tối ưu.
Thêm dữ liệu mà không dịch chuyển cả bảng
B-tree cũng giải quyết lý do thứ nhất. Mỗi page lá được để trống một phần. Chèn một dòng mới chỉ cần sắp lại bên trong một page. Khi page đầy, nó được tách đôi (split) thành hai page, mỗi page đầy một nửa, và node cha nhận thêm một khoá. Nếu node cha cũng đầy thì tách tiếp lên trên. Cây luôn cân bằng (mọi lá cùng độ sâu) mà mỗi lần chèn chỉ chạm tới vài page.
Truy vấn khoảng và những gì index không làm được
Hiểu index là “binary search trên dữ liệu có thứ tự” giúp trả lời rất nhiều câu hỏi thực tế về hiệu năng SQL.
Truy vấn khoảng. Với WHERE created_at BETWEEN '2026-09-01' AND '2026-09-30', database dùng lower_bound để xuống lá chứa dòng đầu tiên 2026-09-01, rồi đi ngang dọc theo các lá (các lá B-tree được nối với nhau theo thứ tự) cho tới khi gặp giá trị vượt quá 2026-09-30. Chi phí là vài page để định vị cộng với số page chứa kết quả. ORDER BY created_at LIMIT 20 cũng rẻ theo cùng lý do: dữ liệu đã sắp xếp sẵn trong index.
Index ghép và quy tắc “tiền tố bên trái”. Index trên (last_name, first_name) sắp xếp như danh bạ điện thoại: theo họ trước, cùng họ thì theo tên. Tìm “Nguyễn Văn An” hay mọi người họ “Nguyễn” đều là binary search trên một vùng liên tục. Nhưng tìm mọi người tên “An” thì không được: những người tên An nằm rải rác khắp danh bạ, không tạo thành một vùng liên tục để chia đôi. Vì vậy thứ tự cột trong index ghép quan trọng: cột hay được lọc bằng dấu = nên đứng trước.
LIKE và hàm trên cột. WHERE email LIKE 'an%' dùng được index, vì mọi email bắt đầu bằng an nằm liền nhau trong thứ tự. WHERE email LIKE '%@gmail.com' thì không, vì phần đuôi không quyết định thứ tự. Tương tự, WHERE lower(email) = '...' không dùng được index trên email: index được sắp theo email chứ không theo lower(email). Muốn vậy cần tạo index trên chính biểu thức đó.
LSM-tree: binary search trên những file không bao giờ sửa
B-tree sửa page ngay tại chỗ, điều này tốn kém khi hệ thống phải ghi rất nhiều. Các database tối ưu cho ghi như RocksDB, Cassandra hay ScyllaDB dùng một ý tưởng khác: LSM-tree (log-structured merge-tree)[9].
Dữ liệu mới được ghi vào một bảng trong RAM. Khi bảng đầy, nó được đổ xuống đĩa thành một file đã sắp xếp và không bao giờ sửa nữa (thường gọi là SSTable). Theo thời gian, các file nhỏ được gộp (compaction) thành file lớn hơn, cũng đã sắp xếp. Mỗi file có một index thưa ở cuối, lưu khoá đầu tiên của mỗi khối dữ liệu.
Tìm một khoá trong một SSTable lại chính là binary search: tìm trên index thưa để biết khoá nằm ở khối nào, rồi đọc đúng khối ấy. Vì có nhiều file, một lần tìm có thể phải hỏi nhiều file. Để tránh chuyện đó, mỗi file thường kèm một bộ lọc Bloom, một cấu trúc xác suất trả lời được câu hỏi “khoá này chắc chắn không có trong file” mà không cần đọc file. Đó là câu chuyện cho một bài khác.
Tự tay đếm số page
Đoạn Python dưới đây tạo ra Hình 1. Nó mô phỏng một bảng có dòng, dòng thứ mang khoá , mỗi page chứa 100 dòng. Với binary search, nó chạy 1000 lần tìm khoá ngẫu nhiên và đếm số page khác nhau mà mỗi lần phải chạm vào. Với B-tree, nó dựng cây từ dưới lên và đếm số tầng. Chỉ cần cài matplotlib.
Các tham số (100 dòng mỗi page, 400 nhánh mỗi node) là ước lượng hợp lý cho page 8 KB, không phải số đo của một database cụ thể. Bạn có thể đổi ROWS_PER_PAGE hoặc FANOUT để xem đường B-tree thay đổi ra sao.
import random
import matplotlib.pyplot as plt
plt.rcParams.update({"figure.facecolor": "#16181c", "axes.facecolor": "#16181c", "text.color": "#d4d7dc",                     "axes.edgecolor": "#2a2e35", "xtick.color": "#878d97", "ytick.color": "#878d97", "font.size": 12})random.seed(2026)  # Cố định seed để chạy lại ra cùng kết quả.
ROWS_PER_PAGE = 100   # số dòng vừa một page 8 KB (ước lượng, dòng khoảng 80 byte)FANOUT = 400          # số con của một node B-tree (khoá + con trỏ khoảng 20 byte)

def binary_search_pages(n, key):    """Binary search trên một file đã sắp xếp. Dòng thứ i có khoá 2i.    Trả về (số phép so sánh, số page khác nhau phải đọc từ đĩa)."""    lo, hi = 0, n    compares, pages = 0, set()    while lo < hi:        mid = lo + (hi - lo) // 2          # không viết (lo + hi) // 2: tránh tràn số ở ngôn ngữ khác        pages.add(mid // ROWS_PER_PAGE)    # dòng mid nằm ở page nào        compares += 1        if 2 * mid < key:            lo = mid + 1        else:            hi = mid    return compares, len(pages)

def btree_height(n):    """Dựng B-tree từ dưới lên: lá chứa dòng, mỗi tầng trên gom FANOUT node tầng dưới.    Một lần tìm đọc đúng một page ở mỗi tầng, nên số page = số tầng."""    nodes, height = -(-n // ROWS_PER_PAGE), 1    while nodes > 1:        nodes, height = -(-nodes // FANOUT), height + 1    return height

sizes = [10**k for k in range(3, 10)]scan, bsearch, btree = [], [], []print(f"{'số dòng':>14} {'quét':>12} {'so sánh':>8} {'binary search':>14} {'B-tree':>7}")for n in sizes:    trials = [binary_search_pages(n, 2 * random.randrange(n)) for _ in range(1000)]    cmp_avg = sum(c for c, _ in trials) / len(trials)    pages_avg = sum(p for _, p in trials) / len(trials)    scan.append(n / ROWS_PER_PAGE / 2)     # trung bình quét nửa bảng mới gặp dòng cần tìm    bsearch.append(pages_avg)    btree.append(btree_height(n))    print(f"{n:>14,} {scan[-1]:>12,.0f} {cmp_avg:>8.1f} {pages_avg:>14.1f} {btree[-1]:>7}")
# Vẽ: số page phải đọc theo số dòng, cả hai trục thang log.fig, ax = plt.subplots(figsize=(8, 4.8))ax.plot(sizes, scan, "o-", color="#c98f8f", ms=6, label="quét toàn bảng")ax.plot(sizes, bsearch, "o-", color="#e8b05a", ms=6, label="binary search trên file sắp xếp")ax.plot(sizes, btree, "o-", color="#8fa9c9", ms=6, label=f"B-tree (fanout {FANOUT})")ax.set_xscale("log")ax.set_yscale("log")ax.set_xlabel("số dòng trong bảng", color="#a4a9b2")ax.set_ylabel("số page phải đọc cho một lần tìm", color="#a4a9b2")ax.grid(color="#22262c")ax.legend(frameon=False, labelcolor="#a4a9b2", fontsize=10, loc="upper left")ax.set_title("Tìm một dòng: cần đọc bao nhiêu page từ đĩa?", color="#d4d7dc", fontsize=12)fig.savefig("page-reads.png", dpi=150, bbox_inches="tight")
số dòng quét so sánh binary search B-tree 1,000 5 10.0 3.4 2 10,000 50 13.4 6.6 2 100,000 500 16.7 9.9 3 1,000,000 5,000 19.9 13.2 3 10,000,000 50,000 23.3 16.5 3 100,000,000 500,000 26.7 19.9 4 1,000,000,000 5,000,000 29.9 23.2 4Cột “so sánh” khớp với : 10 phép so sánh cho một nghìn dòng, 30 cho một tỷ dòng. Cột “binary search” luôn nhỏ hơn khoảng , vì vài bước cuối rơi vào cùng một page. Và cột “B-tree” gần như đứng yên: từ một nghìn tới một tỷ dòng, số page chỉ tăng từ 2 lên 4.
Một ý tưởng, nhiều tầng
Binary search dạy ta rằng thứ tự là một thứ quý giá: giữ được dữ liệu có thứ tự thì tìm kiếm chỉ còn là logarit. B-tree thêm một bài học về system design: hãy đếm đúng thứ đắt nhất. Sách giáo khoa đếm phép so sánh, nhưng database đếm lần đọc đĩa, và khi đổi thứ cần đếm, thuật toán tốt nhất cũng đổi theo, từ chia đôi thành chia vài trăm.
Lần tới khi một truy vấn chạy chậm và EXPLAIN báo Seq Scan, hãy tự hỏi: các dòng mình cần có nằm liền nhau trong một thứ tự nào đó không? Nếu có, thì một index trên đúng thứ tự ấy sẽ biến hàng triệu lần đọc thành vài lần. Nếu không, thì không index nào cứu được câu truy vấn đó.
Tài liệu tham khảo
- [1]Jon Bentley. Programming Pearls (ấn bản thứ 2), Column 4: Writing Correct Programs. Addison-Wesley, 2000.
- [2]Joshua Bloch. Extra, Extra - Read All About It: Nearly All Binary Searches and Mergesorts are Broken. Google Research Blog, 2006.
- [3]R. Bayer và E. McCreight. Organization and Maintenance of Large Ordered Indexes. Acta Informatica, 1(3), 173–189, 1972.
- [4]Douglas Comer. The Ubiquitous B-Tree. ACM Computing Surveys, 11(2), 121–137, 1979.
- [5]Database Page Layout. PostgreSQL Documentation.
- [6]nbtsearch.c — tìm kiếm trong B-tree của PostgreSQL (hàm _bt_binsrch). PostgreSQL Source Code.
- [7]InnoDB Startup Options and System Variables — innodb_page_size. MySQL 8.4 Reference Manual.
- [8]page0page.ic — page directory của InnoDB. MySQL Server Source Code Documentation.
- [9]P. O'Neil, E. Cheng, D. Gawlick và E. O'Neil. The Log-Structured Merge-Tree (LSM-Tree). Acta Informatica, 33(4), 351–385, 1996.