Bloom filter: vì sao web biết ngay tên đã có người dùng?
Bloom filter là gì: vài bit trả lời "chắc chắn chưa có" hay "có thể có". Cách nó chạy, Akamai và Cassandra dùng ra sao, chọn kích thước, khi nào không nên dùng.
Mục lục
Bạn gõ một tên đăng nhập mới, và gần như ngay lập tức trang web báo: “Tên này đã có người sử dụng”. Trong khi đó, hệ thống có thể đang giữ hàng trăm triệu tài khoản. Một trong những cách để trả lời nhanh như vậy mà không phải lục cả database mỗi lần bạn gõ một chữ là Bloom filter (bộ lọc Bloom).
Bloom filter là gì? Nó là một cấu trúc dữ liệu cực nhỏ, chỉ gồm một dãy bit 0 và 1, trả lời câu hỏi “phần tử này đã có trong tập hợp chưa?” bằng một trong hai câu: “chắc chắn chưa có” hoặc “có thể có”. Nó không bao giờ sai ở câu thứ nhất, và thỉnh thoảng sai ở câu thứ hai. Đổi lại sự “thỉnh thoảng sai” ấy, nó chỉ tốn khoảng 10 bit cho mỗi phần tử, bất kể phần tử dài bao nhiêu: 100 triệu tên đăng nhập gói gọn trong khoảng 120 MB, vừa trong RAM của một chiếc điện thoại.
Nửa đầu bài không cần biết lập trình: nó kể Bloom filter hoạt động ra sao, vì sao một câu trả lời “có thể” lại hữu ích, và những công ty như Akamai, Google hay Cassandra dùng nó vào việc gì. Nửa sau dành cho người muốn đi sâu: chọn kích thước thế nào, công thức xác suất, cách trả lời trong phỏng vấn system design, và một đoạn code tự kiểm chứng.
Bloom filter hoạt động như thế nào?
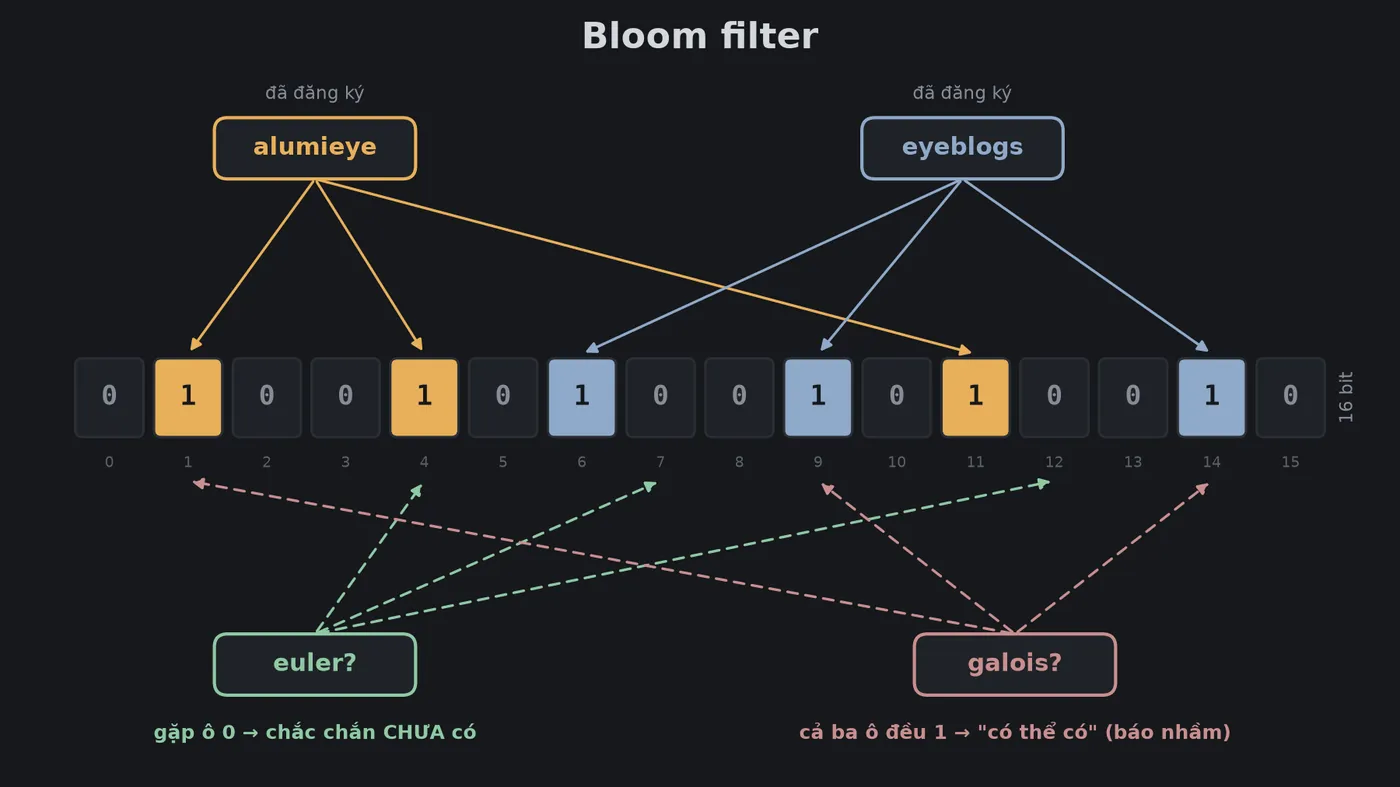
Hãy hình dung một bức tường có 16 công tắc đèn, ban đầu đều tắt. Bạn có một cái “máy xay tên”: cho một cái tên vào, nó luôn chỉ ra đúng ba công tắc, và cùng một tên thì luôn ra cùng ba công tắc. Trong máy tính, cái máy xay ấy gọi là hàm băm (hash function), một phép tính biến bất kỳ chuỗi chữ nào thành một con số trông như ngẫu nhiên.
Thêm một tên: cho tên vào máy xay, bật ba công tắc nó chỉ ra. Công tắc nào đã bật rồi thì để nguyên. Trong ảnh đầu bài, tên alumieye bật các ô 1, 4, 11; tên eyeblogs bật các ô 6, 9, 14.
Hỏi một tên: cho tên vào máy xay, nhìn ba công tắc nó chỉ ra.
- Nếu có ít nhất một công tắc đang tắt, tên này chắc chắn chưa từng được thêm. Vì nếu đã thêm, cả ba công tắc của nó đã phải bật. Tên
eulerrơi vào trường hợp này. - Nếu cả ba đều đang bật, tên này có thể đã được thêm. Nhưng cũng có thể ba công tắc ấy do những tên khác bật hộ. Tên
galoischưa bao giờ được thêm, nhưng ô 1 doalumieyebật, ô 9 và 14 doeyeblogsbật. Bộ lọc báo nhầm: “có thể có”.
Lần báo nhầm ấy gọi là dương tính giả (false positive). Chiều ngược lại, âm tính giả (bộ lọc nói “chưa có” trong khi thực ra đã có) thì không bao giờ xảy ra, vì công tắc chỉ được bật chứ không bao giờ bị tắt.
Bộ lọc không lưu chính cái tên. Nó chỉ lưu những công tắc đã bật. Vì thế nó nhỏ đến kinh ngạc, và cũng vì thế nó không thể nói chắc chắn điều gì “có”.
Một câu trả lời “có thể” thì dùng được vào việc gì?
Bí quyết là không bao giờ dùng Bloom filter một mình. Nó đứng gác trước một nơi chậm và đắt, thường là database trên ổ đĩa hoặc một dịch vụ ở xa:
- Có câu hỏi. Hỏi Bloom filter trước, trong RAM, mất chưa tới một micro giây.
- Bloom filter nói “chắc chắn chưa có”: trả lời luôn, không cần làm gì thêm.
- Bloom filter nói “có thể có”: lúc này mới hỏi database để biết chắc.
Với bộ lọc sai 1%, cứ 100 câu hỏi về tên chưa tồn tại thì chỉ khoảng 1 câu bị chuyển nhầm xuống database. 99 câu còn lại được trả lời ngay trong RAM. Sai số không làm kết quả cuối sai, nó chỉ làm tốn thêm một ít việc. Đó là lý do một cấu trúc “thỉnh thoảng sai” lại được dùng trong những hệ thống cần đúng tuyệt đối.
Với tên đăng nhập, Redis, một cơ sở dữ liệu trong RAM rất phổ biến, mô tả đúng cách làm này: bộ lọc nói “chưa có” thì cho tạo tài khoản luôn, nói “có thể có” thì hỏi lại database chính hoặc đơn giản là mời người dùng chọn tên khác[2]. Lựa chọn thứ hai nghĩa là thỉnh thoảng một cái tên còn trống bị từ chối oan. Với tên đăng nhập, điều đó chấp nhận được. Với thẻ tín dụng bị báo mất, thì không.
Ý tưởng này cũ hơn Internet. Năm 1970, Burton Bloom viết bài báo gốc với một ví dụ về gạch nối từ: một từ điển 500.000 từ, trong đó 90% tách âm tiết được bằng vài quy tắc đơn giản, còn 10% phải tra một bảng nằm trên đĩa, mà đọc đĩa thời ấy rất chậm. Bloom đề xuất một bảng bit nhỏ trong bộ nhớ để biết ngay từ nào chắc chắn không cần tra đĩa[1]. Hơn nửa thế kỷ sau, các hệ thống vẫn dùng đúng mô hình ấy: lọc rẻ ở trước, kiểm tra đắt ở sau.
Bloom filter đang chạy ở đâu?
Database: đừng mở file nếu chắc chắn không có
Các database tối ưu cho việc ghi nhiều như Cassandra, RocksDB hay HBase lưu dữ liệu thành rất nhiều file đã sắp xếp trên đĩa, như bài binary search và index trong database đã kể ở phần LSM-tree. Tìm một khóa có thể phải hỏi lần lượt từng file, và mỗi lần hỏi là một lần đọc đĩa.
Vì vậy mỗi file kèm một Bloom filter nằm sẵn trong RAM. Trước khi đọc một file, database hỏi bộ lọc của nó. “Chắc chắn không có” thì bỏ qua file đó, không tốn một lần đọc đĩa nào. Cassandra mặc định để sai số 1% cho bộ lọc này, và cho phép chỉnh theo từng bảng để đổi RAM lấy độ chính xác[4].
Lợi ích lớn nhất rơi vào loại câu hỏi tưởng như vô ích: tìm thứ không tồn tại. Không có bộ lọc, câu hỏi về một khóa không có là câu hỏi đắt nhất, vì phải mở mọi file mới dám kết luận “không có”. Có bộ lọc, nó gần như miễn phí.
Akamai: ba phần tư nội dung chỉ được xem một lần
Akamai là một trong những mạng phân phối nội dung (CDN) lớn nhất thế giới: hàng trăm nghìn máy chủ đặt khắp nơi, lưu sẵn bản sao trang web, ảnh, video để người dùng tải từ máy gần nhất. Bình thường, máy chủ CDN lưu lại mọi thứ nó vừa phục vụ, phòng khi có người hỏi lại.
Khi phân tích nhật ký của một cụm 45 máy chủ trong hai ngày, các kỹ sư Akamai thấy trong khoảng 400 triệu đối tượng được truy cập, 74% chỉ được hỏi đúng một lần rồi không bao giờ nữa. Họ gọi chúng là “one-hit wonders”, những ca sĩ chỉ nổi một bài. Lưu chúng xuống đĩa chỉ tốn chỗ và đẩy những nội dung được xem nhiều ra ngoài[3].
Giải pháp là quy tắc “lần thứ hai mới lưu”, dùng Bloom filter để nhớ những gì đã từng được hỏi:
- Lần đầu một đối tượng được hỏi: bộ lọc nói “chưa có”. Phục vụ nhưng không lưu, chỉ ghi tên nó vào bộ lọc.
- Lần thứ hai: bộ lọc nói “có thể có”. Lúc này mới lưu xuống đĩa.
Thử nghiệm trên khoảng 47 máy chủ thật cho kết quả rõ ràng: tỷ lệ dữ liệu phục vụ được từ bộ nhớ đệm tăng từ khoảng 74% lên 83%, và số lần ghi đĩa giảm 44%, từ khoảng 10.200 xuống 5.700 lần mỗi giây[3]. Ở đây, báo nhầm chỉ có nghĩa là thỉnh thoảng một nội dung được lưu sớm một lần. Vô hại.
Trình duyệt: kiểm tra trang lừa đảo mà không gửi đi từng đường link
Những phiên bản Chrome đầu tiên cần kiểm tra mỗi đường link bạn mở có nằm trong danh sách trang lừa đảo, mã độc của Google hay không. Gửi mọi đường link về Google vừa chậm vừa lộ thông tin duyệt web. Vì vậy Chrome giữ một Bloom filter của danh sách đen ngay trên máy: phần lớn đường link được kết luận “chắc chắn an toàn” tại chỗ, chỉ những đường link bị báo “có thể có” mới được kiểm tra kỹ với máy chủ.
Đến khoảng năm 2011, Chrome thay Bloom filter bằng một cấu trúc khác tên là PrefixSet, tận dụng việc dữ liệu của danh sách đen rải đều để nén gọn hơn[5]. Đây là một bài học thường gặp: Bloom filter là lời giải tổng quát tốt, nhưng khi hiểu rõ dữ liệu của mình, đôi khi có lời giải tốt hơn.
Medium: dùng mười năm, rồi bỏ
Nền tảng viết blog Medium từng dùng Bloom filter cho các bộ lọc gợi ý bài: bỏ bài bạn đã đọc, bỏ bài của tác giả bạn đã tắt tiếng. Mỗi người dùng một bộ lọc, hỏi rất nhanh.
Năm 2025, đội kỹ sư Medium viết rằng họ gỡ bỏ các Bloom filter ấy, thay bằng truy vấn database trực tiếp theo từng người dùng, và chi phí cho phần lọc giảm khoảng 10 lần, hệ thống cũng dễ bảo trì hơn[6]. Bloom filter không sai. Chỉ là ở quy mô và cách dùng của Medium, chi phí duy trì hàng triệu bộ lọc, giữ chúng đồng bộ và dựng lại khi cần, đã lớn hơn cái lợi nó đem lại. Mục “Khi nào không nên dùng” ở dưới sẽ quay lại chuyện này.
Bloom filter cần bao nhiêu bộ nhớ?
Bloom filter có ba con số:
- : số phần tử định thêm vào (ví dụ 100 triệu tên).
- : số bit của bộ lọc.
- : số công tắc mỗi phần tử bật, tức số hàm băm.
Cách nghĩ dễ nhất là theo số bit cho mỗi phần tử, . Bảng dưới cho thấy cần bao nhiêu bit để đạt một mức sai số, với số hàm băm tốt nhất ở mỗi mức[2]:
| Tỷ lệ báo nhầm | Bit cho mỗi phần tử | Số hàm băm | Bộ nhớ cho 100 triệu tên |
|---|---|---|---|
| 10% | 4,8 | 3 | 60 MB |
| 1% | 9,6 | 7 | 120 MB |
| 0,1% | 14,4 | 10 | 180 MB |
| 0,01% | 19,2 | 13 | 240 MB |
Hai điều đáng để ý trong bảng.
Thứ nhất, độ dài của tên không quan trọng. Một tên đăng nhập 8 ký tự hay một đường link 200 ký tự đều tốn cùng số bit. Để so sánh, Redis ước tính một tập hợp thông thường tốn khoảng 192 bit cộng với độ dài của chính giá trị cho mỗi phần tử[2]. Với tên dài 12 ký tự, 100 triệu tên trong một tập hợp như vậy tốn khoảng 3,6 GB, gấp khoảng 30 lần Bloom filter sai số 1%.
Thứ hai, mỗi lần giảm sai số đi 10 lần chỉ tốn thêm khoảng 4,8 bit cho mỗi phần tử. Độ chính xác rất rẻ. Đi từ 1% xuống 0,01%, tức chính xác hơn 100 lần, chỉ làm bộ lọc lớn gấp đôi.
Vì sao bộ lọc “đầy” nhanh hơn bạn nghĩ
Với 10 bit cho mỗi tên và , mỗi tên bật 7 công tắc, nên 10 triệu tên “bật” tổng cộng 70 triệu lần trên 100 triệu công tắc. Trực giác nói khoảng 70% công tắc sẽ sáng. Thực tế chỉ khoảng 50%, vì rất nhiều lần bật rơi trúng công tắc đã sáng sẵn.
Đây là cùng một hiện tượng với nghịch lý ngày sinh: trong 23 người đã có 50% khả năng hai người trùng sinh nhật, vì số cặp tăng nhanh hơn số người. Va chạm đến sớm hơn trực giác. Và hóa ra trạng thái tốt nhất của Bloom filter chính là khi khoảng một nửa số bit đã bật: ít hơn thì đang phí bộ nhớ, nhiều hơn thì báo nhầm tăng vọt.
Hệ quả thực tế: bộ lọc phải được thiết kế cho số phần tử tối đa ngay từ đầu. Thêm vượt quá con số đó, tỷ lệ báo nhầm không tăng từ từ mà tăng rất nhanh. Bộ lọc thiết kế cho 1% khi bị nhồi gấp đôi số phần tử sẽ báo nhầm khoảng 14% (xem Hình 1 ở cuối bài).
Những điều Bloom filter không làm được
Không xóa được. Muốn xóa một tên, bạn phải tắt các công tắc của nó, nhưng những công tắc đó có thể đang được tên khác dùng chung. Tắt đi sẽ gây ra âm tính giả, đúng loại lỗi Bloom filter hứa không bao giờ mắc. Có hai cách sửa phổ biến. Counting Bloom filter thay mỗi bit bằng một bộ đếm nhỏ, tốn bộ nhớ gấp vài lần. Cuckoo filter (2014) lưu một “dấu vân tay” ngắn của mỗi phần tử thay vì bật bit, xóa được, và thường gọn hơn Bloom filter khi cần sai số rất thấp[7].
Không liệt kê được. Bộ lọc không lưu tên, nên không thể hỏi “đang có những tên nào”. Muốn dựng lại bộ lọc lớn hơn, bạn phải có danh sách gốc ở đâu đó.
Phải đoán trước kích thước. Như đã nói ở trên, nhồi quá số phần tử dự kiến thì sai số tăng vọt. Có hai cách lách. Redis tự xếp chồng thêm bộ lọc mới mỗi khi bộ cũ đầy, đổi lại câu hỏi phải đi qua nhiều tầng hơn[2]. Akamai dùng hai bộ lọc luân phiên: khi bộ chính đầy, nó thành bộ phụ, một bộ trống mới thành bộ chính, bộ phụ cũ bị bỏ. Cách này vừa giữ sai số thấp vừa tự “quên” những thứ đã lâu không ai hỏi[3].
Khi nào không nên dùng Bloom filter
- Dữ liệu đủ nhỏ để giữ nguyên trong RAM. Vài trăm nghìn phần tử thì một tập hợp bình thường đã đủ nhanh, lại chính xác tuyệt đối.
- Tra cứu phía sau đã rẻ. Nếu database đã có index tốt và trả lời trong một mili giây, thêm một tầng lọc chỉ thêm một thứ phải giữ đồng bộ. Đây đại khái là kết luận của Medium.
- Báo nhầm là không chấp nhận được và không có tầng kiểm tra lại phía sau.
- Dữ liệu thay đổi và bị xóa liên tục. Khi đó Cuckoo filter hoặc một cấu trúc khác hợp hơn.
Bloom filter trong phỏng vấn system design
Đến đây ta chuyển sang góc kỹ thuật. Bloom filter xuất hiện rất thường xuyên trong các câu hỏi phỏng vấn thiết kế hệ thống, thường không phải là câu hỏi chính mà là một mảnh ghép trong câu trả lời. Ba bài kinh điển:
- Web crawler: máy thu thập dữ liệu phải nhớ hàng tỷ đường link đã ghé để không ghé lại. Bloom filter đứng trước kho lưu đường link. Báo nhầm nghĩa là bỏ sót một vài trang chưa ghé, thường chấp nhận được.
- Kiểm tra tên đăng nhập hoặc mã giảm giá: đúng như ví dụ đầu bài.
- Hệ thống gợi ý: “người này đã xem nội dung này chưa?”. Báo nhầm nghĩa là thỉnh thoảng không gợi ý một nội dung lẽ ra nên gợi ý.
Một câu trả lời tốt thường đi qua năm bước:
- Nói rõ báo nhầm gây ra hậu quả gì trong bài toán này: tốn thêm một lần hỏi database, bỏ sót một trang, hay từ chối oan một người dùng. Đây là câu người phỏng vấn muốn nghe nhất.
- Ước lượng và chọn sai số , rồi tính bộ nhớ: bit, nghĩa là khoảng 10 bit cho 1%. Một tỷ đường link với 1% là khoảng 1,2 GB, đặt vừa trong RAM của một máy.
- Đặt bộ lọc ở đâu: trong bộ nhớ của từng máy chủ ứng dụng (nhanh nhất nhưng phải đồng bộ), hay ở một chỗ dùng chung như Redis (một bản duy nhất, thêm một lần gọi mạng). Đây là cùng câu hỏi “đếm ở đâu” như trong bài rate limiter và cửa sổ trượt.
- Dựng lại thế nào khi bộ lọc đầy hoặc khi máy khởi động lại: đọc lại danh sách gốc từ database, hoặc lưu định kỳ bộ lọc xuống đĩa.
- Nêu một phương án thay thế (Cuckoo filter khi cần xóa, tập hợp thường khi dữ liệu nhỏ) để cho thấy bạn biết giới hạn của nó.
Công thức tỷ lệ báo nhầm
Phần này dùng một chút xác suất. Ai chỉ quan tâm phần ứng dụng có thể bỏ qua.
Giả sử hàm băm chọn công tắc hoàn toàn ngẫu nhiên. Mỗi lần bật, xác suất một công tắc cụ thể không bị chọn là . Sau khi thêm phần tử, mỗi phần tử bật lần, tức tổng cộng lần bật, xác suất công tắc ấy vẫn tắt là:
Một tên chưa từng thêm bị báo nhầm khi cả công tắc của nó đều đang sáng:
Công thức cho thấy cuộc giằng co của . Tăng thì mỗi câu hỏi phải “trúng” nhiều công tắc hơn mới báo nhầm, nhưng đồng thời bộ lọc cũng sáng nhanh hơn. Tính đạo hàm sẽ thấy điểm cân bằng nằm ở:
Thay ngược lại, đúng lúc ấy : một nửa số công tắc đang sáng, đúng như đã nói ở phần trên. Tỷ lệ báo nhầm lúc đó là , và giải ra số bit cần cho mỗi phần tử:
Với , , nên cần khoảng bit cho mỗi phần tử và , đúng như bảng ở trên.
Còn một chi tiết triển khai: cần tới 7 hàm băm khác nhau sao? Không cần. Kirsch và Mitzenmacher chứng minh rằng chỉ cần hai giá trị băm , rồi tạo các vị trí với , mà tỷ lệ báo nhầm gần như không đổi[8]. Đoạn code dưới đây dùng đúng mẹo này.
Tự tay mô phỏng
Đoạn Python dưới đây viết một Bloom filter trong khoảng 20 dòng, rồi làm hai thí nghiệm. Thí nghiệm 1 giữ cố định bộ lọc 100.000 bit (12,5 KB) với , thêm dần tới 20.000 tên, và đo tỷ lệ báo nhầm trên 20.000 tên chưa từng thêm. Thí nghiệm 2 giữ cố định 10 bit cho mỗi tên, đổi số hàm băm từ 1 tới 15. Mỗi lần đo được đặt cạnh công thức lý thuyết ở mục trên. Chỉ cần cài matplotlib.
import hashlibimport math
import matplotlib.pyplot as plt
plt.rcParams.update({"figure.facecolor": "#16181c", "axes.facecolor": "#16181c", "text.color": "#d4d7dc",                     "axes.edgecolor": "#2a2e35", "xtick.color": "#878d97", "ytick.color": "#878d97", "font.size": 12})

class BloomFilter:    """Mảng m bit; mỗi phần tử bật k bit do k hàm băm chọn."""
    def __init__(self, m, k):        self.m, self.k = m, k        self.bits = bytearray((m + 7) // 8)
    def _positions(self, item):        # Băm một lần ra hai số 64 bit h1, h2, rồi tạo k vị trí h1 + i·h2 (mẹo Kirsch–Mitzenmacher).        d = hashlib.blake2b(item.encode(), digest_size=16).digest()        h1, h2 = int.from_bytes(d[:8], "little"), int.from_bytes(d[8:], "little") | 1        return [(h1 + i * h2) % self.m for i in range(self.k)]
    def add(self, item):        for p in self._positions(item):            self.bits[p >> 3] |= 1 << (p & 7)
    def might_contain(self, item):        """False = chắc chắn chưa có. True = có thể có (cần hỏi lại database)."""        return all(self.bits[p >> 3] >> (p & 7) & 1 for p in self._positions(item))

def theory(m, n, k):    """Tỷ lệ dương tính giả lý thuyết: (1 - e^(-kn/m))^k."""    return (1 - math.exp(-k * n / m)) ** k

# Ví dụ nhỏ: 2 tên đã đăng ký.bf = BloomFilter(m=1_000, k=7)for name in ["alumieye", "eyeblogs"]:    bf.add(name)print(bf.might_contain("eyeblogs"), bf.might_contain("euler"))    # True False
# Thí nghiệm 1: m = 100.000 bit (12,5 KB), k = 7, thêm dần tới 20.000 tên.# Đo tỷ lệ báo nhầm trên 20.000 tên CHƯA từng thêm.M, K = 100_000, 7bf = BloomFilter(M, K)tests = [f"chua-co-{i}" for i in range(20_000)]ns, measured = [], []for n in range(1, 20_001):    bf.add(f"user-{n}")    if n % 1_000 == 0:        fp = sum(bf.might_contain(t) for t in tests) / len(tests)        ns.append(n)        measured.append(fp)        if n in (5_000, 10_000, 15_000, 20_000):            print(f"n = {n:>6}  ({M / n:4.1f} bit/tên)  báo nhầm đo được {fp:6.2%}  lý thuyết {theory(M, n, K):6.2%}")
# Thí nghiệm 2: cố định 10 bit cho mỗi tên (m = 100.000, n = 10.000), đổi số hàm băm k.N = 10_000ks, by_k = list(range(1, 16)), []for k in ks:    f = BloomFilter(M, k)    for i in range(N):        f.add(f"user-{i}")    by_k.append(sum(f.might_contain(t) for t in tests) / len(tests))for k in (1, 3, 7, 11, 15):    print(f"k = {k:>2}  báo nhầm đo được {by_k[k - 1]:6.2%}  lý thuyết {theory(M, N, k):6.2%}")print(f"k tốt nhất theo lý thuyết: (m/n)·ln 2 = {M / N * math.log(2):.1f}")
# Vẽfig, (a1, a2) = plt.subplots(1, 2, figsize=(11, 4.6))grid = range(200, 20_001, 200)a1.plot(list(grid), [100 * theory(M, n, K) for n in grid], color="#8fa9c9", lw=2, label="lý thuyết")a1.plot(ns, [100 * x for x in measured], "o", color="#e8b05a", ms=5, label="đo được")a1.set_xticks(range(0, 20_001, 5_000))a1.xaxis.set_major_formatter(lambda x, _: f"{x:,.0f}".replace(",", "."))a1.axvline(M / 9.6, color="#2a2e35", lw=1)a1.text(M / 9.6 + 250, 12, "9,6 bit/tên\n→ khoảng 1%", color="#a4a9b2", fontsize=10)a1.set_xlabel("số tên đã thêm (bộ lọc cố định 100.000 bit)", color="#a4a9b2")a1.set_ylabel("tỷ lệ báo nhầm \"có thể có\" (%)", color="#a4a9b2")a1.set_title("Càng đầy, càng hay báo nhầm", color="#d4d7dc", fontsize=12)
a2.plot(ks, [100 * theory(M, N, k) for k in ks], color="#8fa9c9", lw=2, label="lý thuyết")a2.plot(ks, [100 * x for x in by_k], "o", color="#e8b05a", ms=5, label="đo được")a2.set_xlabel("số hàm băm k (10 bit cho mỗi tên)", color="#a4a9b2")a2.set_title("Quá ít hay quá nhiều hàm băm đều tệ", color="#d4d7dc", fontsize=12)a2.set_yscale("log")a2.yaxis.set_major_formatter(lambda y, _: f"{y:g}".replace(".", ","))a2.set_ylabel("tỷ lệ báo nhầm (%, thang log)", color="#a4a9b2")for ax in (a1, a2):    ax.grid(color="#22262c")    ax.legend(frameon=False, labelcolor="#a4a9b2", fontsize=10)fig.tight_layout()fig.savefig("bloom-filter.png", dpi=150, bbox_inches="tight")
True Falsen = 5000 (20.0 bit/tên) báo nhầm đo được 0.04% lý thuyết 0.02%n = 10000 (10.0 bit/tên) báo nhầm đo được 0.92% lý thuyết 0.82%n = 15000 ( 6.7 bit/tên) báo nhầm đo được 4.95% lý thuyết 4.91%n = 20000 ( 5.0 bit/tên) báo nhầm đo được 13.95% lý thuyết 13.78%k = 1 báo nhầm đo được 9.88% lý thuyết 9.52%k = 3 báo nhầm đo được 1.55% lý thuyết 1.74%k = 7 báo nhầm đo được 0.92% lý thuyết 0.82%k = 11 báo nhầm đo được 1.16% lý thuyết 1.16%k = 15 báo nhầm đo được 2.38% lý thuyết 2.27%k tốt nhất theo lý thuyết: (m/n)·ln 2 = 6.9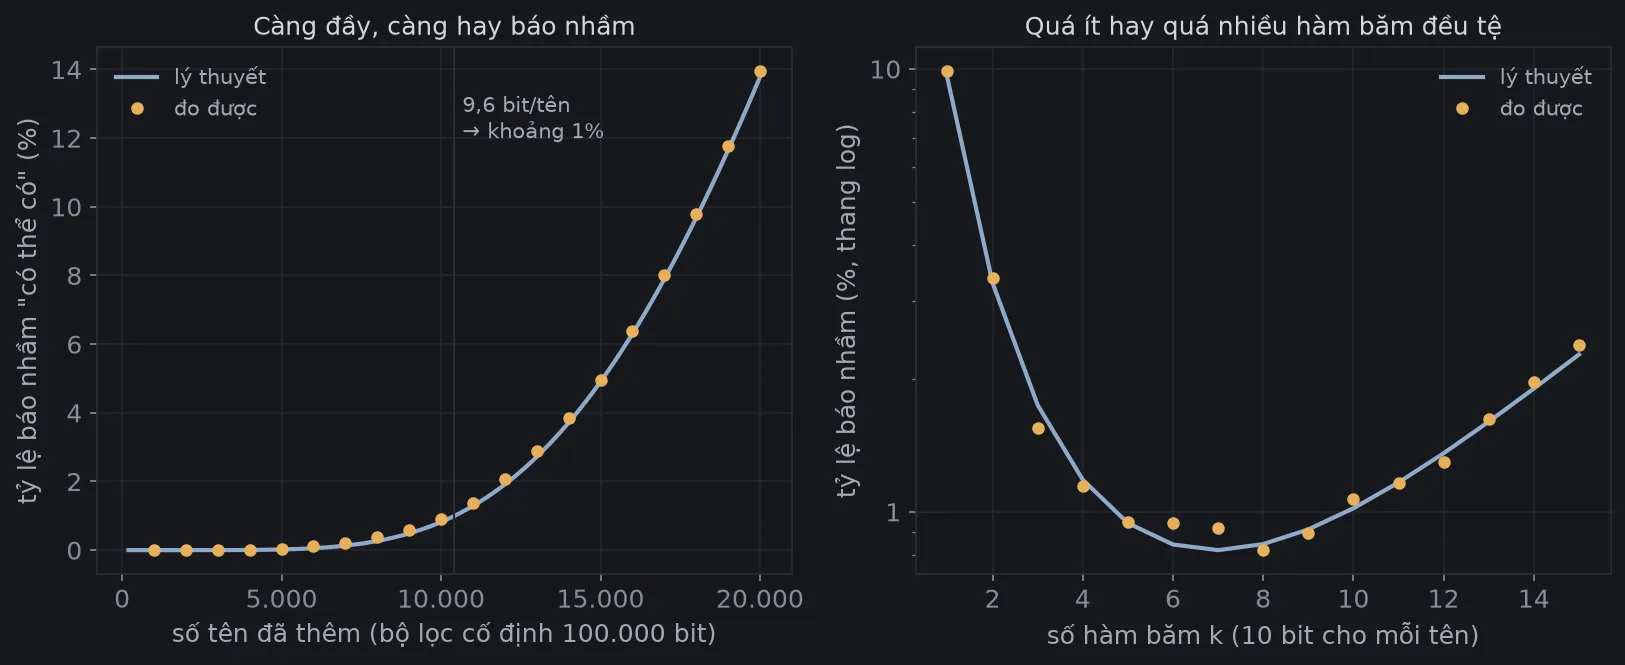
Các chấm đo được bám sát đường lý thuyết, nên công thức ở trên là công cụ thiết kế đáng tin. Hai điều đọc được từ hình:
- Bên trái: ở 10.000 tên (10 bit/tên) bộ lọc báo nhầm chưa tới 1%. Nhồi gấp đôi lên 20.000 tên, sai số không tăng gấp đôi mà tăng khoảng 15 lần. Đó là lý do phải thiết kế cho số phần tử tối đa ngay từ đầu.
- Bên phải: đáy của đường cong khá phẳng. Mọi từ 5 tới 9 đều cho sai số quanh 1%, nên trong thực tế không cần chọn quá chính xác. Các chấm đo được lệch nhẹ quanh đáy (chấm thấp nhất rơi vào thay vì 7) chỉ là nhiễu do đo trên 20.000 tên.
Bạn có thể đổi M và K để tự thiết kế một bộ lọc cho bài toán của mình, rồi so số đo với bảng ở mục “cần bao nhiêu bộ nhớ”.
Chấp nhận sai một chút để nhanh hơn rất nhiều
Bloom filter dạy một thói quen thiết kế đáng giá: khi câu trả lời “không” chiếm phần lớn và kiểm tra thật thì đắt, hãy đặt một lớp lọc rẻ, chỉ sai theo một chiều, đứng trước. Nó không thay database. Nó giúp database khỏi phải trả lời những câu hỏi mà đáp án chắc chắn là “không”.
Phần system design thêm một bài học quen thuộc: không có cấu trúc dữ liệu nào tốt nhất cho mọi hoàn cảnh. Akamai dùng Bloom filter để giảm gần một nửa số lần ghi đĩa. Chrome và Medium dùng nó nhiều năm rồi thay bằng thứ hợp hơn với dữ liệu của mình. Biết sai số của nó rơi vào đâu và phải trả giá thế nào, đó mới là phần khó.
Lần tới khi trang web báo “tên này đã có người dùng” trước cả khi bạn gõ xong, bạn sẽ biết phía sau có thể chỉ là một dãy công tắc, và vài công tắc vừa sáng lên vì tên của bạn.
Tài liệu tham khảo
- [1]Burton H. Bloom. Space/Time Trade-offs in Hash Coding with Allowable Errors. Communications of the ACM 13(7), 1970.
- [2]Bloom filter (Redis Open Source). Redis Documentation.
- [3]Bruce M. Maggs và Ramesh K. Sitaraman. Algorithmic Nuggets in Content Delivery. ACM SIGCOMM Computer Communication Review 45(3), 2015.
- [4]Bloom Filters. Apache Cassandra Documentation.
- [5]Chromium Safe Browsing: PrefixSet thay cho BloomFilter (code review 6286072). Chromium Code Reviews, 2011.
- [6]Engineering stories behind the Medium Daily Digest Algorithm: Part 2. Medium Engineering, 2025.
- [7]Bin Fan, David G. Andersen, Michael Kaminsky và Michael D. Mitzenmacher. Cuckoo Filter: Practically Better Than Bloom. CoNEXT, 2014.
- [8]Adam Kirsch và Michael Mitzenmacher. Less Hashing, Same Performance: Building a Better Bloom Filter. Random Structures & Algorithms 33(2), 2008.