Chỉ cần 23 người để có 50% khả năng trùng sinh nhật: vì sao trực giác đếm sai?
Nghịch lý ngày sinh nhật cho thấy trực giác đếm theo số người, còn xác suất đếm theo số cặp. Cùng một phép đếm ấy giải thích những sự trùng hợp quanh ta và những cặp cổ phiếu "đi cùng nhau" trong VN30.
Mục lục
Một vụ cược trong lớp học
Một lớp có 30 học sinh. Một người bạn đề nghị: nếu trong lớp có hai người trùng ngày sinh nhật, bạn thắng; nếu không, bạn thua. Tiền cược hai bên như nhau.
Bạn có nhận không?
Trước khi đọc tiếp, hãy thử đoán xác suất trong lớp có ít nhất hai người trùng sinh nhật. Một năm có 365 ngày, lớp chỉ có 30 người, nghe như còn rất nhiều ngày trống. Phần lớn chúng ta sẽ đoán một con số khoảng 5% hay 10%.
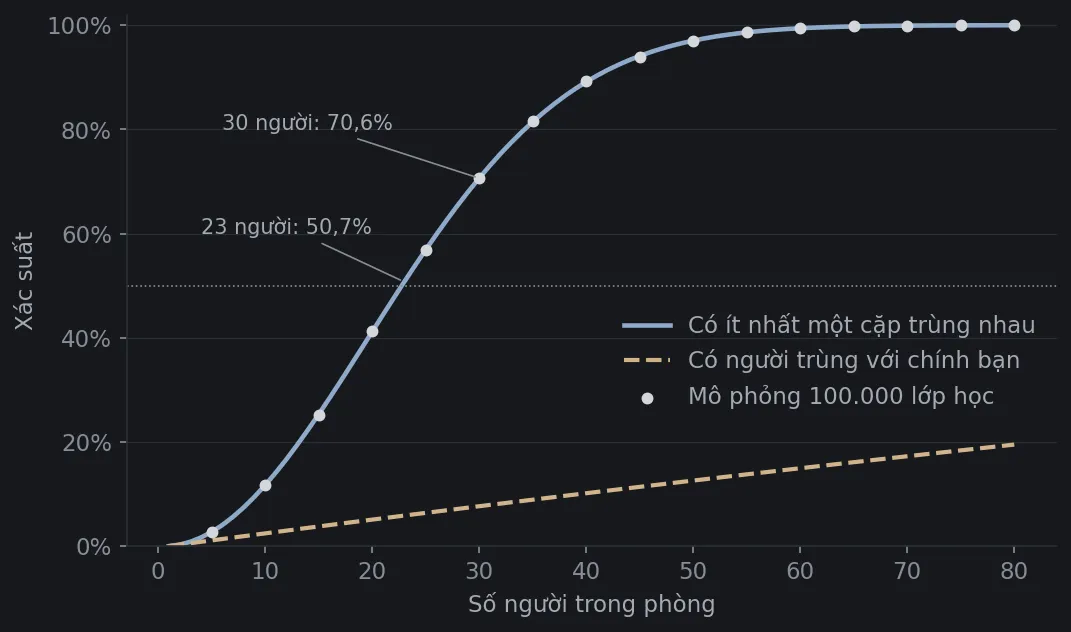
Con số đúng là khoảng 70,6%. Vụ cược ấy nghiêng hẳn về phía bạn.
Để xác suất vượt 50%, chỉ cần 23 người. Đây là birthday paradox, nghịch lý ngày sinh nhật. Gọi là nghịch lý nhưng không có mâu thuẫn logic nào ở đây. Chỉ có một khoảng cách lớn giữa con số thật và cảm giác của ta.
Khoảng cách ấy đáng tìm hiểu vì nó không chỉ nằm trong lớp học. Nó xuất hiện mỗi khi ta gặp một sự trùng hợp “khó tin”, và cả khi ta nhìn vào một bảng tương quan cổ phiếu.
Trực giác đang trả lời một câu hỏi khác
Khi nghe đề bài, phần lớn chúng ta tự động hình dung: có ai trong lớp trùng sinh nhật với mình không?
Câu hỏi đó có đáp án thật sự nhỏ. Với 29 người còn lại, xác suất có ít nhất một người trùng ngày với bạn là:
Trực giác không tính sai. Nó tính đúng cho một câu hỏi khác.
Đề bài hỏi có cặp nào trùng nhau hay không. Cặp đó có thể là bạn với Lan, nhưng cũng có thể là Minh với Hà, hay hai người ngồi cuối lớp mà bạn chưa từng để ý. Mỗi cặp là một cơ hội để sự trùng hợp xảy ra, và số cặp thì lớn hơn nhiều so với cảm nhận.
Có một cách so sánh khá bất ngờ. Để xác suất có người trùng sinh nhật với chính bạn vượt 50%, bạn cần khoảng 253 người khác. Để xác suất có một cặp bất kỳ trùng nhau vượt 50%, chỉ cần 23 người.
Con số 253 xuất hiện ở cả hai phía không phải ngẫu nhiên. Hãy đếm xem 23 người tạo ra bao nhiêu cặp.
Đếm cặp, không đếm người
Người thứ nhất bắt cặp được với 22 người còn lại. Người thứ hai, sau khi bỏ cặp đã đếm, còn 21 người. Cứ thế đến người cuối cùng:
Ký hiệu đọc là “tổ hợp chập 2 của n”: số cách chọn ra hai người từ n người mà không quan tâm thứ tự. Tổng quát, n người tạo ra cặp.
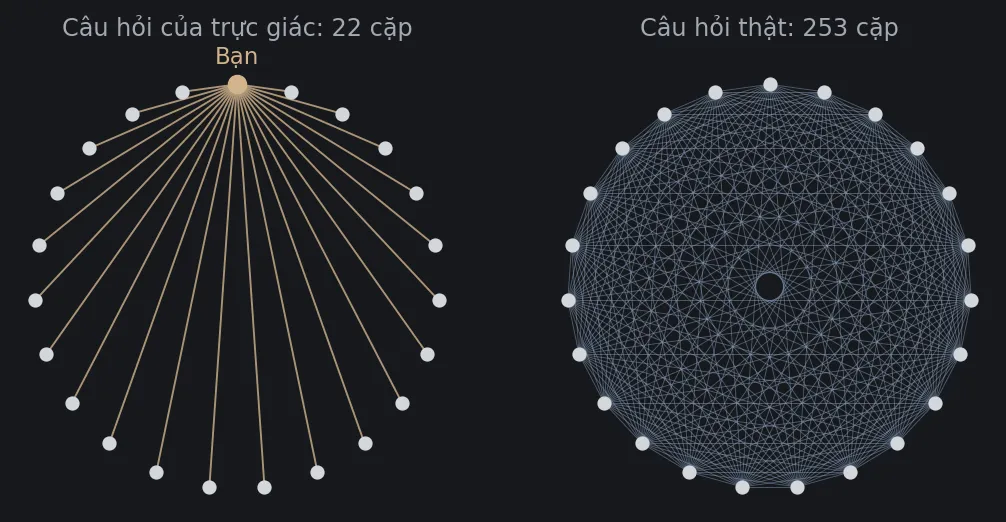
Số người tăng đều, số cặp tăng xấp xỉ theo bình phương số người:
| Số người | Số cặp |
|---|---|
| 10 | 45 |
| 23 | 253 |
| 30 | 435 |
| 50 | 1.225 |
| 70 | 2.415 |
Lớp 30 người có 435 cặp. Mỗi cặp chỉ có khoảng cơ hội trùng ngày. Nhưng 435 lần thử một cơ hội nhỏ không còn là một cơ hội nhỏ.
Tính chính xác: đi qua cửa sau
Tính trực tiếp “có ít nhất một cặp trùng” khá rối. Có thể có đúng một cặp, hai cặp, ba người cùng một ngày… Cách gọn hơn là tính biến cố ngược lại: không ai trùng ai, rồi lấy 1 trừ đi.
Ta giả định năm có 365 ngày, bỏ qua ngày 29/2, và mỗi người sinh vào ngày nào cũng có khả năng như nhau, độc lập với người khác.
Xếp từng người vào phòng:
- Người thứ nhất sinh ngày nào cũng được: .
- Người thứ hai phải tránh một ngày đã có: .
- Người thứ ba phải tránh hai ngày: .
- Người thứ n phải tránh ngày: .
Nhân lại:
Ký hiệu là tích của các thừa số, giống như là tổng. Phép tính này có trong hầu hết giáo trình xác suất nhập môn[1]. Kết quả:
| Số người | Xác suất có cặp trùng |
|---|---|
| 10 | 11,7% |
| 20 | 41,1% |
| 23 | 50,7% |
| 30 | 70,6% |
| 40 | 89,1% |
| 50 | 97,0% |
| 57 | 99,0% |
| 70 | 99,9% |
Với 70 người, gần như chắc chắn có hai người trùng sinh nhật, dù 70 còn chưa bằng một phần năm số ngày trong năm.
Vì sao lại là 23?
Công thức tích cho con số chính xác nhưng chưa cho thấy vì sao lại là 23. Một phép xấp xỉ sẽ làm lộ ra cấu trúc bên dưới.
Với nhỏ, . Áp dụng cho từng thừa số:
Tử số trong số mũ chính là số cặp. Chia cho 365 là lấy số cặp nhân với xác suất một cặp trùng nhau. Đại lượng này có tên riêng: số cặp trùng kỳ vọng, tức số cặp trùng trung bình nếu lặp lại thí nghiệm rất nhiều lần. Ký hiệu nó là , ta có:
Với 23 người: . Mà , nên . Xác suất vượt 50% đúng ở chỗ số cặp trùng kỳ vọng chạm .
Tổng quát hơn, nếu có “ngày” thay vì 365, xác suất trùng đạt 50% khi:
Với : . Đây là ý quan trọng nhất của cả bài:
Sự trùng lặp bắt đầu xuất hiện khi số phần tử đạt khoảng , chứ không phải khi đạt .
Trực giác của ta ngầm so 23 với 365 và thấy còn xa. Phép so đúng là so 23 với .
Để máy tính mở một trăm nghìn lớp học
Nếu công thức vẫn chưa thuyết phục, hãy để máy tính thử. Đoạn Python sau chỉ dùng thư viện chuẩn: tạo ngẫu nhiên các “lớp học”, mỗi người một ngày sinh, rồi đếm tỷ lệ lớp có người trùng.
import random
TRIALS = 100_000rng = random.Random(42)  # Cố định seed để chạy lại ra cùng kết quả.

def has_shared_birthday(n: int) -> bool:    seen = set()    for _ in range(n):        day = rng.randrange(365)        if day in seen:            return True        seen.add(day)    return False

for n in (10, 23, 30, 50, 70):    hits = sum(has_shared_birthday(n) for _ in range(TRIALS))    print(f"{n:>2} người: {hits / TRIALS:.3f}")
Kết quả khi chạy:
10 người: 0.11723 người: 0.50530 người: 0.70850 người: 0.96970 người: 0.999Mô phỏng khớp với bảng tính ở trên, chênh lệch chỉ ở mức sai số ngẫu nhiên. Hình dưới đặt hai câu hỏi cạnh nhau: đường liền là “có cặp nào trùng”, đường đứt là “có ai trùng với bạn”.
Những sự trùng hợp “khó tin” quanh ta
Bài học của nghịch lý ngày sinh nhật rộng hơn chuyện sinh nhật: số cơ hội để một sự trùng hợp xảy ra thường lớn hơn nhiều so với cảm giác của ta, vì ta đếm theo đối tượng trong khi cơ hội sinh ra từ các cặp, các tổ hợp.
Thử áp công thức vào một ví dụ gần gũi. Bốn số cuối của số điện thoại có khả năng. Theo , một nhóm chat khoảng 120 người đã có chừng 50% khả năng có hai người trùng bốn số cuối, nếu coi các số cuối là ngẫu nhiên đều. Khi phát hiện điều đó, cả nhóm sẽ thấy thật “có duyên”.
Những trải nghiệm quen thuộc khác vận hành theo cùng logic:
- Gặp người quen ở nơi xa lạ. Xác suất gặp đúng một người cụ thể thì nhỏ. Nhưng bạn quen vài trăm người, đi qua hàng nghìn người lạ mỗi chuyến đi, và bất kỳ người quen nào xuất hiện cũng đủ để bạn thốt lên “trái đất tròn thật”.
- Vừa nghĩ đến ai thì người đó gọi. Mỗi ngày ta nghĩ đến rất nhiều người và nhận nhiều cuộc gọi. Những lần hai việc trùng nhau được nhớ rất lâu. Những lần không trùng không để lại dấu vết nào.
- Tin “một người trúng số hai lần”. Nghe như phép màu nếu hỏi về một người cụ thể. Nhưng câu hỏi đúng là: có bao nhiêu người chơi xổ số, trong bao nhiêu năm? Khi số người và số lần chơi đủ lớn, việc ai đó trúng hai lần trở thành điều khá bình thường.
Persi Diaconis và Frederick Mosteller, hai nhà thống kê từng nghiên cứu nghiêm túc về các sự trùng hợp, gọi hiện tượng này là law of truly large numbers: với một tập đủ lớn, những điều nghe rất khó tin cũng có khả năng xảy ra ở đâu đó[2]. Nghịch lý ngày sinh nhật là phiên bản nhỏ và tính được chính xác của quy luật ấy.
Điều này không có nghĩa mọi trùng hợp đều vô nghĩa. Nó chỉ nhắc rằng trước khi ngạc nhiên, nên đếm xem sự việc có bao nhiêu cơ hội để xảy ra.
VN30: một lớp học 28 cổ phiếu
Bây giờ thay học sinh bằng cổ phiếu, và thay “trùng sinh nhật” bằng “biến động giống nhau”.
Nhà đầu tư thường tìm các cặp cổ phiếu “đi cùng nhau”: khi mã này tăng thì mã kia cũng tăng. Thước đo phổ biến là hệ số tương quan , nằm trong khoảng từ đến . gần 1 nghĩa là hai chuỗi lợi suất thường lên xuống cùng lúc, gần 0 là không có quan hệ tuyến tính rõ ràng, gần là thường ngược chiều nhau.
Nếu quét cả rổ cổ phiếu để tìm cặp tương quan cao nhất, ta đang làm đúng việc của nghịch lý ngày sinh nhật: xem xét mọi cặp và chọn ra cặp “trùng” nhất.
Nếu cổ phiếu chỉ là những con số ngẫu nhiên
Trước khi nhìn dữ liệu thật, cần một mốc so sánh: nếu 28 mã hoàn toàn không liên quan gì đến nhau, bảng tương quan sẽ trông thế nào?
Có một cách tạo mốc khá gọn. Lấy chuỗi lợi suất thật của từng mã, rồi xáo trộn thứ tự các tháng, mỗi mã xáo một kiểu riêng. Mỗi mã vẫn giữ nguyên những tháng tăng mạnh, giảm mạnh của chính nó, nhưng mọi quan hệ về thời gian giữa các mã bị phá vỡ. Lặp lại 2.000 lần.
Kết quả: dù không có quan hệ thật nào, trong 378 cặp vẫn luôn có một cặp “nổi bật”. Cặp mạnh nhất trung bình đạt , và trong 90% số lần nằm trong khoảng 0,34 đến 0,50. Trung bình có khoảng 8 cặp vượt ngưỡng .
Đó là “những cặp trùng sinh nhật” của thị trường. Chúng xuất hiện chỉ vì ta đã nhìn vào 378 cặp.
Dữ liệu thật: phần lớn tương quan là thật
Bây giờ đến dữ liệu thật. Tương quan trung bình giữa các cặp là 0,33, và 206 trên 378 cặp có , so với khoảng 8 cặp nếu chỉ có ngẫu nhiên. Cặp cao nhất là BID và VCB với .
Không thể giải thích khoảng cách này bằng nghịch lý ngày sinh nhật. Lý do đơn giản hơn: các cổ phiếu cùng chịu tác động của thị trường chung. Khi dòng tiền vào hay rút khỏi thị trường, lãi suất đổi chiều hay tâm lý nhà đầu tư thay đổi, phần lớn cổ phiếu cùng phản ứng. Lớp học VN30 không phải một lớp học ngẫu nhiên.
Đây là một điểm cần nói rõ, để không kéo nghịch lý ngày sinh nhật đi quá xa: phần lớn tương quan thô giữa các cổ phiếu lớn là có thật.
Gỡ yếu tố thị trường ra
Câu hỏi thú vị hơn là: sau khi bỏ đi phần chuyển động chung với VNINDEX, những cặp nào vẫn còn đi cùng nhau?
Với mỗi mã, ta hồi quy lợi suất theo lợi suất VNINDEX và giữ lại phần dư, tức phần biến động không giải thích được bằng thị trường chung. Sau đó tính tương quan giữa các phần dư.
Lần này tương quan trung bình gần như bằng 0 (0,02). Dù vậy vẫn có 57 cặp vượt , so với khoảng 8 cặp của mốc ngẫu nhiên. Những cặp mạnh nhất phần lớn có một câu chuyện kinh tế rõ ràng:
| Cặp | Tương quan phần dư | Câu chuyện |
|---|---|---|
| BID–VCB | 0,74 | Hai ngân hàng thương mại nhà nước |
| VHM–VIC | 0,64 | Cùng hệ sinh thái Vingroup |
| VHM–VRE | 0,58 | Cùng hệ sinh thái Vingroup |
| BID–CTG | 0,57 | Hai ngân hàng thương mại nhà nước |
| BSR–GAS | 0,53 | Cùng thuộc hệ dầu khí, nhạy giá dầu |
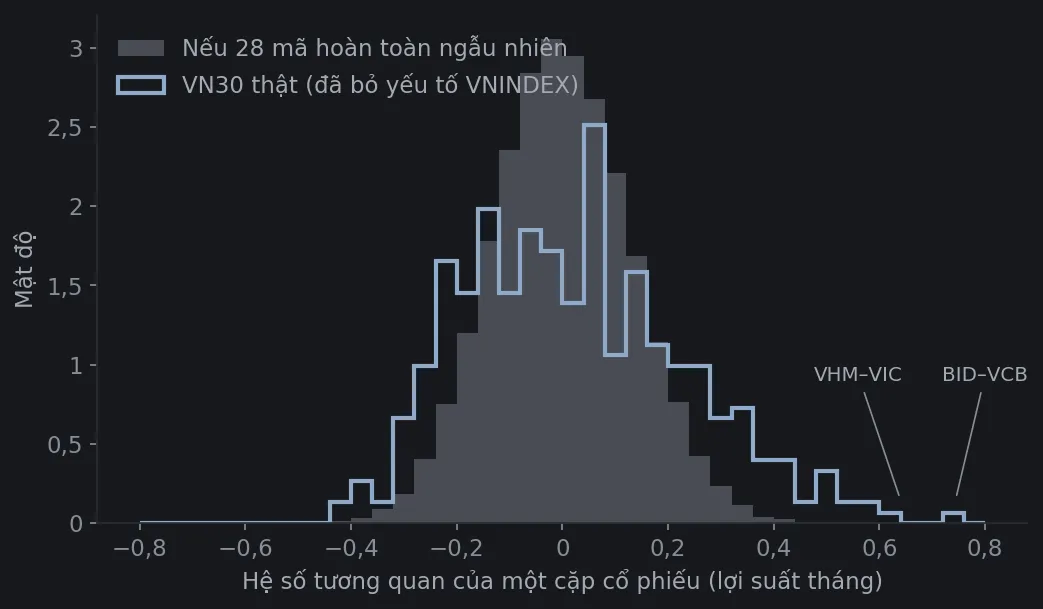
Nhưng đây cũng là lúc nghịch lý ngày sinh nhật quay lại. Trong 57 cặp nổi bật, có khoảng 8 cặp mà chỉ riêng ngẫu nhiên cũng đủ để tạo ra. Nhìn vào con số, ta không biết cặp nào là thật, cặp nào là “trùng sinh nhật”. Một cặp có trong bảng trông giống hệt nhau, dù nó đến từ quan hệ kinh tế hay từ sự tình cờ.
Muốn phân biệt, cần một phép thử mà sự tình cờ khó vượt qua: dữ liệu mới.
Bài kiểm tra ngoài mẫu
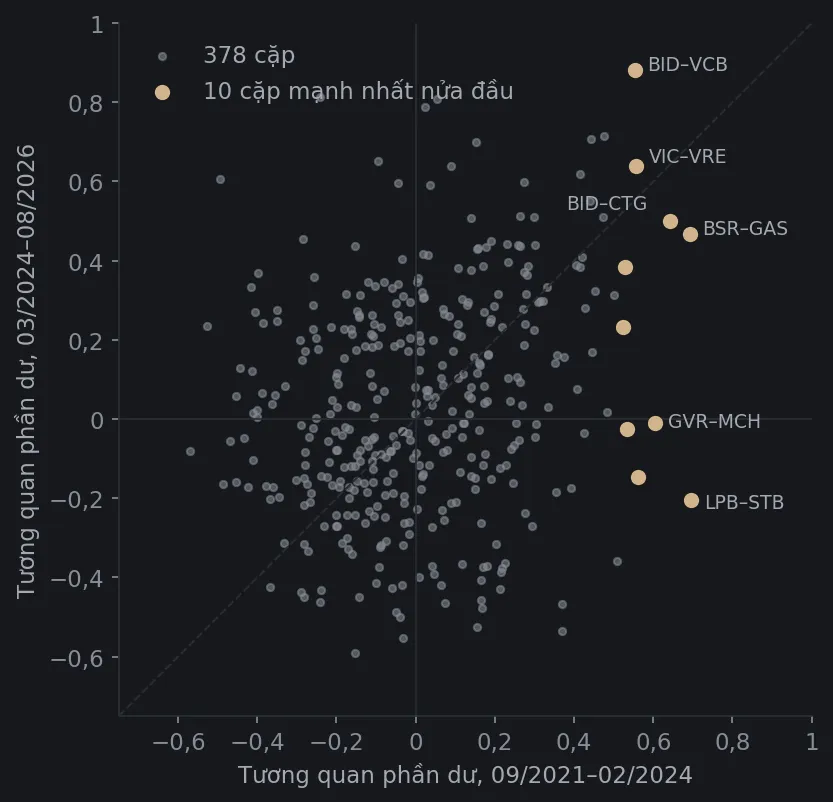
Chia 60 tháng thành hai nửa. Dùng 30 tháng đầu (09/2021 đến 02/2024) để chọn ra 10 cặp có tương quan phần dư mạnh nhất, giống như một nhà đầu tư tìm cặp cổ phiếu vào đầu năm 2024. Sau đó xem 10 cặp ấy ra sao trong 30 tháng tiếp theo (03/2024 đến 08/2026), là những tháng không được dùng để chọn cặp. Cách làm này gọi là kiểm tra out-of-sample, tức ngoài mẫu.
| Cặp | Nửa đầu | Nửa sau |
|---|---|---|
| LPB–STB | 0,70 | −0,20 |
| BSR–GAS | 0,69 | 0,47 |
| BID–CTG | 0,64 | 0,50 |
| GVR–MCH | 0,60 | −0,01 |
| CTG–LPB | 0,56 | −0,15 |
| VIC–VRE | 0,56 | 0,64 |
| BID–VCB | 0,55 | 0,88 |
| LPB–SHB | 0,53 | −0,02 |
| MBB–VCB | 0,53 | 0,38 |
| STB–TCB | 0,52 | 0,23 |
Trung bình 10 cặp giảm từ 0,59 xuống 0,27. Nhưng điều đáng chú ý hơn là cặp nào giữ được và cặp nào sụp đổ.
Những cặp có câu chuyện kinh tế cụ thể như BID–VCB, VIC–VRE, BSR–GAS, BID–CTG vẫn tương quan rõ ở nửa sau, có cặp còn mạnh hơn. Trong khi đó GVR–MCH, một tập đoàn cao su và một doanh nghiệp hàng tiêu dùng, rơi từ 0,60 về gần 0. LPB–STB, cặp đứng đầu bảng chọn, đảo chiều thành −0,20.
Vì sao một cặp như LPB–STB lại đạt 0,70 ở nửa đầu? Với chỉ 30 tháng dữ liệu, riêng ngẫu nhiên đã tạo ra cặp mạnh nhất quanh trong 378 cặp, vì mẫu càng ngắn thì nhiễu càng lớn. Các cặp ngân hàng còn có một nền tương quan ngành vừa phải: trung bình khoảng 0,2 ở cả hai nửa. Cộng nền ấy với một chút may mắn, con số 0,70 không còn quá khó xuất hiện. Phần “ngành” ở lại, còn phần “may mắn” thì không lặp lại.
Đoạn code dưới đây tái tạo phần phân tích phần dư. Cần cài vnstock, pandas và numpy. API key của vnstock là không bắt buộc, nhưng gói miễn phí giới hạn số request mỗi phút nên code có nghỉ giữa các lần gọi.
import time
import numpy as npimport pandas as pdfrom vnstock import Quote
SYMBOLS = ["ACB", "BID", "BSR", "CTG", "FPT", "GAS", "GVR", "HDB", "HPG", "LPB",           "MBB", "MCH", "MSN", "MWG", "SAB", "SHB", "SSB", "SSI", "STB", "TCB",           "VCB", "VHM", "VIB", "VIC", "VJC", "VNM", "VPB", "VRE", "VNINDEX"]
closes = {}for sym in SYMBOLS:    df = Quote(source="VCI", symbol=sym).history(start="2021-08-01", end="2026-09-26", interval="1D")    closes[sym] = df.set_index(pd.to_datetime(df["time"]))["close"]    time.sleep(3.5)  # Tránh vượt giới hạn số request mỗi phút của gói miễn phí.
# Lợi suất tháng 09/2021 → 08/2026. Cắt lại khoảng thời gian vì API có thể trả về nhiều hơn yêu cầu.monthly = pd.DataFrame(closes).ffill().resample("ME").last().loc["2021-08-31":"2026-08-31"]ret = monthly.pct_change(fill_method=None).dropna()market = ret.pop("VNINDEX").to_numpy()
# Bỏ phần chuyển động chung với VNINDEX: giữ lại phần dư của hồi quy r = a + b·marketX = np.column_stack([np.ones(len(market)), market])resid = ret.to_numpy() - X @ np.linalg.lstsq(X, ret.to_numpy(), rcond=None)[0]
iu = np.triu_indices(len(ret.columns), k=1)  # 378 cặpnames = [f"{ret.columns[i]}–{ret.columns[j]}" for i, j in zip(*iu)]real = pd.Series(np.corrcoef(resid, rowvar=False)[iu], index=names)
# Đối chứng: xáo thứ tự thời gian của từng mã để phá mọi quan hệ thậtrng = np.random.default_rng(42)fake_max = []for _ in range(2000):    shuffled = np.column_stack([rng.permutation(col) for col in resid.T])    fake_max.append(np.abs(np.corrcoef(shuffled, rowvar=False)[iu]).max())
print("Số cặp |r| > 0,3:", (real.abs() > 0.3).sum())print("Cặp mạnh nhất nếu chỉ có ngẫu nhiên: |r| ≈", round(np.mean(fake_max), 2))print(real.nlargest(5).round(2))
Số cặp |r| > 0,3: 57Cặp mạnh nhất nếu chỉ có ngẫu nhiên: |r| ≈ 0.41BID–VCB 0.74VHM–VIC 0.64VHM–VRE 0.58BID–CTG 0.57BSR–GAS 0.53Thử đủ nhiều thì thể nào cũng có người “thắng”
Tìm cặp cổ phiếu chỉ là một trường hợp. Cùng một phép đếm xuất hiện ở khắp nơi trong đầu tư, mỗi khi ta chọn ra “cái tốt nhất” từ rất nhiều lựa chọn.
Thử nhiều chiến lược. Giả sử bạn backtest 20 chiến lược thực chất không có lợi thế gì, và coi một chiến lược là “có ý nghĩa thống kê” nếu kết quả đủ tốt để chỉ có 5% khả năng xảy ra do may mắn. Nếu các phép thử độc lập, xác suất có ít nhất một chiến lược vượt ngưỡng là:
Với 100 chiến lược, con số này là 99,4%. Trong thống kê, vấn đề này gọi là multiple testing, kiểm định nhiều giả thuyết. Harvey, Liu và Zhu cho rằng trong nghiên cứu tài chính, nơi hàng trăm “yếu tố dự báo lợi suất” đã được thử trên cùng dữ liệu, ngưỡng để công nhận một phát hiện mới cần cao hơn đáng kể so với thông lệ[4]. Bài Monty Hall đã bàn về cách một backtest được chọn ra từ nhiều lần thử. Nghịch lý ngày sinh nhật cho thấy thêm một điều: số lần thử càng nhiều, sự “trùng hợp” càng gần như chắc chắn.
Chuyên gia đoán đúng 5 lần liên tiếp. Hãy tưởng tượng 1.000 người đoán thị trường tuần tới tăng hay giảm, mỗi người như đang tung đồng xu. Sau 5 tuần, kỳ vọng có khoảng người đoán đúng cả 5 lần. Nếu chỉ những người đó chia sẻ thành tích lên mạng xã hội, bạn sẽ thấy 31 “chuyên gia” chứ không thấy 969 người còn lại.
Quỹ thắng thị trường 10 năm liền. Một ví dụ giả định: có 1.000 quỹ, mỗi năm mỗi quỹ có 50% khả năng thắng thị trường, độc lập giữa các năm. Kỳ vọng có khoảng quỹ thắng liên tục 10 năm. Quỹ đó có thể thật sự giỏi. Nhưng chỉ riêng việc tồn tại một quỹ như vậy chưa đủ để chứng minh điều gì, vì ta đã nhìn qua 1.000 quỹ để tìm ra nó. Đây cũng là lúc nên xem lại phần những kẻ sống sót trong bài Monty Hall.
Các ví dụ trên dùng giả định đơn giản hóa để làm rõ cơ chế. Ngoài đời, chiến lược và quỹ không độc lập với nhau, kỹ năng thật có tồn tại, và con số cụ thể sẽ khác. Điều không đổi là: khi thấy một kết quả nổi bật, hãy hỏi nó được chọn ra từ bao nhiêu kết quả khác.
Vậy nên tin vào điều gì?
Nếu mọi sự trùng hợp đều có thể là tình cờ, liệu ta có nên nghi ngờ tất cả?
Không. Phần VN30 ở trên cho thấy điều ngược lại: có những quan hệ thật, và chúng để lại dấu hiệu khác với sự tình cờ. Ba dấu hiệu đáng tìm:
- Có cơ chế giải thích được, và cơ chế đó có trước khi nhìn dữ liệu. BID và VCB cùng là ngân hàng thương mại nhà nước. VIC và VRE cùng một tập đoàn. Một câu chuyện nghĩ ra sau khi thấy con số thì yếu hơn nhiều, vì với đủ sáng tạo, cặp nào cũng có thể được gắn một câu chuyện.
- Lặp lại trên dữ liệu mới. Sự tình cờ hiếm khi xuất hiện hai lần ở cùng một chỗ. Kiểm tra ngoài mẫu là cách đơn giản và mạnh nhất để lọc nó.
- Đủ lớn so với mốc ngẫu nhiên đã tính đến số lần thử. So một con số với “cặp mạnh nhất trong 378 cặp ngẫu nhiên” khác hẳn so với “một cặp ngẫu nhiên bất kỳ”. Mốc so sánh phải được đếm theo cặp, giống như sinh nhật.
Bốn câu hỏi trước một sự trùng hợp
Dù là một cuộc gặp tình cờ, một cặp cổ phiếu hay một chiến lược đẹp như mơ, bốn câu hỏi sau thường đủ để bắt đầu:
- Tôi đang ngạc nhiên về một sự kiện cụ thể, hay về việc bất kỳ sự kiện nào như vậy xảy ra?
- Sự việc này đã có bao nhiêu cơ hội để xảy ra? Đếm theo cặp, theo tổ hợp, không chỉ theo đối tượng.
- Ai hoặc cái gì đã chọn ra kết quả này để tôi nhìn thấy?
- Nếu nó không xảy ra, tôi có để ý không?
Quay lại lớp học 30 người
Vụ cược ở đầu bài giờ không còn khó quyết định. Lớp 30 người có 435 cặp, mỗi cặp là một cơ hội nhỏ, và 435 cơ hội nhỏ cộng lại cho bạn 70,6% khả năng thắng.
Rổ VN30 trong bài có 378 cặp. Một số cặp đi cùng nhau vì những lý do kinh tế thật. Một số chỉ đơn giản là “trùng sinh nhật”: nổi bật vì ta đã nhìn qua quá nhiều cặp, rồi biến mất khi có dữ liệu mới.
Điều đáng mang theo sau khi quên các công thức là: trực giác đếm theo số người, còn xác suất đếm theo số cặp. Lần tới khi gặp một sự trùng hợp làm bạn phải thốt lên, hãy dừng lại và đếm xem nó đã có bao nhiêu cơ hội để xảy ra.
Tài liệu tham khảo
- [1]Charles M. Grinstead và J. Laurie Snell. Introduction to Probability. American Mathematical Society, 2003. Ấn bản thứ hai, Chương 3 — Combinatorics; liên kết tới bản CHANCE năm 2006.
- [2]Persi Diaconis và Frederick Mosteller. Methods for Studying Coincidences. Journal of the American Statistical Association, 84(408), 853–861, 1989.
- [3]Alfred J. Menezes, Paul C. van Oorschot và Scott A. Vanstone. Handbook of Applied Cryptography. CRC Press, 1996. Chương 9 — Hash Functions and Data Integrity.
- [4]Campbell R. Harvey, Yan Liu và Heqing Zhu. … and the Cross-Section of Expected Returns. The Review of Financial Studies, 29(1), 5–68, 2016.