Vì sao khen thì lần sau kém đi, chê thì lần sau khá lên? Hồi quy về trung bình
Người đứng đầu hôm nay vừa giỏi vừa gặp may, và may mắn thì không lặp lại. Từ thầy dạy bay, điểm thi, chiều cao của Galton, những đội tuyển vừa vô địch đến 8 năm dữ liệu cổ phiếu HOSE: vì sao kết quả cực đoan thường được theo sau bởi một kết quả bình thường hơn.
Mục lục
Người thầy dạy bay
Một thầy dạy bay có kinh nghiệm nhận ra một quy luật từ nhiều năm đứng lớp. Mỗi khi khen một học viên vừa hạ cánh rất đẹp, lần hạ cánh sau của người đó thường kém đi. Mỗi khi mắng một học viên vừa hạ cánh vụng về, lần sau họ thường khá lên. Kết luận của ông rất tự nhiên: khen làm người ta chủ quan, chê mới khiến người ta tiến bộ.
Tversky và Kahneman đã dùng tình huống này để minh họa một lỗi suy luận rất phổ biến[1]. Quan sát của người thầy hoàn toàn đúng: sau một lần hạ cánh xuất sắc, lần sau đúng là thường kém hơn. Chỉ có lời giải thích là sai.
Để thấy vì sao, hãy thử một thí nghiệm mà lời khen hay lời chê không có tác dụng gì cả. Mô phỏng 50 học viên, mỗi người có một tay nghề cố định. Mỗi lần hạ cánh là tay nghề cộng với một chút may rủi: gió, tâm trạng, một cái chớp mắt không đúng lúc. Người thầy không nói gì, chỉ quan sát.
Kết quả: nhóm 20% hạ cánh tệ nhất ở lần đầu, sang lần thứ hai lấy lại khoảng một nửa khoảng cách so với mức trung bình của cả lớp. Nhóm 20% hạ cánh đẹp nhất thì đánh mất khoảng một nửa khoảng cách ấy. Không ai được khen, không ai bị chê, tay nghề của ai cũng không đổi.
Hiện tượng này có tên là regression to the mean, hồi quy về trung bình. Đây là bài thứ tư trong loạt bài về những lúc trực giác phản bội ta, và nó là “người anh em” trực tiếp của bài Gambler’s Fallacy.
Kết quả = thực lực + may rủi
Hãy chuyển sang một lớp học, nơi mọi thứ dễ hình dung hơn.
Lớp có 100 học sinh làm hai bài kiểm tra cách nhau một tuần. Điểm của mỗi bài gồm hai phần. Phần thứ nhất là thực lực: mức độ hiểu bài, không đổi trong một tuần. Phần thứ hai là may rủi: đoán trúng một câu trắc nghiệm, đề rơi đúng phần mình vừa ôn, hôm đó ngủ đủ hay thiếu. Phần may rủi của hai bài độc lập với nhau.
Sau bài thứ nhất, chọn ra 10 người điểm cao nhất. Vì sao họ đứng đầu? Phần lớn vì họ giỏi. Nhưng trong một lớp 100 người, những người đứng đầu gần như chắc chắn cũng là những người gặp may trong bài đó. Một bạn giỏi ngang họ nhưng hôm ấy xui thì đã không lọt vào top 10.
Sang bài thứ hai, thực lực vẫn giữ nguyên. Còn may rủi thì được “tung lại” từ đầu, và như bài Gambler’s Fallacy đã nói, lần tung mới không nhớ gì lần trước. Phần may mắn giúp họ đứng đầu lần trước không đi theo họ sang lần sau. Điểm trung bình của nhóm sẽ tụt về phía mức chung của lớp, dù không ai học kém đi.
Chiều ngược lại cũng vậy. Nhóm 10 người điểm thấp nhất bài một vừa yếu hơn, vừa kém may. Sang bài hai, phần xui xẻo không lặp lại, và điểm trung bình của họ nhích lên.
Đoạn Python sau mô phỏng 2.000 lớp học như thế. Thực lực và may rủi có độ lớn ngang nhau, điểm trung bình chung là 6,5:
import randomimport statistics
rng = random.Random(7)  # Cố định seed để chạy lại ra cùng kết quả.CLASSES, STUDENTS = 2_000, 100top_1, top_2, bottom_1, bottom_2 = [], [], [], []
for _ in range(CLASSES):    skill = [rng.gauss(6.5, 1.0) for _ in range(STUDENTS)]     # thực lực, không đổi giữa hai bài    test_1 = [s + rng.gauss(0, 1.0) for s in skill]            # may rủi của bài 1    test_2 = [s + rng.gauss(0, 1.0) for s in skill]            # may rủi mới, độc lập, của bài 2    ranked = sorted(range(STUDENTS), key=lambda i: test_1[i])    for group, first, second in ((ranked[-10:], top_1, top_2), (ranked[:10], bottom_1, bottom_2)):        first.append(statistics.mean(test_1[i] for i in group))        second.append(statistics.mean(test_2[i] for i in group))
print(f"10 người cao nhất bài 1: {statistics.mean(top_1):.2f} → bài 2: {statistics.mean(top_2):.2f}")print(f"10 người thấp nhất bài 1: {statistics.mean(bottom_1):.2f} → bài 2: {statistics.mean(bottom_2):.2f}")
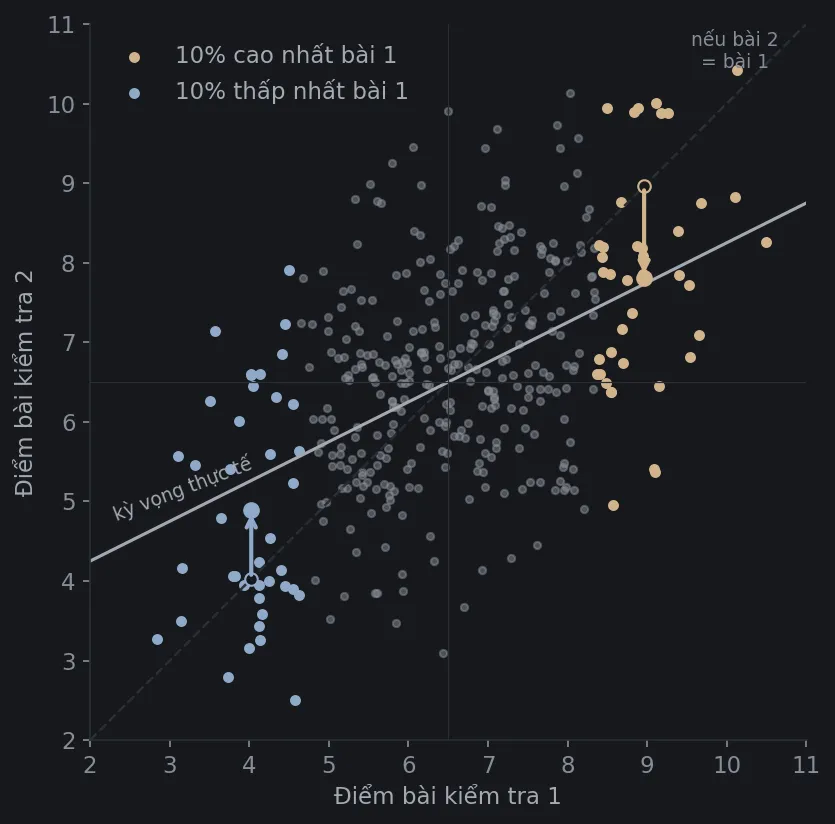
10 người cao nhất bài 1: 8.94 → bài 2: 7.7110 người thấp nhất bài 1: 4.06 → bài 2: 5.29Nhóm đứng đầu tụt từ 8,94 xuống 7,71. Nhóm đứng cuối tăng từ 4,06 lên 5,29. Cả hai đều đi đúng một nửa quãng đường về mức 6,5. Con số “một nửa” không phải ngẫu nhiên, và phần tiếp theo sẽ giải thích vì sao.
Hình dưới vẽ đúng thí nghiệm này với 400 học sinh. Đường chéo đứt nét là trường hợp “bài hai bằng bài một”. Đường liền là điều ta thực sự nên kỳ vọng: thoải hơn hẳn. Hai mũi tên cho thấy nhóm đứng đầu tụt xuống, nhóm đứng cuối nhích lên.
Công thức của sự “trở về”
Gọi là kết quả lần đầu, là kết quả lần sau, cả hai có cùng mức trung bình và cùng độ phân tán. Khi biết , kết quả lần sau kỳ vọng là:
đọc là “giá trị trung bình của khi đã biết bằng ”. Còn là hệ số tương quan giữa hai lần đo, nằm trong khoảng từ đến .
Công thức nói rằng: lần sau, ta chỉ nên kỳ vọng giữ lại một phần của khoảng cách so với trung bình. Phần còn lại, , là phần “trở về”.
Trong ví dụ lớp học, thực lực và may rủi có độ lớn ngang nhau, nên đúng một nửa sự khác biệt giữa các học sinh là thực lực. Khi đó , và nhóm đứng đầu chỉ giữ lại một nửa khoảng cách so với trung bình. Đó là lý do cả hai nhóm đều đi đúng nửa đường.
Hai trường hợp cực đoan giúp hiểu rõ hơn:
- : kết quả hoàn toàn do thực lực, không có may rủi. Người đứng đầu lần này sẽ đứng đầu lần sau với đúng số điểm ấy. Không có hồi quy. Chạy 100 mét gần với trường hợp này hơn là xổ số.
- : kết quả hoàn toàn do may rủi. Người đứng đầu lần này, lần sau chỉ là một người bình thường. Hồi quy trọn vẹn về trung bình. Xổ số là ví dụ điển hình.
Hầu hết mọi thứ ngoài đời nằm ở giữa. Và mức độ hồi quy cho ta biết điều gì đó quan trọng: khi một thứ hạng hồi quy mạnh, phần lớn khác biệt trong thứ hạng ấy là may rủi. Khi nó giữ vững, phần lớn là thực lực.
Galton và chiều cao của những đứa trẻ
Chữ “regression” trong thống kê bắt nguồn từ chính hiện tượng này.
Cuối thế kỷ 19, Francis Galton so sánh chiều cao của cha mẹ với chiều cao của con cái khi trưởng thành[2]. Ông nhận thấy cha mẹ rất cao thường có con cao, nhưng trung bình thấp hơn cha mẹ một chút. Cha mẹ rất thấp thường có con thấp, nhưng trung bình cao hơn cha mẹ một chút. Ông gọi đó là sự “hồi quy về mức tầm thường” (regression towards mediocrity), và cái tên “regression” ở lại với thống kê từ đó.
Điều thú vị là hiện tượng này đúng theo cả hai chiều. Nếu bắt đầu từ những đứa trẻ rất cao rồi nhìn ngược lại cha mẹ chúng, ta cũng thấy cha mẹ trung bình thấp hơn con. Không có cơ chế sinh học nào khiến con “kéo” cha mẹ về trung bình. Đó là dấu hiệu cho thấy hồi quy về trung bình là một hệ quả thống kê của việc chọn ra những giá trị cực đoan từ một đại lượng có phần ngẫu nhiên, chứ không phải một quan hệ nhân quả.
Nó cũng không có nghĩa là mọi người dần trở nên giống nhau. Qua các thế hệ, sự đa dạng về chiều cao không biến mất. Những người cao nhất thế hệ sau phần lớn đến từ các gia đình khá cao, cộng thêm một chút may mắn di truyền mới.
Thuốc, huấn luyện viên và lời nguyền trang bìa
Khi đã quen với cơ chế này, bạn sẽ thấy nó ở khắp nơi. Và nguy hiểm nhất là khi ta gán cho nó một nguyên nhân.
Uống thuốc lúc đau nhất. Người ta thường đi khám hoặc tìm đến một phương thuốc khi triệu chứng tệ nhất. Nhiều cơn đau, cơn cảm hay đợt dị ứng vốn lên xuống theo thời gian. Vì vậy sau khi dùng thuốc, triệu chứng rất hay giảm, dù thuốc có tác dụng hay không. Đây là một trong những lý do các thử nghiệm y khoa cần nhóm đối chứng: một nhóm bệnh nhân tương tự không nhận thuốc thật, để xem phần cải thiện nào tự nhiên đã xảy ra.
Sa thải huấn luyện viên. Một đội bóng thua liên tiếp năm trận, ban lãnh đạo thay huấn luyện viên, và đội thắng ngay mấy trận sau đó. Tân huấn luyện viên có thể thực sự giỏi. Nhưng chuỗi năm trận thua có thể một phần là xui xẻo, và xui xẻo thì không kéo dài mãi. Muốn biết việc thay người có tác dụng không, cần so với những đội có chuỗi thua tương tự mà không thay huấn luyện viên.
Lời nguyền trang bìa. Có một niềm tin phổ biến rằng vận động viên được lên trang bìa tạp chí thể thao thì sau đó phong độ đi xuống. Nhưng người ta được lên bìa chính vì vừa có một giai đoạn xuất sắc, thường là thực lực cộng với một chuỗi may mắn. Phong độ sau đó trở về gần mức bình thường của họ là điều nên kỳ vọng, không cần đến lời nguyền nào.
Ba câu chuyện có chung một khuôn mẫu: ta hành động đúng lúc mọi thứ cực đoan nhất, rồi thấy mọi thứ trở lại bình thường, và kết luận rằng hành động của mình đã tạo ra sự thay đổi. Thầy dạy bay mắng học viên đúng lúc họ vừa hạ cánh tệ nhất. Không có nhóm đối chứng, lời mắng nhận hết công lao của may rủi.
“Vinh quang là nhất thời, đẳng cấp là mãi mãi”
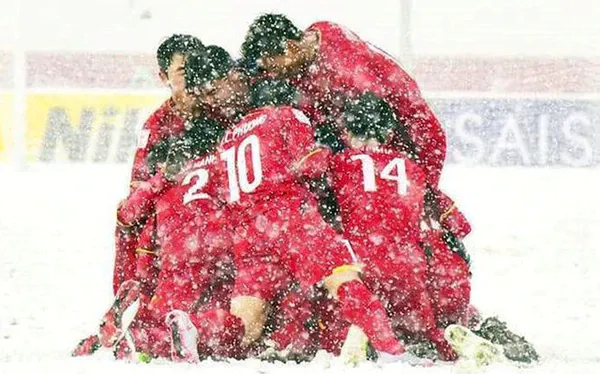
Người hâm mộ thể thao Việt Nam hẳn đã quen cảm giác này. Sau một chức vô địch, kỳ vọng dâng lên rất cao. Rồi đến giải tiếp theo, đội tuyển thi đấu không còn thăng hoa như trước, và làn sóng chỉ trích ập đến: cầu thủ tự mãn, huấn luyện viên hết bài, liên đoàn quản lý kém.
Một bài viết trên CafeBiz năm 2021 đã nhìn hiện tượng “Việt Nam vô địch” qua lăng kính hồi quy về trung bình[5]. Luận điểm của bài: sau một đỉnh cao, việc phong độ đi xuống là xu hướng tự nhiên. Vì thế người hâm mộ không nên chỉ trích thái quá khi đội thua, cũng không nên tung hô thái quá khi đội thắng, mà nên nhìn vào đẳng cấp thật của đội bóng.
Câu nói quen thuộc trong thể thao, “vinh quang là nhất thời, đẳng cấp là mãi mãi”, thực ra chính là công thức ở phần trước viết bằng lời:
Một đội vô địch là đội có phong độ cao nhất giải đó. Cũng như nhóm học sinh đứng đầu bài kiểm tra, đội ấy gần như chắc chắn vừa có đẳng cấp tốt, vừa gặp những điều thuận lợi: một quả bóng dội cột đi vào thay vì đi ra, một đối thủ mạnh bị chấn thương, một quyết định trọng tài có lợi. Giải sau, đẳng cấp vẫn còn, nhưng những điều thuận lợi ấy phải được “tung lại” từ đầu.
Có hai điều nên bổ sung để luận điểm này không bị đẩy đi quá xa.
Thứ nhất, hồi quy về trung bình là một kỳ vọng, không phải định mệnh. Nó không nói đội vô địch chắc chắn sẽ sa sút, chỉ nói rằng tính trung bình, thành tích lần sau sẽ gần mức đẳng cấp thật của đội hơn. Mức “trở về” nhiều hay ít phụ thuộc vào : một đội vô địch chủ yếu nhờ đẳng cấp vượt trội sẽ ít bị kéo xuống, còn một đội vô địch nhờ một giải đấu mà mọi thứ đều suôn sẻ thì bị kéo xuống nhiều hơn.
Thứ hai, không phải mọi sự sa sút sau chức vô địch đều là thống kê. Đối thủ sẽ nghiên cứu kỹ đội vô địch và tìm cách khắc chế. Cầu thủ lớn tuổi hơn, lực lượng thay đổi. Đây là những cơ chế có thật, tách biệt với hồi quy về trung bình. Bài học của thống kê không phải là “đừng bao giờ tìm nguyên nhân”, mà là đừng mặc định mọi sự thay đổi sau một đỉnh cao đều cần một nguyên nhân. Một phần của nó chỉ đơn giản là may mắn không đến hai lần.
Với người hâm mộ, điều này dẫn đến một thái độ công bằng hơn: đánh giá đội bóng qua nhiều giải đấu thay vì một giải, và không vội vàng tìm người để trách chỉ vì đội không lặp lại được một đỉnh cao đặc biệt.
Cổ phiếu có hồi quy về trung bình không?
Bây giờ hãy đưa câu hỏi vào thị trường. Mỗi năm, các bảng xếp hạng “cổ phiếu tăng mạnh nhất năm” lại thu hút sự chú ý. Nếu hồi quy về trung bình đúng với điểm thi và chiều cao, nó có đúng với cổ phiếu không, và mạnh đến mức nào?
Để trả lời, hãy so sánh hai đại lượng trên cùng một bộ dữ liệu:
- Lợi suất năm: cổ phiếu tăng hay giảm bao nhiêu phần trăm trong năm.
- Độ biến động năm: giá cổ phiếu dao động mạnh hay êm đến đâu từ ngày này sang ngày khác, đo bằng độ lệch chuẩn của lợi suất ngày, quy về năm.
Với mỗi năm, các cổ phiếu được xếp hạng theo phần trăm (percentile): 0% là thấp nhất, 100% là cao nhất. Sau đó ta xem năm tiếp theo, những cổ phiếu từng đứng đầu hay đứng cuối được xếp ở đâu.
Độ biến động: một ví dụ mẫu mực
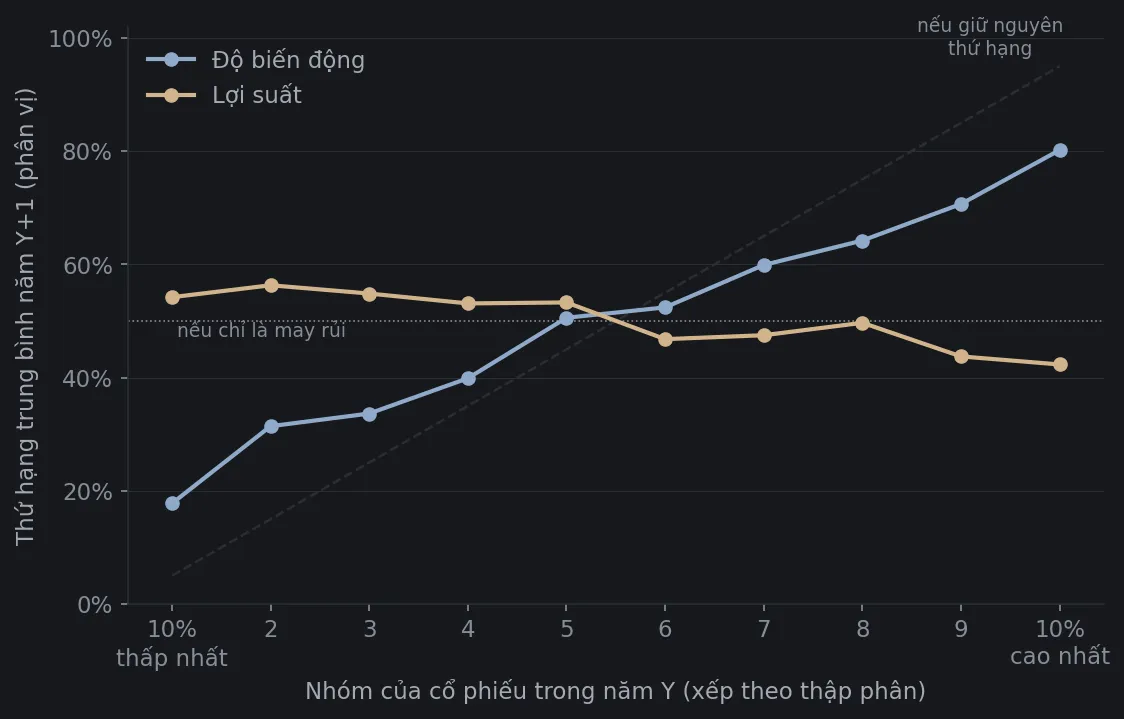
Đường màu xanh là độ biến động. Hệ số tương quan thứ hạng giữa hai năm liền nhau trung bình là +0,63.
Nhóm 10% cổ phiếu biến động mạnh nhất năm nay, sang năm sau vẫn đứng ở vị trí trung bình 80%: vẫn thuộc nhóm biến động mạnh, nhưng không còn cực đoan như trước. Nhóm 10% êm nhất năm nay, sang năm sau đứng ở mức 18%: vẫn êm, nhưng bớt êm.
Đây đúng là hình ảnh của lớp học ở phần đầu. Độ biến động có một phần “thực lực”: một cổ phiếu ngân hàng lớn khó mà dao động như một cổ phiếu nhỏ, thanh khoản thấp. Nhưng nó cũng có một phần “may rủi”: một năm có tin sốc, một năm yên ả. Phần thực lực ở lại, phần may rủi thì không.
Lợi suất: còn hơn cả hồi quy
Đường màu vàng là lợi suất, và nó kể một câu chuyện khác hẳn.
Hệ số tương quan thứ hạng giữa hai năm liền nhau trung bình là −0,14, tức là âm. Nhóm 10% tăng mạnh nhất năm nay, sang năm sau chỉ đứng ở vị trí trung bình 42%, dưới cả mức 50% mà may rủi thuần túy tạo ra. Nhóm 10% giảm mạnh nhất năm nay, sang năm sau lại đứng ở mức 54%.
Nếu chỉ có hồi quy về trung bình, các nhóm cực đoan sẽ trở về khoảng 50%. Ở đây chúng còn đi quá mức đó một chút, sang phía ngược lại. Nhìn riêng 20 cổ phiếu tăng mạnh nhất mỗi năm:
| Năm Y | Trung vị lợi suất năm Y | Trung vị năm Y+1 | Trung vị toàn thị trường năm Y+1 |
|---|---|---|---|
| 2017 | +154% | −14% | −8% |
| 2018 | +77% | −5% | +1% |
| 2019 | +98% | +18% | +29% |
| 2020 | +178% | +82% | +61% |
| 2021 | +363% | −72% | −40% |
| 2022 | +22% | −2% | +24% |
| 2023 | +134% | +15% | +10% |
| 2024 | +91% | −7% | +4% |
Trong 8 năm, có 6 năm nhóm “quán quân” có lợi suất năm sau thấp hơn trung vị toàn thị trường. Trong 160 lượt cổ phiếu từng lọt top 20, chỉ có 8 lượt, tức 5%, còn nằm trong nhóm 10% tăng mạnh nhất ở năm tiếp theo. Nếu thứ hạng hoàn toàn ngẫu nhiên, con số này phải vào khoảng 10%.
Năm 2021 là ví dụ rõ nhất. Nhóm 20 mã tăng mạnh nhất năm đó có mức tăng trung vị +363%. Năm 2022, chính nhóm này giảm trung vị −72%, trong khi toàn thị trường giảm 40%.
Để chắc chắn kết quả không do vài điểm bất thường tạo ra, phân tích được chạy lại theo hai cách. Cách thứ nhất bỏ những mã có phiên biến động quá 20% trong ngày (thường là mã nhỏ từng giao dịch trên UPCoM hoặc HNX, hoặc dữ liệu có vấn đề). Cách thứ hai bỏ giai đoạn sóng lớn 2020–2022. Cả hai lần, hệ số tương quan của lợi suất vẫn khoảng −0,13 đến −0,14, và của độ biến động vẫn khoảng +0,61 đến +0,64.
Đọc kết quả này thế nào?
Điều chắc chắn nhất rút ra từ dữ liệu: thứ hạng lợi suất năm nay gần như không nói gì tốt về thứ hạng năm sau. Phần “thực lực” trong bảng xếp hạng lợi suất một năm, nếu có, bị che lấp hoàn toàn bởi may rủi và những yếu tố khác. Một cổ phiếu đứng đầu bảng năm nay, xét theo thống kê, không có lợi thế gì cho năm sau.
Phần “đi quá” xuống dưới 50% khó giải thích chắc chắn hơn. Có ít nhất hai hướng cần kiểm chứng thêm. Một là nhà đầu tư có thể phản ứng thái quá, đẩy giá những cổ phiếu “nóng” lên quá cao rồi sau đó điều chỉnh. De Bondt và Thaler từng tìm thấy hiện tượng tương tự trên thị trường Mỹ ở khung thời gian ba đến năm năm[3]. Hai là các đợt sóng đầu cơ vào cổ phiếu nhỏ, như giai đoạn 2021–2022.
Nhưng cần thận trọng. Jegadeesh và Titman lại tìm thấy điều ngược lại ở khung ba đến mười hai tháng: cổ phiếu vừa tăng tốt thường tiếp tục tăng tốt thêm một thời gian, hiện tượng gọi là momentum[4]. Bài Gambler’s Fallacy cũng thấy VNINDEX có quán tính ở khung ngày trong giai đoạn 2004–2012. Kết quả phụ thuộc rất nhiều vào khung thời gian, cách đo và giai đoạn nghiên cứu.
Đoạn code dưới đây tái tạo hai hệ số tương quan trên. Cần cài vnstock, pandas và numpy. Việc tải dữ liệu 405 mã mất khoảng 7 đến 8 phút vì phải nghỉ giữa các lần gọi để không vượt giới hạn của gói miễn phí.
import time
import numpy as npimport pandas as pdfrom vnstock import Listing, Quote
lst = Listing().symbols_by_exchange()symbols = sorted(lst.query("exchange == 'HOSE' and type == 'stock'")["symbol"].unique())
closes = {}for sym in symbols:    try:        df = Quote(symbol=sym).history(start="2016-01-01", end="2025-12-31", interval="1D")        closes[sym] = df.set_index(pd.to_datetime(df["time"]).dt.normalize())["close"]    except Exception:        pass  # bỏ qua mã không lấy được dữ liệu    time.sleep(1.05)  # Tránh vượt giới hạn số request mỗi phút.
px = pd.DataFrame(closes).sort_index()daily = px.pct_change(fill_method=None)
# Chỉ giữ mã thực sự giao dịch trong năm: >= 200 phiên có giá, giá thay đổi ở ít nhất một nửa số phiênn_days = px.notna().groupby(px.index.year).sum()n_moved = (daily.fillna(0) != 0).groupby(daily.index.year).sum()active = (n_days >= 200) & (n_moved >= 0.5 * n_days)
year_end = px.groupby(px.index.year).last()ret = year_end.pct_change(fill_method=None).where(active)                      # lợi suất nămvol = (daily.where(daily.abs() <= 0.2).groupby(daily.index.year).std() * np.sqrt(250)).where(active)  # độ biến động năm
for name, x in [("Lợi suất", ret), ("Độ biến động", vol)]:    rhos, top_next = [], []    for y in range(2017, 2025):        a, b = x.loc[y], x.loc[y + 1]        ok = a.notna() & b.notna()        pa, pb = a[ok].rank(pct=True), b[ok].rank(pct=True)  # thứ hạng phần trăm trong từng năm        rhos.append(pa.corr(pb))        top_next.append(pb[pa > 0.9].mean())    print(f"{name:>13}: ρ trung bình = {np.mean(rhos):+.2f} | nhóm 10% cao nhất năm Y "          f"xếp hạng trung bình năm Y+1 = {np.mean(top_next):.0%}")
Lợi suất: ρ trung bình = -0.14 | nhóm 10% cao nhất năm Y xếp hạng trung bình năm Y+1 = 43% Độ biến động: ρ trung bình = +0.64 | nhóm 10% cao nhất năm Y xếp hạng trung bình năm Y+1 = 81%Các con số lệch một điểm phần trăm so với phần trên, vì đoạn code rút gọn lọc lợi suất và độ biến động riêng rẽ, còn phân tích chính chỉ giữ những mã có đủ cả hai đại lượng trong cả hai năm.
Bảng xếp hạng nào đáng tin?
Mỗi ngày ta gặp rất nhiều bảng xếp hạng: quỹ đầu tư hiệu quả nhất năm, cổ phiếu tăng mạnh nhất quý, chuyên gia dự báo chính xác nhất, nhân viên bán hàng giỏi nhất tháng, trường có điểm thi cao nhất tỉnh.
Hồi quy về trung bình không nói những bảng xếp hạng ấy vô nghĩa. Nó gợi ý một câu hỏi để đánh giá chúng: nếu xếp hạng lại vào kỳ sau, những người đứng đầu có còn đứng đầu không?
- Nếu có, như độ biến động của cổ phiếu hay thành tích chạy 100 mét, bảng xếp hạng phản ánh phần lớn là thực lực. Người đứng đầu đáng được tin hơn.
- Nếu không, như lợi suất cổ phiếu một năm, bảng xếp hạng phản ánh phần lớn là may rủi. Người đứng đầu có thể giỏi thật, nhưng chỉ riêng việc đứng đầu chưa chứng minh được điều đó.
Với một quỹ đầu tư, điều này có nghĩa là: một năm xuất sắc gần như không nói gì. Nhiều năm ổn định so với các quỹ tương tự, qua nhiều điều kiện thị trường khác nhau, mới bắt đầu nói lên điều gì đó. Và như bài nghịch lý ngày sinh nhật đã chỉ ra, khi có hàng nghìn quỹ, vài quỹ đứng đầu nhiều năm liền chỉ nhờ may mắn cũng là chuyện bình thường.
Ba câu hỏi trước khi kết luận “nó có tác dụng”
Mỗi khi thấy một sự thay đổi sau một hành động, nhất là hành động xảy ra đúng lúc mọi thứ tệ nhất hoặc tốt nhất, ba câu hỏi này giúp tránh bẫy hồi quy:
- Điểm xuất phát có phải là một điểm cực đoan không? Nếu ta chỉ chú ý hoặc chỉ hành động khi kết quả cao bất thường hay thấp bất thường, thì lần sau trở về gần bình thường là điều nên kỳ vọng, dù ta có làm gì hay không.
- Phần nào là thực lực, phần nào là may rủi? Kết quả càng phụ thuộc vào may rủi, hồi quy càng mạnh. Một cách ước lượng đơn giản là xem thứ hạng lặp lại đến đâu qua nhiều kỳ.
- Có nhóm đối chứng không? Chỉ khi so với những trường hợp tương tự nhưng không có hành động, ta mới tách được tác dụng thật khỏi sự trở về tự nhiên.
Quay lại người thầy dạy bay
Người thầy không sai khi quan sát. Sau một lần hạ cánh xuất sắc, lần sau đúng là thường kém hơn. Ông chỉ sai khi tin rằng chính lời khen của mình gây ra điều đó.
Hệ quả của niềm tin sai ấy không nhỏ. Nếu tin rằng mắng mỏ hiệu quả hơn khen ngợi, người ta sẽ mắng nhiều hơn, và mỗi lần học viên tiến bộ sau khi bị mắng, niềm tin ấy lại được củng cố. Nhiều người quản lý, cha mẹ hay huấn luyện viên có lẽ cũng đang học một bài học sai từ những quan sát đúng.
Điều đáng mang theo là: người đứng đầu hôm nay vừa giỏi vừa gặp may, và may mắn thì không lặp lại. Trước khi khen một phương pháp, đổ lỗi cho một lời khen, hay đặt tiền vào cổ phiếu vừa đứng đầu bảng, hãy hỏi xem phần nào của kết quả sẽ còn ở lại vào lần sau.
Tài liệu tham khảo
- [1]Amos Tversky và Daniel Kahneman. Judgment under Uncertainty: Heuristics and Biases. Science, 185(4157), 1124–1131, 1974.
- [2]Francis Galton. Regression Towards Mediocrity in Hereditary Stature. The Journal of the Anthropological Institute of Great Britain and Ireland, 15, 246–263, 1886.
- [3]Werner F. M. De Bondt và Richard Thaler. Does the Stock Market Overreact?. The Journal of Finance, 40(3), 793–805, 1985.
- [4]Narasimhan Jegadeesh và Sheridan Titman. Returns to Buying Winners and Selling Losers: Implications for Stock Market Efficiency. The Journal of Finance, 48(1), 65–91, 1993.
- [5]Huyền Băng. "Việt Nam vô địch" nhìn từ học thuyết hồi quy trung bình. CafeBiz (theo Doanh Nghiệp Tiếp Thị), 2021.