Mang súng lên xe buýt để không ai khác mang súng? Khi trực giác tin rằng may rủi biết bù trừ
Ngộ nhận của người đánh bạc: vì sao đồng xu không nợ bạn một lần ngửa, vì sao con lô gan không "sắp về", và 22 năm dữ liệu VNINDEX nói gì về niềm tin "giảm nhiều thì sắp hồi".
Mục lục
Người mang súng lên xe buýt
Có một câu chuyện đùa, thường được kể với quả bom trên máy bay. Đây là phiên bản xe buýt.
Một người rất sợ đi xe buýt vì lo trên xe có ai đó mang súng. Một hôm anh đọc được rằng xác suất có hai người cùng mang súng trên một chuyến xe là cực kỳ nhỏ. Anh thở phào và nghĩ ra giải pháp: từ nay, mỗi lần lên xe, anh tự mang theo một khẩu. Như vậy trên xe đã có một người mang súng, và khả năng có thêm người thứ hai là gần như bằng không.
Ai nghe cũng thấy buồn cười. Khẩu súng trong túi anh ta không làm những hành khách khác thay đổi ý định. Người nào định mang súng lên xe hôm đó vẫn sẽ mang, dù anh có mang hay không.
Nhưng nếu bạn thấy lập luận ấy vô lý, hãy xem mình có từng nghĩ theo những cách dưới đây không.
Chúng ta làm điều này mỗi ngày
Một cặp vợ chồng đã có ba con gái. Họ hàng động viên: “Sinh thêm đứa nữa đi, ba đứa gái rồi thì lần này chắc chắn là con trai.”
Một đồng xu vừa ra sấp năm lần liên tiếp. Người đứng xem thì thầm: “Lần này đặt ngửa, nó phải cân bằng lại chứ.”
Một con số lô đã hai mươi ngày chưa về. Người chơi gọi nó là “lô gan” và tin rằng nó “sắp đến lượt”.
Ba câu chuyện có chung một cấu trúc với anh chàng mang súng. Tất cả đều tin rằng những gì đã xảy ra sẽ làm thay đổi cơ hội của lần tiếp theo, trong khi lần tiếp theo không hề “biết” gì về quá khứ.
Niềm tin này có tên riêng: gambler’s fallacy, ngộ nhận của người đánh bạc. Đây là bài thứ ba trong loạt bài về những lúc trực giác phản bội ta, sau Monty Hall và nghịch lý ngày sinh nhật.
Hai câu hỏi khác nhau
Quay lại đồng xu. Xác suất tung sáu lần liên tiếp đều ra sấp là:
Con số này đúng, và rất nhỏ. Người đứng xem có lẽ đang nghĩ đến nó.
Nhưng câu hỏi họ thực sự cần trả lời là: khi đã ra sấp năm lần rồi, lần thứ sáu ra sấp với xác suất bao nhiêu? Năm lần đầu đã xảy ra, không còn là chuyện may rủi nữa. Chỉ còn lại một lần tung, và lần tung ấy vẫn là một đồng xu công bằng:
Hai con số khác nhau vì chúng trả lời hai câu hỏi khác nhau. Con số là xác suất để cả chuỗi xảy ra, nhìn từ trước khi tung. Con số là xác suất của lần tiếp theo, khi phần đầu của chuỗi đã là sự thật.
Anh chàng mang súng mắc đúng lỗi này. Xác suất “hai người mang súng” là xác suất của cả hai sự kiện cùng xảy ra. Khi anh đã tự mang một khẩu, câu hỏi còn lại chỉ là “có người khác mang súng hay không”, và xác suất đó không đổi.
Viết gọn bằng ký hiệu: là xác suất cả A lẫn B xảy ra, còn là xác suất B xảy ra khi đã biết A xảy ra. Nếu A và B độc lập, nghĩa là việc A xảy ra không làm thay đổi cơ hội của B, thì:
Tích thì nhỏ. Nhưng một khi A đã xảy ra, thứ còn lại là , và nó không hề nhỏ đi.
Nếu bạn đã đọc bài về nghịch lý ngày sinh nhật, bạn sẽ thấy một mô típ quen thuộc: trực giác không tính sai, nó chỉ trả lời nhầm câu hỏi.
Luật số lớn không bù trừ, nó pha loãng
Nếu từng lần tung độc lập, tại sao tung thật nhiều thì tỷ lệ ngửa lại tiến về 50%? Chẳng lẽ không có một lực nào đó kéo kết quả về cân bằng?
Đây là chỗ trực giác bị lừa tinh vi nhất. Luật số lớn (law of large numbers) nói rằng khi số lần tung tăng lên, tỷ lệ mặt ngửa tiến về 50%. Nó không nói rằng số lần ngửa và sấp sẽ bằng nhau, cũng không nói phần lệch sẽ được “trả lại”.
Hình dưới là sáu lần mô phỏng, mỗi lần tung 10.000 lần. Bên trái là tỷ lệ mặt ngửa: sáu đường dao động mạnh lúc đầu rồi dồn dần về 50%. Bên phải là hiệu số “số lần ngửa trừ số lần sấp” của chính sáu lần tung ấy. Không có đường nào bị kéo về 0. Có đường trôi lên hơn 200, có đường xuống dưới −100. Vùng xám cho biết hiệu số thường lớn cỡ nào: nó rộng dần theo căn bậc hai của số lần tung.
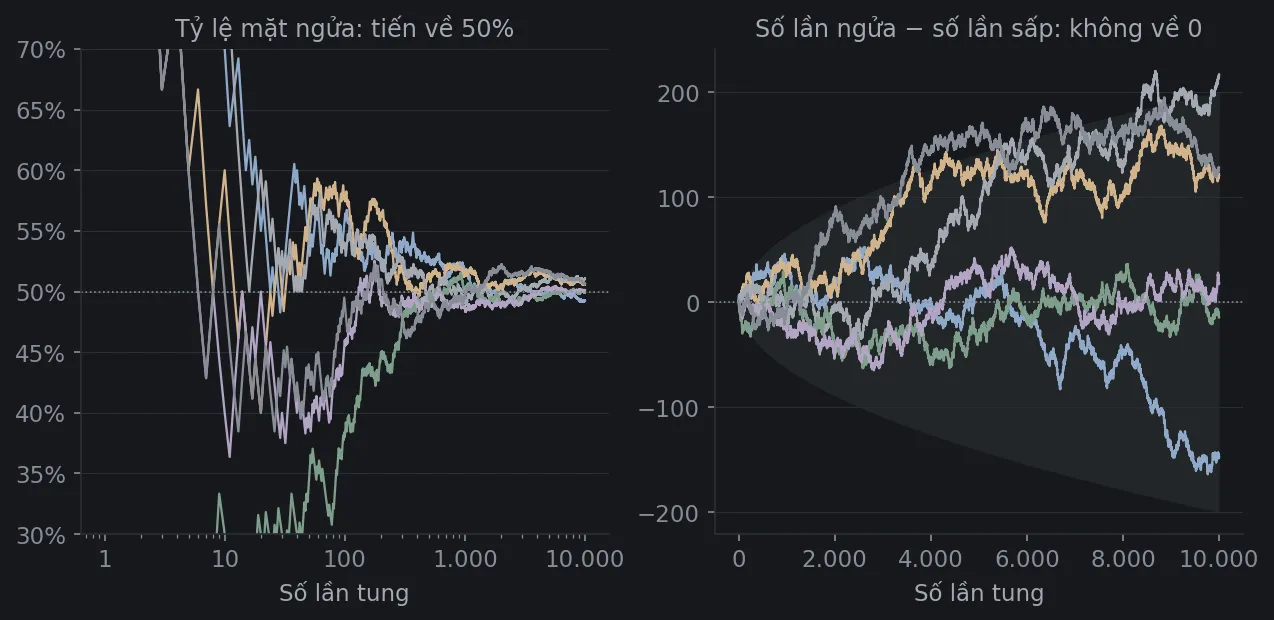
Hai điều này không mâu thuẫn nhau. Thử với một đoạn Python chỉ dùng thư viện chuẩn:
import random
rng = random.Random(2026)  # Cố định seed để chạy lại ra cùng kết quả.heads = 0
for n in range(1, 1_000_001):    heads += rng.random() < 0.5    if n in (10, 100, 1_000, 10_000, 100_000, 1_000_000):        tails = n - heads        print(f"{n:>9,} lần | tỷ lệ ngửa {heads / n:.4f} | ngửa − sấp = {heads - tails:+}")
10 lần | tỷ lệ ngửa 0.3000 | ngửa − sấp = -4 100 lần | tỷ lệ ngửa 0.4300 | ngửa − sấp = -14 1,000 lần | tỷ lệ ngửa 0.4950 | ngửa − sấp = -10 10,000 lần | tỷ lệ ngửa 0.5122 | ngửa − sấp = +244 100,000 lần | tỷ lệ ngửa 0.5020 | ngửa − sấp = +4001,000,000 lần | tỷ lệ ngửa 0.5007 | ngửa − sấp = +1488Sau một triệu lần tung, số lần ngửa nhiều hơn số lần sấp gần 1.500 lần. Vậy mà tỷ lệ vẫn là 50,07%. Phần lệch không biến mất. Nó bị pha loãng: một khoản chênh vài trăm hay vài nghìn trở nên nhỏ xíu khi chia cho một triệu.
Tính trung bình, hiệu số lớn cỡ : khoảng 8 sau 100 lần tung, khoảng 80 sau 10.000 lần. Hiệu số lớn dần, nhưng chậm hơn nhiều so với số lần tung, nên tỷ lệ vẫn hội tụ.
Người đánh bạc hình dung luật số lớn như một người kế toán: lệch bao nhiêu thì sớm muộn phải bù lại bấy nhiêu. Thực tế nó giống một cốc nước pha màu hơn. Giọt màu vẫn ở đó, chỉ là ta liên tục đổ thêm nước.
Tversky và Kahneman gọi niềm tin sai này là “luật số nhỏ” (law of small numbers): ta kỳ vọng một mẫu nhỏ cũng phải trông giống tổng thể, như thể năm lần tung cũng phải chia đều sấp ngửa[1]. Khi mẫu nhỏ trông “lệch”, ta tưởng tương lai sẽ phải sửa nó.
Chuỗi dài bình thường hơn ta nghĩ
Nếu mọi lần tung đều độc lập, thì năm lần sấp liên tiếp có gì lạ? Câu trả lời là chẳng có gì lạ cả, và con số sau cho thấy điều đó rõ hơn.
Trước khi đọc tiếp, thử làm một thí nghiệm nhỏ. Dưới đây là hai dãy 40 lần tung (S là sấp, N là ngửa). Một dãy do máy tính tạo ngẫu nhiên. Dãy còn lại do một người tự nghĩ ra sao cho “trông thật ngẫu nhiên”. Bạn đoán dãy nào là thật?
Dãy A: S N N S N S S N S N N S N S S N N S N S S N S N N S S N S N S N N S N S S N N SDãy B: N N S N S N N S N S S S N S S S S S S N S N N S S S S N S N N N S S N S N N N SPhần lớn mọi người chọn A, vì B có một đoạn sáu chữ S liền nhau, “không giống ngẫu nhiên chút nào”.
Dãy thật là B. Dãy A là dãy bịa, và nó lộ ra ở hai chỗ. Chuỗi dài nhất của nó chỉ có hai ký tự giống nhau. Và nó đổi mặt 28 trong 39 lần chuyển, trong khi một dãy ngẫu nhiên trung bình chỉ đổi khoảng 19–20 lần. Người bịa dãy số né chuỗi dài vì cảm thấy chúng “không đúng”, nên họ đổi mặt quá thường xuyên.
Máy tính cho biết chuỗi dài xuất hiện thường xuyên thế nào. Mô phỏng 50.000 lần, mỗi lần tung 100 lần:
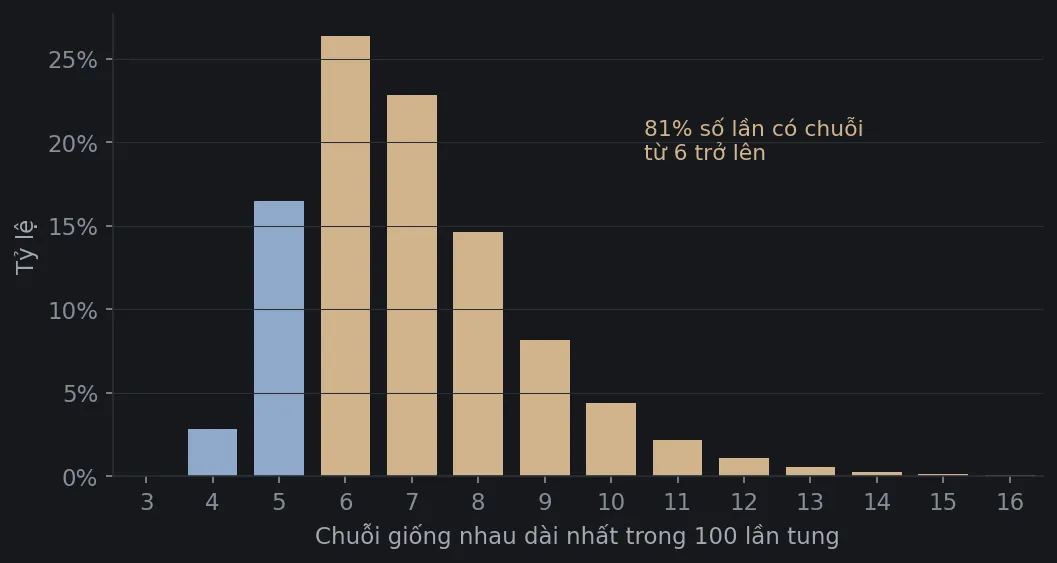
Năm lần sấp liên tiếp không phải điềm báo gì cả. Trong một trăm lần tung, gần như chắc chắn sẽ có ít nhất một đoạn như thế. Nếu một dãy dài không có chuỗi nào như vậy, đó mới là điều đáng nghi.
Lô gan: con số “sắp về”
Xổ số kiến thiết miền Bắc mỗi kỳ quay 27 lần[5]. “Lô” là hai chữ số cuối của mỗi kết quả, từ 00 đến 99. Một con số không xuất hiện trong nhiều kỳ liên tiếp được gọi là “lô gan”, và không ít người tin rằng càng gan lâu thì càng “sắp về”.
Giả sử hai chữ số cuối của mỗi lần quay là ngẫu nhiên đều và độc lập, như một bộ máy quay số công bằng cần đạt được. Khi đó một con số cụ thể không xuất hiện trong một kỳ với xác suất:
Gan 10 kỳ liên tiếp có xác suất . Nghe có vẻ hiếm. Nhưng có tới 100 con số, và một năm có 365 kỳ. Đây lại là bài toán của nghịch lý ngày sinh nhật: với rất nhiều cơ hội, điều “hiếm” gần như chắc chắn xảy ra ở đâu đó.
Mô phỏng 3.000 năm quay số giả định cho thấy con số gan nhất năm trung bình gan khoảng 35 kỳ, và trong 90% số năm nằm trong khoảng 29 đến 43 kỳ.
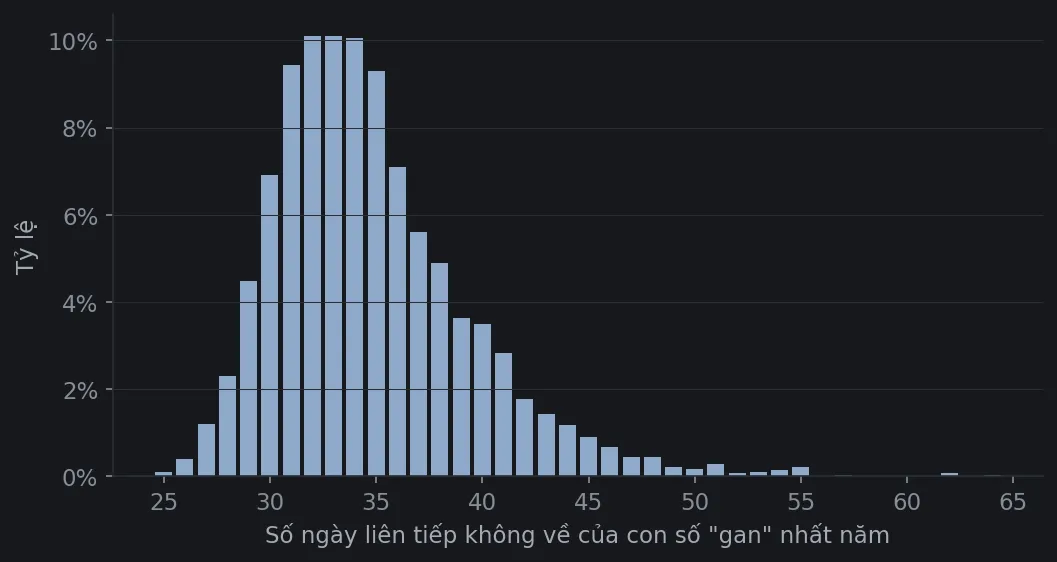
Vậy một con số đã gan 30 kỳ nói cho ta điều gì về kỳ quay ngày mai? Không gì cả. Bộ máy quay số không ghi nhớ con số nào đã lâu chưa ra. Mỗi kỳ, xác suất để con số ấy xuất hiện vẫn là , như mọi con số khác.
Khi nào quá khứ thật sự quan trọng?
Đến đây rất dễ đi quá đà và kết luận rằng quá khứ không bao giờ ảnh hưởng tương lai. Điều đó cũng sai. Gambler’s fallacy chỉ là ngộ nhận khi các lần thử thật sự độc lập. Có rất nhiều tình huống không như vậy:
- Rút bài không hoàn lại. Một bộ bài 52 lá có 4 lá Át. Nếu ba lá Át đã ra, lá Át cuối cùng thực sự hiếm hơn trong phần bài còn lại. Quá khứ đã lấy đi một số lá, nên nó thay đổi xác suất của lần rút sau.
- Có một cơ chế vật lý. Một chiếc máy chạy càng lâu càng hao mòn, xác suất hỏng tăng dần. Một kho hàng bán mãi rồi cũng hết.
- Các sự kiện liên quan với nhau. Hãy đảo ngược câu chuyện mang súng. Nếu có một nhóm cướp lên xe cùng nhau, việc thấy một người mang súng khiến khả năng có người thứ hai mang súng cao hơn, không thấp hơn.
Câu hỏi đúng không phải là “quá khứ có quan trọng không”, mà là “có cơ chế nào để quá khứ ảnh hưởng đến lần tiếp theo không”. Với đồng xu, máy quay số công bằng hay giới tính thai nhi, câu trả lời là không. Với bộ bài, cỗ máy hay nhóm cướp, câu trả lời là có.
Ngộ nhận ngược chiều: bàn tay nóng
Gambler’s fallacy tin rằng may rủi sắp đổi chiều. Có một niềm tin ngược lại, cũng phổ biến không kém: đang may thì sẽ còn may. Người xem bóng rổ gọi đó là hot hand, bàn tay nóng: cầu thủ vừa ném trúng vài quả liên tiếp thì quả tiếp theo cũng dễ trúng hơn.
Năm 1985, Gilovich, Vallone và Tversky phân tích dữ liệu ném bóng và kết luận không tìm thấy bằng chứng cho bàn tay nóng. Theo họ, người xem chỉ đang nhìn thấy khuôn mẫu trong những chuỗi ngẫu nhiên[2]. Kết quả này trở thành một ví dụ kinh điển về ảo giác nhận thức.
Hơn ba mươi năm sau, Miller và Sanjurjo chỉ ra một chi tiết thống kê tinh vi trong cách phân tích ấy[3]. Với một dãy tung đồng xu hữu hạn, nếu ta tính “tỷ lệ ngửa ngay sau một lần ngửa” trong từng dãy rồi lấy trung bình, kết quả thấp hơn 50% một cách có hệ thống. Chẳng hạn với các dãy 4 lần tung, trung bình ấy chỉ là , dù đồng xu hoàn toàn công bằng. Khi điều chỉnh cho thiên lệch này, chính dữ liệu từng được dùng để bác bỏ bàn tay nóng lại cho thấy dấu hiệu ủng hộ nó.
Câu chuyện này có hai bài học. Thứ nhất, trực giác có thể sai theo cả hai chiều: tin rằng sắp đổi chiều, hoặc tin rằng sẽ còn tiếp diễn. Thứ hai, ngay cả phương pháp kiểm tra một niềm tin cũng có thể chứa bẫy. Đó là lý do phần phân tích thị trường dưới đây luôn so sánh với một mô phỏng đối chứng được tính theo đúng cùng một cách.
Thị trường có trí nhớ không?
Trên thị trường chứng khoán, gambler’s fallacy mang một cái tên nghe chuyên nghiệp hơn: “giảm nhiều thì sắp hồi”. Sau vài phiên đỏ liên tiếp, không ít người tin rằng phiên xanh “phải đến”.
Nhưng thị trường không phải đồng xu. Có những cơ chế có thể khiến hôm nay liên quan đến hôm qua: tin tức được phản ánh dần, dòng tiền đến chậm, hay giới hạn biên độ giá. Vì vậy câu hỏi không thể trả lời bằng lý thuyết suông. Cần nhìn vào dữ liệu.
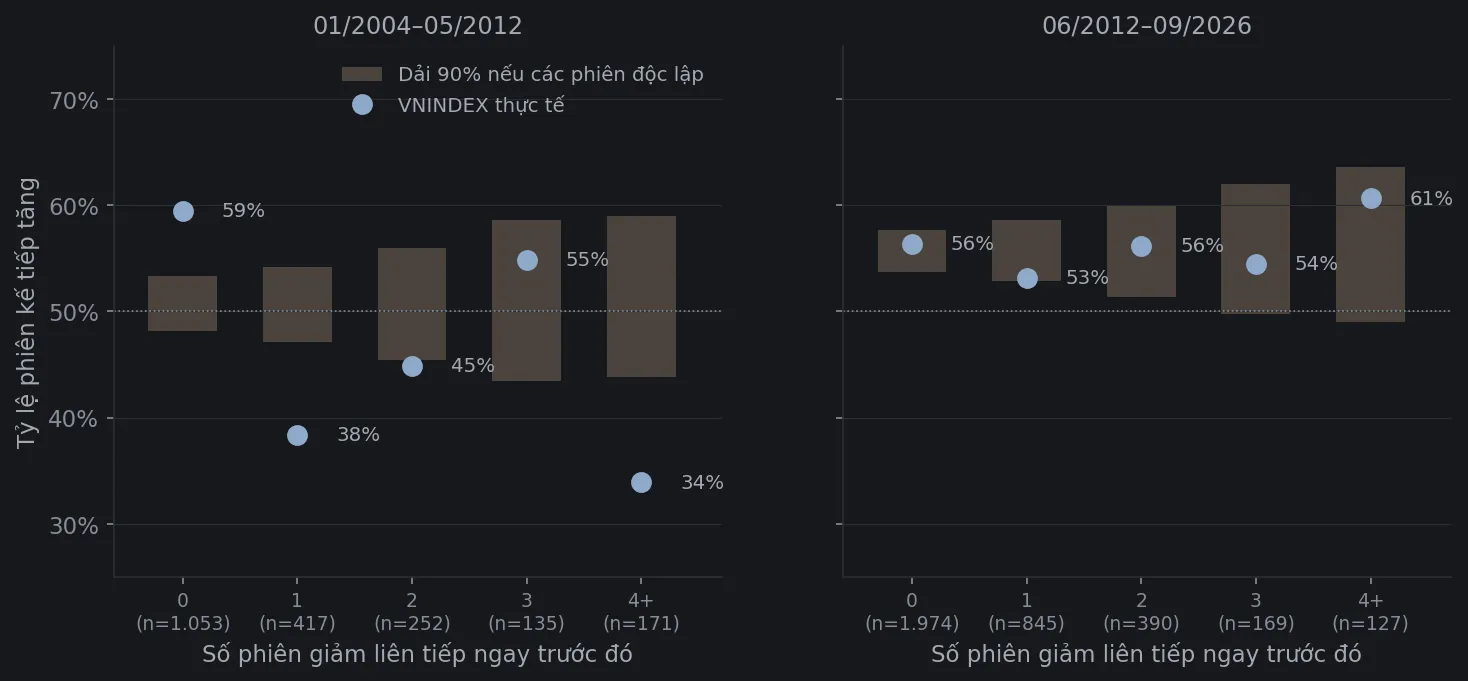
Ta lấy VNINDEX từ 01/2004 đến 09/2026, tức khoảng 22 năm. Với mỗi phiên, ta đếm xem ngay trước đó có bao nhiêu phiên giảm liên tiếp, rồi xem phiên đó tăng hay giảm. Nếu “giảm nhiều thì sắp hồi” là đúng, tỷ lệ tăng sau một chuỗi giảm dài phải cao hơn bình thường.
Để biết thế nào là “cao hơn bình thường”, ta cần một mốc so sánh. Ta mô phỏng một thị trường giả định trong đó các phiên hoàn toàn độc lập, với tỷ lệ phiên tăng bằng đúng thực tế, rồi tính theo cùng một cách. Mô phỏng này cho biết con số dao động trong khoảng nào chỉ do may rủi, và nó tự động chứa luôn loại thiên lệch mà Miller và Sanjurjo cảnh báo.
2004–2012: thị trường có trí nhớ, nhưng là trí nhớ ngược
Ở giai đoạn đầu, các phiên rõ ràng không độc lập. Nhưng hướng của sự phụ thuộc ngược với niềm tin “sắp hồi”:
- Sau một phiên không giảm, phiên kế tiếp tăng tới 59%, cao hơn hẳn mức trung bình 51%.
- Sau một phiên giảm, phiên kế tiếp chỉ tăng 38%.
- Sau chuỗi từ 4 phiên giảm trở lên, tỷ lệ tăng chỉ còn 34% (171 lần quan sát). Nếu các phiên độc lập, 90% số lần mô phỏng cho con số này nằm trong khoảng 44% đến 59%.
Giảm nhiều không làm thị trường sắp hồi. Ở giai đoạn này, giảm nhiều thường là dấu hiệu sẽ giảm tiếp. Đo bằng hệ số tương quan giữa lợi suất hôm nay và hôm qua, ta được +0,26: một mức quán tính rõ rệt.
Vì sao? Dữ liệu không trả lời được câu hỏi này, nhưng có ít nhất hai giả thuyết hợp lý cần kiểm chứng thêm. Thứ nhất, thị trường giai đoạn đầu thanh khoản mỏng, nhiều cổ phiếu không giao dịch mỗi phiên, nên chỉ số phản ánh thông tin với độ trễ. Hiện tượng này được Lo và MacKinlay phân tích về mặt lý thuyết từ năm 1990, dưới tên nonsynchronous trading[4]. Thứ hai, biên độ giá hẹp có thể khiến giá không điều chỉnh hết trong một phiên, phần còn lại dồn sang phiên sau.
Từ 2012 đến nay: gần như một đồng xu
Giai đoạn 06/2012 đến 09/2026 dài hơn và dữ liệu đáng tin cậy hơn. Ở đây bức tranh khác hẳn. Hệ số tương quan giữa hai phiên liền nhau chỉ còn +0,05. Mọi tỷ lệ trong hình đều nằm trong vệt “nếu các phiên độc lập”.
Sau chuỗi từ 4 phiên giảm trở lên, tỷ lệ tăng là 61% trên 127 lần quan sát. Con số này cao hơn mức trung bình 56% một chút, nhưng vẫn nằm trong khoảng mà may rủi đơn thuần tạo ra được (49% đến 63%).
Nếu chỉ nhìn giai đoạn 2021–2026, con số ấy lên tới 70%. Nghe rất hấp dẫn. Nhưng nó chỉ dựa trên 43 lần quan sát, và là con số nổi bật nhất trong rất nhiều cách cắt dữ liệu có thể thử. Đó chính là cái bẫy mà bài nghịch lý ngày sinh nhật đã cảnh báo: khi xem đủ nhiều con số, luôn có một con số trông đặc biệt.
Tóm lại, dữ liệu 22 năm của VNINDEX không ủng hộ niềm tin “giảm nhiều thì sắp hồi”. Ở giai đoạn đầu, thị trường có trí nhớ theo chiều ngược lại. Ở giai đoạn sau, trí nhớ ấy gần như biến mất. Và điều đáng chú ý nhất: tính chất của thị trường đã thay đổi theo thời gian. Một quy luật đúng trong mười năm có thể không còn đúng trong mười năm tiếp theo.
Đoạn code dưới đây tái tạo bảng số liệu của hình 4. Cần cài vnstock, pandas và numpy.
import numpy as npimport pandas as pdfrom vnstock import Quote
df = Quote(source="VCI", symbol="VNINDEX").history(start="2004-01-01", end="2026-09-25", interval="1D")px = df.set_index(pd.to_datetime(df["time"]).dt.normalize())["close"].loc["2004-01-01":"2026-09-25"]
# Làm sạch: bỏ hai điểm giá lỗi rõ ràng, và một phiên +8% vượt mọi biên độ từng áp dụng trên HOSEpx = px.drop(pd.to_datetime(["2007-07-23", "2008-08-16"]))r = px.pct_change().iloc[1:]days = px.index.values.astype("datetime64[D]")broken = np.busday_count(days[:-1], days[1:]) > 1  # thiếu ngày làm việc: nghỉ lễ hoặc dữ liệu thiếubroken |= r.index == pd.Timestamp("2007-01-19")

def after_down_streaks(r, broken, start, end):    sel = (r.index >= start) & (r.index < end)    ret, brk = r.to_numpy()[sel], broken[sel]    streak = np.zeros(len(ret), dtype=int)  # số phiên giảm liên tiếp ngay trước phiên i    for i in range(1, len(ret)):        if brk[i] or brk[i - 1]:            continue  # chuỗi bị ngắt ở chỗ dữ liệu đứt        streak[i] = streak[i - 1] + 1 if ret[i - 1] < 0 else 0    ok = ~brk    up, streak = ret[ok] > 0, streak[ok]    print(f"{start[:7]} → {end[:7]}: P(tăng) chung = {up.mean():.1%}")    for k in range(5):        m = streak >= 4 if k == 4 else streak == k        print(f"  sau {k}{'+' if k == 4 else ' '} phiên giảm: n = {m.sum():>5} | P(tăng) = {up[m].mean():.1%}")

after_down_streaks(r, broken, "2004-01-01", "2012-06-01")after_down_streaks(r, broken, "2012-06-01", "2026-09-26")
2004-01 → 2012-06: P(tăng) chung = 50.8% sau 0 phiên giảm: n = 1053 | P(tăng) = 59.4% sau 1 phiên giảm: n = 417 | P(tăng) = 38.4% sau 2 phiên giảm: n = 252 | P(tăng) = 44.8% sau 3 phiên giảm: n = 135 | P(tăng) = 54.8% sau 4+ phiên giảm: n = 171 | P(tăng) = 33.9%2012-06 → 2026-09: P(tăng) chung = 55.6% sau 0 phiên giảm: n = 1974 | P(tăng) = 56.3% sau 1 phiên giảm: n = 845 | P(tăng) = 53.1% sau 2 phiên giảm: n = 390 | P(tăng) = 56.2% sau 3 phiên giảm: n = 169 | P(tăng) = 54.4% sau 4+ phiên giảm: n = 127 | P(tăng) = 60.6%“Sau 0 phiên giảm” nghĩa là phiên liền trước không giảm (tăng hoặc đứng giá).
Ba câu hỏi trước khi nói “sắp đến lượt”
Dù là đồng xu, con lô, đứa con sắp chào đời hay một chuỗi phiên đỏ, ba câu hỏi này giúp tách trực giác khỏi thực tế:
- Các lần thử có thật sự độc lập không? Nếu có, quá khứ không nói gì về lần tiếp theo, dù chuỗi trước đó dài đến đâu.
- Nếu không độc lập, cơ chế là gì, và nó đẩy theo chiều nào? Bộ bài không hoàn lại làm lá hiếm càng hiếm. Thị trường thanh khoản mỏng có thể tạo quán tính chứ không tạo bù trừ. Đừng mặc định sự phụ thuộc luôn theo hướng “đổi chiều”.
- Mẫu có đủ lớn không, và mình đã thử bao nhiêu cách cắt dữ liệu trước khi thấy con số này? Một con số 70% trên 43 lần quan sát, được chọn ra từ rất nhiều cách chia, chưa phải là một quy luật.
Quay lại chuyến xe buýt
Anh chàng mang súng không làm chuyến xe an toàn hơn. Anh chỉ thêm một khẩu súng vào xe.
Người chơi đặt cửa ngửa sau năm lần sấp, người chờ con lô gan, người mua vào vì thị trường “đã giảm đủ rồi” đều đang làm điều tương tự: họ tưởng mình đang điều chỉnh xác suất, trong khi thực ra chỉ đang đặt cược thêm một lần nữa vào cùng một sự kiện, với đúng xác suất cũ.
Điều đáng mang theo là: may rủi không có trí nhớ, và nó không nợ ai điều gì. Khi thấy mình nghĩ “sắp đến lượt”, hãy hỏi xem có cơ chế nào thật sự tạo ra lượt ấy không. Nếu không có, thứ duy nhất đang ghi nhớ quá khứ là chính ta.
Tài liệu tham khảo
- [1]Amos Tversky và Daniel Kahneman. Belief in the law of small numbers. Psychological Bulletin, 76(2), 105–110, 1971.
- [2]Thomas Gilovich, Robert Vallone và Amos Tversky. The hot hand in basketball: On the misperception of random sequences. Cognitive Psychology, 17(3), 295–314, 1985.
- [3]Joshua B. Miller và Adam Sanjurjo. Surprised by the Hot Hand Fallacy? A Truth in the Law of Small Numbers. Econometrica, 86(6), 2019–2047, 2018.
- [4]Andrew W. Lo và A. Craig MacKinlay. An econometric analysis of nonsynchronous trading. Journal of Econometrics, 45(1–2), 181–211, 1990.
- [5]Cơ cấu giải thưởng xổ số truyền thống Miền Bắc. Minh Ngọc. Dùng để xác nhận mỗi kỳ quay 27 lần; cơ cấu giải có thể thay đổi theo thời gian.