CPU và GPU khác nhau thế nào? Vì sao AI cần GPU
CPU vài lõi mạnh, GPU hàng nghìn lõi nhỏ. Hai kiểu chip khác nhau ở đâu, vì sao card đồ họa chơi game lại thành cỗ máy chạy AI, và khi nào CPU vẫn thắng.
Mục lục
Mười năm trước, GPU là thứ dân chơi game mua để game chạy mượt hơn. Hôm nay, chính loại chip ấy đứng sau ChatGPT, sau những chiếc xe tự lái, và đã đưa Nvidia, công ty làm GPU, có lúc lên vị trí công ty giá trị nhất thế giới. Trong khi đó, máy tính nào cũng vẫn cần một con CPU. Vậy CPU và GPU khác nhau ở đâu? Cái nào mạnh hơn?
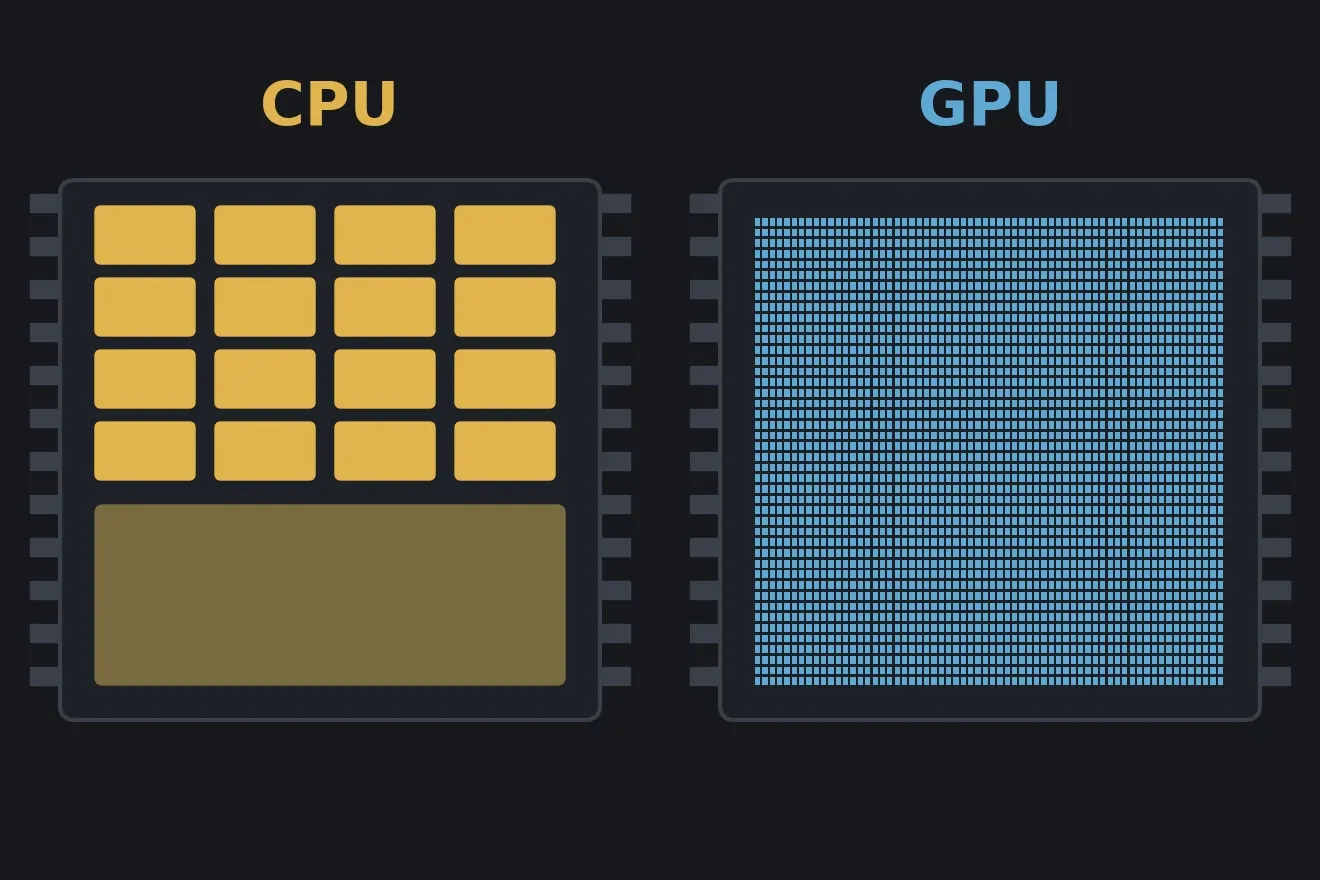
Câu trả lời ngắn: không cái nào mạnh hơn cái nào, chúng mạnh ở hai kiểu việc khác nhau. CPU (central processing unit, bộ xử lý trung tâm) có vài lõi rất mạnh, giỏi làm những việc rắc rối, nhiều rẽ nhánh, phải xong thật nhanh từng việc một. GPU (graphics processing unit, bộ xử lý đồ họa) có hàng nghìn lõi nhỏ và đơn giản, giỏi làm cùng một phép tính trên hàng triệu con số cùng lúc.
Bài này giải thích sự khác nhau ấy bằng ví dụ đời thường trước, rồi tới con số thật của hai con chip cụ thể, vì sao AI “nghiện” GPU, khi nào CPU vẫn thắng, và cuối cùng là một đoạn code nhỏ để tự kiểm chứng.
CPU và GPU khác nhau thế nào? Một phép so sánh
Hãy hình dung bạn phải chấm một triệu bài kiểm tra trắc nghiệm.
- Phương án CPU: thuê 16 giáo sư. Mỗi người cực kỳ giỏi, đọc nhanh, xử lý được cả những bài tô nhầm, gạch xóa, viết thêm ghi chú bên lề. Nhưng chỉ có 16 người.
- Phương án GPU: thuê 16.000 học sinh. Mỗi em chỉ biết đúng một việc: so đáp án với bảng đáp án rồi cộng điểm. Gặp bài lạ là lúng túng. Nhưng có tới 16.000 em, và việc chấm trắc nghiệm thì bài nào cũng giống bài nào.
Với một triệu bài trắc nghiệm, đội học sinh thắng áp đảo. Nhưng nếu việc cần làm là viết một bản báo cáo phân tích, trong đó mỗi đoạn phụ thuộc vào đoạn trước, thì 16.000 học sinh cũng không giúp được gì: chỉ một người viết được tại mỗi thời điểm, và người đó nên là giáo sư.
Đó chính là khác biệt cốt lõi:
- CPU được thiết kế để giảm độ trễ (latency): làm cho một việc xong càng sớm càng tốt.
- GPU được thiết kế để tăng thông lượng (throughput): làm cho thật nhiều việc giống nhau xong trong một giây, dù từng việc có thể chậm hơn.
Con số thật: Ryzen 9 9950X và RTX 4090
Lấy hai con chip phổ biến cho máy tính để bàn cao cấp làm ví dụ: CPU AMD Ryzen 9 9950X (ra mắt 2024) và GPU Nvidia GeForce RTX 4090 (ra mắt 2022)[1][2].
| CPU Ryzen 9 9950X | GPU RTX 4090 | |
|---|---|---|
| Số lõi | 16 lõi (32 luồng) | 16.384 lõi CUDA |
| Xung nhịp tối đa | 5,7 GHz | khoảng 2,5 GHz |
| Bộ nhớ đi kèm | RAM DDR5 của máy, có thể tới hàng trăm GB | 24 GB GDDR6X gắn ngay trên card |
| Băng thông bộ nhớ | khoảng 90 GB/s (DDR5-5600, hai kênh) | khoảng 1.000 GB/s |
| Công suất thiết kế | 170 W | 450 W |
Ba điều đáng để ý:
- GPU có số lõi gấp khoảng 1.000 lần, nhưng mỗi lõi chạy chậm hơn và đơn giản hơn nhiều. Xung nhịp (GHz) giống nhịp tay của người chấm bài: 5,7 GHz nghĩa là mỗi giây lõi CPU “gõ nhịp” 5,7 tỷ lần, mỗi nhịp làm được một bước nhỏ; lõi GPU chỉ gõ khoảng 2,5 tỷ nhịp.
- Bộ nhớ của GPU nhỏ hơn nhưng nhanh hơn khoảng 11 lần. Băng thông bộ nhớ giống số làn của con đường nối kho với xưởng: không phải xe chạy nhanh bao nhiêu, mà mỗi giây chở được bao nhiêu hàng. Đường của CPU như quốc lộ hai làn; đường của GPU như cao tốc hai mươi làn, nhưng kho bên cạnh nhỏ hơn. Với AI, đây thường là con số quan trọng nhất, ta sẽ quay lại ở dưới.
- GPU ăn điện gấp mấy lần. Hàng nghìn lõi cùng chạy thì phải trả giá bằng điện và nhiệt; bài AI và cơn khát điện kể chuyện này ở quy mô trung tâm dữ liệu.
Bên trong chip: diện tích dành cho cái gì?
Cả hai con chip đều được xây từ vài chục tỷ transistor, những công tắc bật/tắt tí hon (về transistor và kích thước “3 nm”, xem bài chip 3 nm là gì). Vậy vì sao một bên làm ra 16 lõi còn bên kia làm ra 16.000 lõi? Vì hai bên tiêu diện tích chip vào những thứ khác nhau.
CPU dồn diện tích cho sự thông minh của từng lõi[4]:
- Bộ nhớ đệm (cache) lớn. Giống giáo sư để sẵn những cuốn sách hay tra nhất ngay trên bàn, thay vì mỗi lần cần lại xuống thư viện (RAM) lấy. Lấy sách trên bàn mất một giây; xuống thư viện mất vài phút. Lõi CPU cũng vậy: đọc từ cache nhanh hơn đọc từ RAM hàng chục tới hàng trăm lần.
- Dự đoán rẽ nhánh. Khi chương trình gặp “nếu… thì…”, CPU không đứng chờ biết kết quả, mà đoán trước nhánh nào sẽ chạy và làm luôn. Giống cô bán cà phê thấy khách quen bước vào là pha sẵn ly bạc xỉu: đoán đúng thì khách khỏi chờ, đoán sai thì đổ đi pha lại, chỉ mất chút công. CPU ngày nay đoán đúng trong đại đa số trường hợp.
- Thực thi không theo thứ tự. Lệnh nào đã đủ nguyên liệu thì làm trước, không xếp hàng chờ lệnh đứng trước nó. Giống người nấu phở: trong lúc chờ nồi nước dùng sôi thì thái thịt, nhặt rau, chứ không đứng nhìn nồi.
Tất cả những bộ phận ấy chỉ nhằm một mục đích: một chuỗi lệnh đơn lẻ, đầy rẽ nhánh, chạy xong nhanh nhất có thể. Đó là kiểu việc của hệ điều hành, trình duyệt, Excel, máy chủ web.
GPU dồn diện tích cho số lượng bộ tính toán, và giải quyết vấn đề chờ bộ nhớ bằng một mẹo khác: giữ thật nhiều việc đang dở cùng lúc. Khi một nhóm luồng phải chờ dữ liệu từ bộ nhớ, GPU lập tức chuyển sang nhóm khác đã sẵn sàng. Giống người phục vụ ở một quán đông khách: bàn này đang chờ bếp nấu thì đi lấy order bàn khác, không đứng cạnh một bàn chờ món ra. Thay vì cố không bao giờ phải chờ (cách của CPU), GPU chấp nhận chờ nhưng luôn có việc khác để làm trong lúc chờ.
Vì sao GPU sinh ra cho đồ họa?
Màn hình 4K có triệu điểm ảnh. Chơi game ở 60 khung hình mỗi giây nghĩa là phải tính màu cho khoảng 500 triệu điểm ảnh mỗi giây. Màu của mỗi điểm ảnh được tính bằng cùng một công thức (ánh sáng chiếu tới đâu, bề mặt phản xạ thế nào), chỉ khác vị trí. Và điểm ảnh này không cần chờ điểm ảnh kia.
Đây là bài toán “chấm trắc nghiệm” hoàn hảo: rất nhiều việc giống hệt nhau, độc lập với nhau. Từ cuối thập niên 1990, các hãng làm card đồ họa đã xây chip chuyên cho đúng kiểu việc ấy, và Nvidia bắt đầu dùng cái tên “GPU” từ năm 1999.
Vì sao AI cần GPU?
Một mạng nơ-ron, bỏ qua mọi thuật ngữ, gần như chỉ làm một việc lặp đi lặp lại: nhân ma trận. Nghe đáng sợ, nhưng bạn đã làm nó khi cộng hóa đơn đi chợ: mỗi dòng là số lượng nhân đơn giá, rồi cộng tất cả lại. Nhân ma trận là làm việc đó cho hàng triệu hóa đơn cùng lúc, và hóa đơn này không cần chờ hóa đơn kia. Lại là chấm trắc nghiệm.
Lịch sử diễn ra khá nhanh:
- 2007: Nvidia phát hành CUDA, cho phép lập trình viên dùng GPU tính những thứ không phải đồ họa.
- 2009: nhóm của Andrew Ng ở Stanford cho thấy huấn luyện mạng nơ-ron trên GPU nhanh hơn CPU tới khoảng 70 lần[5].
- 2012: mạng AlexNet, huấn luyện trên hai card chơi game GTX 580, thắng cuộc thi nhận dạng ảnh ImageNet với cách biệt lớn[6]. Từ đây, học sâu (deep learning) bùng nổ, và GPU trở thành công cụ mặc định.
- 2017: Nvidia đưa vào GPU V100 các Tensor Core, những mạch chuyên nhân ma trận nhỏ trong một nhịp, nhanh hơn nhiều so với lõi CUDA thông thường[8]. Giống như thay vì bấm máy tính từng phép nhân, bạn có một cái máy đóng dấu in nguyên một bảng cửu chương chỉ trong một lần ấn. Từ đó GPU cho trung tâm dữ liệu ngày càng giống “chip chuyên AI” hơn là “chip đồ họa”.
Băng thông bộ nhớ: nút thắt thật của chatbot
Có một chi tiết ít người để ý: khi một mô hình ngôn ngữ (như các chatbot) sinh ra từng chữ, phần chậm nhất thường không phải là tính toán, mà là đọc trọng số từ bộ nhớ. Mỗi chữ (token) sinh ra, máy phải đọc toàn bộ trọng số của mô hình một lần. Hãy tưởng tượng một người mà muốn viết ra mỗi chữ tiếp theo đều phải lật lại từ đầu tới cuối một cuốn sách dày: viết nhanh hay chậm không phụ thuộc vào tay viết, mà vào tốc độ lật trang.
Lấy một mô hình 7 tỷ tham số, nén xuống 4 bit mỗi tham số: khoảng 3,5 GB. Chia băng thông cho kích thước, ta có trần tốc độ lý thuyết:
- CPU với RAM DDR5 hai kênh (khoảng 90 GB/s): tối đa khoảng 26 chữ mỗi giây.
- RTX 4090 (khoảng 1.000 GB/s): tối đa khoảng 288 chữ mỗi giây.
Đây là trần trên giấy, thực tế thấp hơn, nhưng tỷ lệ hơn 10 lần ấy là lý do bạn nghe dân chạy AI trên máy cá nhân luôn hỏi “card bao nhiêu GB VRAM?”. Mô hình phải vừa trong bộ nhớ của GPU thì mới hưởng được băng thông đó: cuốn sách phải nằm trọn trên bàn, nếu không thì mỗi trang thiếu lại phải chạy xuống kho lấy. Đó cũng là lý do các GPU cho trung tâm dữ liệu dùng bộ nhớ HBM xếp chồng sát chip, như xây kho hàng sát vách xưởng: đắt nhưng nhanh hơn nữa.
Khi nào CPU vẫn thắng?
GPU không làm mọi thứ nhanh hơn. Có ít nhất ba trường hợp CPU thắng rõ:
1. Việc có nhiều phần tuần tự. Năm 1967, kỹ sư Gene Amdahl của IBM chỉ ra một giới hạn đơn giản mà nghiệt ngã[7]: nếu một phần của công việc bắt buộc phải làm tuần tự, thì dù có bao nhiêu lõi đi nữa, tốc độ cũng không thể vượt quá một trần. Nếu 10% công việc là tuần tự, bạn không bao giờ nhanh hơn được 10 lần, dù có 16 lõi hay 16.000 lõi. Giống nấu cỗ đám cưới: thuê thêm 100 người phụ thì rau thái xong trong nháy mắt, nhưng nồi xôi vẫn phải đồ đủ một tiếng, và cả bữa cỗ không thể xong sớm hơn nồi xôi. Hình 1 bên dưới cho thấy điều này.
2. Việc nhiều rẽ nhánh. Nhớ lại “bàn 32 học sinh phải làm cùng một động tác”. Nếu nửa bàn cần đi nhánh “nếu”, nửa còn lại đi nhánh “thì”, GPU phải chạy lần lượt cả hai nhánh, nửa bàn ngồi chơi trong mỗi lượt. Code càng rẽ nhánh lắt léo, GPU càng phí.
3. Việc nhỏ. Dữ liệu phải được chép từ RAM sang bộ nhớ GPU qua khe PCIe (khoảng 32 GB/s với PCIe 4.0 x16), chậm hơn hẳn bộ nhớ hai bên. Với việc nhỏ, thời gian chép đi chép về lâu hơn cả thời gian tính. Giống như thuê 16.000 học sinh để chấm 20 bài: riêng việc phát bài đã mất cả buổi.
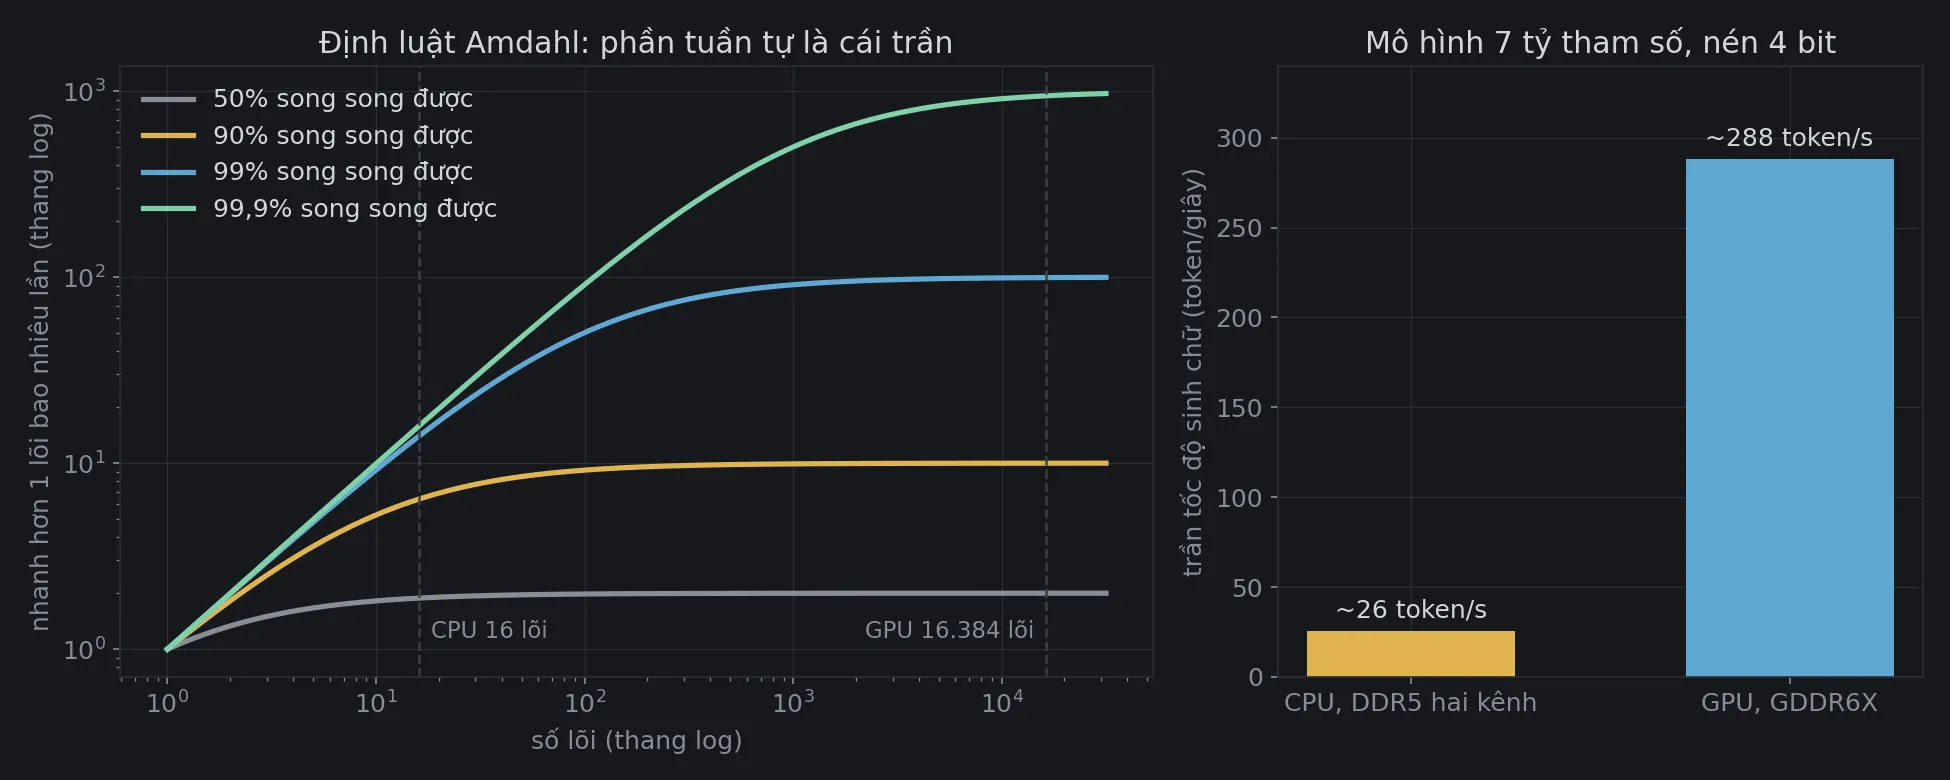
Đọc biểu đồ bên trái theo cột dọc ở vạch “GPU 16.384 lõi”:
| Phần song song được | 16 lõi nhanh hơn 1 lõi | 16.384 lõi nhanh hơn 1 lõi |
|---|---|---|
| 50% | 1,9 lần | 2,0 lần |
| 90% | 6,4 lần | 10,0 lần |
| 99% | 13,9 lần | 99,4 lần |
| 99,9% | 15,8 lần | 942 lần |
Với việc chỉ song song được một nửa, 16.000 lõi gần như vô dụng so với 16 lõi. Chỉ khi công việc song song được trên 99%, như nhân ma trận hay tô điểm ảnh, thì hàng nghìn lõi mới thật sự phát huy. Đó là ranh giới giữa đất của CPU và đất của GPU.
Vậy máy tính của bạn cần gì?
Gần như mọi máy tính đều có cả hai, vì chúng làm việc cùng nhau: CPU điều phối, chạy hệ điều hành và phần logic của chương trình, rồi giao những khối việc lớn, đều đặn cho GPU.
- Văn phòng, học tập, lướt web: CPU quan trọng hơn. GPU tích hợp sẵn trong chip là đủ.
- Chơi game, dựng video, đồ họa 3D: GPU rời đáng tiền, vì đó là đúng việc nó sinh ra để làm.
- Chạy AI trên máy cá nhân: nhìn vào dung lượng bộ nhớ GPU (VRAM) trước tiên, rồi mới tới tốc độ.
- Laptop và điện thoại đời mới: ranh giới đang mờ đi. Chip Apple dòng M hay chip điện thoại đặt CPU, GPU và một bộ phận chuyên AI (NPU) trên cùng một con chip, dùng chung bộ nhớ, nên không còn tốn công chép dữ liệu qua lại: thay vì hai nhà bếp phải bưng đồ ăn sang nhau, mọi người ăn chung một mâm. NPU thì giống người thợ chỉ biết đúng một việc (nhân ma trận cỡ nhỏ) nhưng làm việc đó rất nhanh và rất ít tốn điện, hợp với điện thoại chạy pin.
Còn ở quy mô trung tâm dữ liệu, cuộc đua đang đi tiếp sang những con chip chuyên AI còn chuyên hơn GPU, và cả những hướng hoàn toàn khác như tính toán bằng ánh sáng.
Tự tay tính: định luật Amdahl và trần tốc độ sinh chữ
Đoạn code dưới đây tạo ra đúng Hình 1 và in ra bảng ở mục trên. Phần đầu tính mức tăng tốc theo định luật Amdahl:
trong đó là tỷ lệ công việc song song được và là số lõi. Khi tiến ra vô cùng, tiến tới : đó là cái trần. Phần sau chia băng thông bộ nhớ cho kích thước mô hình để ra trần tốc độ sinh chữ. Không có yếu tố ngẫu nhiên; chỉ cần numpy và matplotlib.
import matplotlib.pyplot as pltimport numpy as np
plt.rcParams.update({"figure.facecolor": "#16181c", "axes.facecolor": "#16181c", "text.color": "#d4d7dc",                     "axes.edgecolor": "#2a2e35", "axes.labelcolor": "#878d97",                     "xtick.color": "#878d97", "ytick.color": "#878d97", "font.size": 12})MAU = {0.5: "#878d97", 0.9: "#e0b44c", 0.99: "#5fa8d3", 0.999: "#7fd1a8"}
def amdahl(p, n):    """Định luật Amdahl: phần p chạy song song được chia cho n lõi, phần 1 − p vẫn phải chạy tuần tự."""    return 1 / ((1 - p) + p / n)
# 1. Tăng tốc theo số lõi, với bốn mức "song song được" khác nhau.so_loi = np.logspace(0, 4.5, 400)CPU, GPU = 16, 16_384        # 16 lõi như Ryzen 9 9950X; 16.384 lõi CUDA như RTX 4090for p in MAU:    print(f"p = {p:5}: 16 lõi nhanh {amdahl(p, CPU):6.1f} lần, 16.384 lõi nhanh {amdahl(p, GPU):6.1f} lần,"          f" trần {1 / (1 - p):6.0f} lần")
# 2. Ước tính trần tốc độ sinh chữ của một mô hình ngôn ngữ 7 tỷ tham số, nén 4 bit (~3,5 GB):#    mỗi chữ (token) phải đọc toàn bộ trọng số từ bộ nhớ một lần.mo_hinh_gb = 7e9 * 0.5 / 1e9bang_thong = {"CPU, DDR5 hai kênh": 89.6, "GPU, GDDR6X": 1008}   # GB/sfor ten, bw in bang_thong.items():    print(f"{ten}: tối đa ~{bw / mo_hinh_gb:.0f} token/giây")
fig, (a1, a2) = plt.subplots(1, 2, figsize=(13, 5.2), gridspec_kw={"width_ratios": [1.6, 1]})for p, mau in MAU.items():    a1.loglog(so_loi, amdahl(p, so_loi), color=mau, lw=2.5, label=f"{p * 100:g}% song song được".replace(".", ","))for n, ten, canh in [(CPU, "CPU 16 lõi", "left"), (GPU, "GPU 16.384 lõi", "right")]:    a1.axvline(n, color="#3a3f48", ls="--", lw=1.2)    a1.text(n * (1.15 if canh == "left" else 0.87), 1.15, ten, color="#878d97", fontsize=11, ha=canh)a1.set(xlabel="số lõi (thang log)", ylabel="nhanh hơn 1 lõi bao nhiêu lần (thang log)",       title="Định luật Amdahl: phần tuần tự là cái trần")a1.legend(frameon=False, loc="upper left")
ten, bw = zip(*bang_thong.items())cot = a2.bar(ten, [b / mo_hinh_gb for b in bw], color=["#e0b44c", "#5fa8d3"], width=0.55)a2.bar_label(cot, labels=[f"~{b / mo_hinh_gb:.0f} token/s" for b in bw], color="#d4d7dc", padding=4)a2.set(ylabel="trần tốc độ sinh chữ (token/giây)", title="Mô hình 7 tỷ tham số, nén 4 bit", ylim=(0, 340))for a in (a1, a2):    a.set_axisbelow(True)    a.grid(color="#2a2e35", lw=0.6)fig.tight_layout()fig.savefig("cpu-va-gpu-khac-nhau.png", dpi=150)
Kết quả in ra:
p = 0.5: 16 lõi nhanh 1.9 lần, 16.384 lõi nhanh 2.0 lần, trần 2 lầnp = 0.9: 16 lõi nhanh 6.4 lần, 16.384 lõi nhanh 10.0 lần, trần 10 lầnp = 0.99: 16 lõi nhanh 13.9 lần, 16.384 lõi nhanh 99.4 lần, trần 100 lầnp = 0.999: 16 lõi nhanh 15.8 lần, 16.384 lõi nhanh 942.5 lần, trần 1000 lầnCPU, DDR5 hai kênh: tối đa ~26 token/giâyGPU, GDDR6X: tối đa ~288 token/giâyMô hình này cố ý đơn giản: nó coi mọi lõi mạnh như nhau, trong khi thực tế một lõi CPU mạnh hơn một lõi CUDA rất nhiều. Bạn có thể thử sửa: cho lõi GPU chỉ bằng lõi CPU (chia của GPU cho 20) và xem ranh giới “từ bao nhiêu phần trăm song song thì GPU mới đáng” dịch đi đâu.
Giáo sư và học sinh
CPU và GPU không phải hai phiên bản mạnh yếu của cùng một thứ. Chúng là hai câu trả lời cho hai câu hỏi khác nhau. CPU trả lời: “làm sao để một việc khó xong sớm nhất?”. GPU trả lời: “làm sao để thật nhiều việc dễ xong trong một giây?”.
Thế giới AI hôm nay chạy trên GPU không phải vì GPU “thông minh” hơn, mà vì hóa ra phần nặng nhất của trí tuệ nhân tạo lại là việc dễ nhất: nhân và cộng, hàng nghìn tỷ lần, lần nào cũng như lần nào. Còn phần khó, điều phối mọi thứ, vẫn là việc của vị giáo sư ngồi cạnh.
Vẽ minh họa hình học miễn phí cho học sinh và giáo viên: EyeViz.
Tài liệu tham khảo
- [1]NVIDIA Ada GPU Architecture (whitepaper). NVIDIA, 2022.
- [2]AMD Ryzen 9 9950X Desktop Processor. AMD, 2024.
- [3]CUDA C++ Programming Guide. NVIDIA.
- [4]John L. Hennessy và David A. Patterson. Computer Architecture: A Quantitative Approach (6th ed.). Morgan Kaufmann, 2017.
- [5]Rajat Raina, Anand Madhavan và Andrew Y. Ng. Large-scale deep unsupervised learning using graphics processors. ICML, 2009.
- [6]Alex Krizhevsky, Ilya Sutskever và Geoffrey E. Hinton. ImageNet Classification with Deep Convolutional Neural Networks. NeurIPS, 2012.
- [7]Gene M. Amdahl. Validity of the single processor approach to achieving large scale computing capabilities. AFIPS Spring Joint Computer Conference, 1967.
- [8]NVIDIA Tesla V100 GPU Architecture (whitepaper). NVIDIA, 2017.