Jev là gì? Mô hình AI không biết chat mà chỉ ra quyết định
Jev của TypeSafe AI là gì, vì sao không biết chat lại giúp nó nhanh và rẻ hơn LLM hàng chục lần, so với các mô hình lớn ra sao, và cách dùng Jev hiệu quả.
Mục lục
Jev là mô hình AI do công ty TypeSafe AI (San Francisco) ra mắt ngày 15/9/2026. Khác với ChatGPT hay Claude, Jev không viết ra chữ. Bạn đưa cho nó một tình huống và vài câu hỏi có sẵn đáp án để chọn, nó trả về lựa chọn kèm xác suất, ví dụ “tin tốt: 82%, trung tính: 15%, tin xấu: 3%”. Nhờ bỏ hẳn phần viết chữ, Jev trả lời trong chưa tới nửa giây, với giá rẻ hơn các mô hình ngôn ngữ lớn (LLM) hàng đầu hàng chục đến hàng trăm lần[1].
Bài này giải thích vì sao “không biết chat” lại là lợi thế, Jev so với các mô hình lớn ra sao, và quan trọng nhất: dùng Jev thế nào cho hiệu quả, kể cả khi bạn là nhà đầu tư muốn dùng nó để lọc tin tức.
Một AI không biết nói chuyện
Hãy tưởng tượng bạn theo dõi 50 mã cổ phiếu, và mỗi ngày có vài trăm tin tức về chúng. Với mỗi tin, bạn chỉ cần biết ba điều:
- Tin này tốt, trung tính hay xấu với doanh nghiệp?
- Mức độ ảnh hưởng lớn tới đâu?
- Có cần báo cho mình ngay không?
Dùng ChatGPT cho việc này cũng được, nhưng hơi phí. Nó sẽ viết một đoạn văn giải thích lịch sự, mỗi lần mất vài giây, tính tiền theo từng chữ viết ra, và thỉnh thoảng trả lời sai định dạng làm chương trình của bạn bị lỗi. Bạn không cần đoạn văn. Bạn cần ba câu trả lời ngắn.
Jev được làm ra cho đúng loại việc này. Bạn đưa vào trạng thái (state), ở đây là nội dung bản tin, và các câu hỏi có kiểu (typed question). Jev có ba loại câu hỏi[2]:
| Loại câu hỏi | Dùng khi | Jev trả về |
|---|---|---|
| Choice | Chọn một trong các phương án | Phương án được chọn, xác suất từng phương án |
| Score | Đặt tình huống lên một thang có thứ tự | Điểm số trên thang, xác suất từng mức |
| Noul | Câu hỏi có/không | Xác suất câu trả lời là “có”, từ 0 đến 1 |
Với bản tin “Công ty X báo lãi quý III tăng mạnh, vượt kế hoạch năm”, Jev sẽ trả về: Choice là “tốt” với xác suất cao, Score ở mức cao trên thang ảnh hưởng, Noul “cần báo ngay” gần bằng 1. Không có chữ nào thừa. Chương trình của bạn đọc thẳng các câu trả lời đó và quyết định làm gì tiếp.
Vì sao Jev nhanh và rẻ hơn các mô hình lớn?
LLM tốn tiền ở phần “viết”, không phải phần “đọc”
Mỗi lần bạn gọi một LLM như GPT, Claude hay Gemini, nó làm hai việc:
- Đọc câu hỏi của bạn. Việc này chạy song song: cả câu hỏi được xử lý cùng lúc, nên nhanh và rẻ.
- Viết câu trả lời. Việc này chạy nối tiếp: mô hình viết từng token một (token là một mẩu chữ, xấp xỉ một phần của từ), và muốn viết token tiếp theo thì phải viết xong token trước. Mỗi token là một lần chạy cả mô hình.
Vì vậy phần lớn thời gian chờ và tiền bạc nằm ở phần viết. Đó cũng là lý do các hãng tính giá chữ đầu ra cao hơn chữ đầu vào nhiều lần. Các mô hình suy luận (reasoning model) còn “nghĩ” thêm hàng nghìn token ẩn trước khi trả lời, nên một câu hỏi đơn giản có thể mất hàng chục giây.
Jev chỉ đọc, rồi chấm điểm
Jev bỏ hẳn phần viết. TypeSafe chưa công bố kiến trúc chi tiết, nhưng các phân tích độc lập cho rằng Jev đọc tình huống một lần, rồi chấm điểm mọi phương án cùng lúc, sau đó chuyển điểm thành xác suất[4]. Giám đốc điều hành của TypeSafe từng nói chuỗi ký tự “hoàn toàn không được phép” làm đầu ra, để mọi câu trả lời có thể tính song song.
Một hình ảnh dễ nhớ: hỏi LLM giống như nhờ một nhà phân tích viết hẳn một bản báo cáo chỉ để kết luận “tin tốt”. Hỏi Jev giống như nhờ người đó đọc xong rồi giơ thẻ lên.
Từ một thay đổi đó, Jev có bốn lợi thế:
- Nhanh và ổn định: thời gian trả lời gần như chỉ bằng thời gian đọc, không phụ thuộc câu trả lời dài hay ngắn.
- Rẻ: Jev chỉ tính tiền phần đầu vào, đầu ra miễn phí[2]. Phân loại cả triệu bản tin chỉ tốn vài chục USD.
- Nhiều câu hỏi, một lần đọc: mọi câu hỏi dùng chung một lần đọc tình huống, thay vì mỗi câu là một đoạn văn phải viết riêng.
- Không bao giờ sai định dạng: đáp án luôn nằm trong danh sách bạn đưa. Không phải kiểm tra JSON, không phải gọi lại vì mô hình trả lời lệch, một chi phí ẩn mà ai dùng LLM trong phần mềm cũng biết.
Thêm một lợi thế ít người để ý: xác suất có sẵn. Muốn biết một LLM “chắc chắn bao nhiêu”, bạn phải hỏi nó nhiều lần rồi đếm, hoặc để nó tự nói “tôi chắc 80%”, một con số thường không đáng tin. Jev đọc xác suất thẳng từ bên trong mô hình trong cùng một lần chạy.
So với các mô hình lớn khác
| LLM hàng đầu (GPT, Claude, Gemini) | Jev | LLM nhỏ mã nguồn mở | |
|---|---|---|---|
| Tốc độ | Vài giây đến vài chục giây | Dưới nửa giây | Nhanh, tùy máy chạy |
| Chi phí mỗi quyết định | Cao | Rất thấp | Thấp |
| Độ chính xác bài khó | Cao nhất | Ngang mô hình tầm trung | Ngang hoặc hơn Jev một chút |
| Giải thích lý do | Có | Không | Có |
| Việc mở, viết, tính toán | Làm được | Không làm được | Làm được ở mức vừa phải |
Bảng cho thấy hai điều. Thứ nhất, lợi thế của Jev lớn nhất khi so với mô hình hàng đầu: trong một phép so sánh do DataCamp tổng hợp, Jev đạt độ chính xác ngang một mô hình lớn của OpenAI nhưng rẻ hơn khoảng 76 lần và nhanh hơn khoảng 25 lần[3]. Thứ hai, lợi thế đó co lại nhiều khi so với mô hình nhỏ mã nguồn mở. Kỹ thuật “đọc rồi chấm điểm” không phải độc quyền, ai tự chạy mô hình mã nguồn mở cũng làm được, và các bài test độc lập cho thấy vài mô hình mở cùng tầm giá còn chính xác hơn Jev một chút[6]. Thứ Jev thực sự bán là sự tiện lợi: API gọn, ba kiểu câu hỏi sẵn có, xác suất khá tốt ngay từ đầu.
Cái giá của việc không chat
Bỏ phần viết thì cũng mất những gì phần viết mang lại:
- Không có chuỗi suy luận. LLM giỏi bài khó vì được “nghĩ ra giấy” từng bước. Jev phải trả lời sau một lần đọc, giống tư duy nhanh theo trực giác. TypeSafe gọi Jev là “System One model”, mượn từ cuốn Tư duy nhanh và chậm của Daniel Kahneman. Vì vậy Jev thua các mô hình hàng đầu ở những việc khó, và yếu hẳn ở tính toán, ngày tháng, đọc chính xác từng chữ.
- Không giải thích được vì sao chọn như vậy, nên khó kiểm tra lại.
- Phương án phải biết trước. Jev không trả lời được câu hỏi mở.
- Các câu hỏi không phụ thuộc nhau được. Câu sau cần kết quả câu trước thì phải gọi hai lần.
Cái tên “Jev” lấy từ nhà kinh tế học William Stanley Jevons[1], người nhận thấy máy hơi nước tiết kiệm than không làm nước Anh đốt ít than đi, mà ngược lại, vì máy rẻ hơn nên được dùng ở khắp nơi. TypeSafe đặt cược điều tương tự: khi mỗi quyết định của AI rẻ đi hàng trăm lần, người ta sẽ dùng AI cho mọi quyết định nhỏ trước đây không đáng tiền. Bài AI và cơn khát điện có nhắc tới nghịch lý này ở góc độ điện năng.
Jev giỏi đến đâu?
TypeSafe nói Jev nhanh hơn và rẻ hơn các LLM hàng đầu hàng chục đến hàng trăm lần, không bao giờ sai định dạng, và có xác suất “đã hiệu chỉnh”[3]. Nhưng hãng chưa công bố bài báo kỹ thuật hay bộ benchmark công khai, và thừa nhận các bài test do đội nội bộ tự thiết kế[1].
Các bài kiểm tra độc lập trong ba tuần đầu cho bức tranh cân bằng hơn[6]:
- Độ chính xác ngang các LLM tầm trung, thua các mô hình hàng đầu ở việc khó.
- Rất mạnh ở việc đơn giản, khối lượng lớn, như lọc thư rác hay phân loại yêu cầu.
- Nhạy với cách đặt câu hỏi: chỉ đổi thứ tự các phương án, khá nhiều câu trả lời đã thay đổi.
- Yếu hơn ở ngôn ngữ khác tiếng Anh. Tiếng Việt chưa có bài test công khai.
- Có thể tự tin sai khi đáp án không nằm trong dữ liệu bạn đưa vào.
Về xác suất, một bài kiểm tra trên GitHub cho thấy Jev xếp hạng rất tốt (bình luận nó cho điểm cao thực sự độc hại hơn), nhưng con số phần trăm thì lệch xa: ở những chỗ Jev nói khoảng 75%, con người chỉ đánh dấu khoảng 10%[7]. Tin vui là một phép hiệu chỉnh lại đơn giản, học từ một ít dữ liệu đã có nhãn, sửa được gần hết sai lệch đó.
Tóm lại: Jev biết cái gì “nhiều hơn” cái gì, nhưng con số phần trăm của nó chưa chắc là phần trăm thật.
Cách dùng Jev hiệu quả
Phần này là hướng dẫn thực tế, áp dụng cho bất kỳ ai định đưa Jev vào công việc, từ lọc tin tức đầu tư đến phân loại email.
1. Chọn đúng việc cho Jev
Trước khi dùng, hãy kiểm tra công việc của bạn có đủ ba điều kiện không:
- Đáp án biết trước: bạn liệt kê được mọi phương án (tốt/xấu, có/không, mức 1 đến 5).
- Khối lượng lớn: hàng trăm, hàng nghìn lần mỗi ngày. Chỉ vài lần một ngày thì cứ dùng LLM lớn cho chính xác.
- Cần nhanh hoặc cần rẻ: chạy ngầm trong phần mềm, không có người ngồi chờ đọc câu trả lời.
Đừng giao cho Jev: tính toán chỉ số tài chính, tóm tắt, viết báo cáo, câu hỏi mở, hay dự báo những điều không có trong dữ liệu (như giá cổ phiếu ngày mai).
2. Tách câu hỏi lớn thành nhiều câu hỏi nhỏ
Jev trả lời tốt nhất khi mỗi câu hỏi chỉ hỏi một ý. Thay vì hỏi “Tin này có tốt và quan trọng không?”, hãy tách thành hai câu: một Choice “tốt/trung tính/xấu” và một Score về mức độ quan trọng. Các câu hỏi được trả lời cùng lúc trong một lần gọi, nên tách nhỏ không làm chậm hay tốn thêm bao nhiêu.
Chọn đúng loại câu hỏi:
- Noul cho câu có/không: “Tin này có nhắc tới kết quả kinh doanh không?”
- Choice cho danh mục không có thứ tự: “Tin thuộc nhóm nào: kết quả kinh doanh, nhân sự, pháp lý, cổ tức, khác?”
- Score cho mức độ có thứ tự: “Mức độ ảnh hưởng tới giá: không đáng kể, nhỏ, vừa, lớn.”
3. Viết phương án rõ ràng, không chồng lấn
Vì Jev chỉ chọn trong những gì bạn đưa, chất lượng câu trả lời phụ thuộc rất nhiều vào cách bạn mô tả phương án:
- Mô tả từng phương án bằng một câu cụ thể, đừng chỉ ghi một chữ. “Xấu: tin làm giảm lợi nhuận, tăng rủi ro pháp lý hoặc làm mất niềm tin vào ban lãnh đạo” tốt hơn nhiều so với “xấu”.
- Các phương án không chồng lên nhau. Nếu một tin có thể vừa thuộc “pháp lý” vừa thuộc “nhân sự”, hãy dùng hai câu Noul riêng thay vì một Choice.
- Luôn có phương án “khác”. Nếu không, Jev buộc phải chọn một phương án sai một cách tự tin.
- Với Score, mô tả từng mức, không chỉ ghi “1 đến 5”. Mức nào nghĩa là gì phải rõ đến mức hai người đọc cùng tin sẽ chọn giống nhau.
4. Đưa vào đúng thông tin, không thừa
Jev yếu khi phải đọc văn bản dài có nhiều thông tin không liên quan. Hãy:
- Chỉ đưa phần cần thiết: tiêu đề và vài đoạn đầu của bản tin, thay vì cả trang web.
- Chia thông tin thành các trường rõ ràng (mã cổ phiếu, tiêu đề, nội dung, ngày đăng), và nhắc đúng tên trường trong câu hỏi.
- Nếu câu trả lời cần một con số đã tính sẵn (như tăng trưởng lợi nhuận), hãy tự tính trước bằng code rồi đưa vào, đừng bắt Jev tính.
5. Thử độ “vững” của câu hỏi
Vì Jev nhạy với cách đặt câu hỏi, trước khi dùng thật hãy làm hai phép thử nhanh:
- Đổi thứ tự các phương án rồi chạy lại trên cùng dữ liệu.
- Viết lại câu hỏi theo cách khác nhưng cùng ý.
Nếu câu trả lời đổi nhiều, câu hỏi của bạn chưa đủ rõ. Quay lại bước 3.
6. Tự đo trên dữ liệu của chính mình
Đây là bước quan trọng nhất, nhất là với tiếng Việt, khi chưa có bài test công khai nào. Lấy vài trăm mẫu thật (ví dụ 300 bản tin), tự gắn nhãn đáp án đúng, rồi so với câu trả lời của Jev. Bạn sẽ biết ba điều: Jev đúng bao nhiêu, sai ở loại tin nào, và con số xác suất của nó có khớp thực tế không.
Làm lại phép đo này mỗi khi đổi câu hỏi hoặc đổi phiên bản mô hình. Khi dùng thật, hãy ghim cố định phiên bản (TypeSafe cho phép chọn đúng phiên bản thay vì luôn dùng bản mới nhất), để kết quả không tự dưng thay đổi.
7. Tin thứ hạng, cẩn thận với con số phần trăm
Từ dữ liệu ở bước 6, bạn có thể:
- Dùng xác suất để xếp hạng, ví dụ sắp xếp tin tức từ đáng đọc nhất đến ít đáng đọc nhất. Đây là việc Jev làm tốt.
- Chọn ngưỡng dựa trên dữ liệu, không dựa trên con số tròn. Đừng mặc định “trên 90% là chắc chắn”. Hãy xem ở ngưỡng nào thì Jev thực sự đúng đủ nhiều cho nhu cầu của bạn.
- Hiệu chỉnh lại xác suất nếu bạn cần dùng con số đó để tính toán tiếp (xem mục cuối).
8. Ghép Jev với LLM lớn và con người
Cách dùng hiệu quả nhất thường không phải “Jev thay LLM”, mà là mỗi bên làm phần mình giỏi:
- Jev lọc: chạy trên toàn bộ dữ liệu, loại bỏ phần lớn những gì không quan trọng, chỉ tốn vài xu.
- LLM lớn nghĩ: những trường hợp Jev không chắc (xác suất lưng chừng) hoặc rất quan trọng được chuyển sang một LLM lớn để phân tích kỹ, kèm giải thích.
- Con người quyết: chỉ đọc số ít trường hợp cuối cùng.
Các dự án dùng Jev cho tài chính trên GitHub cũng đi theo đúng tinh thần này: Jev phán đoán, code thực thi. Jev trả lời những câu hỏi hẹp, còn quyết định có đặt lệnh hay không do một bộ quy tắc cố định với giới hạn rủi ro rõ ràng nắm giữ[10].
Jev dưới góc nhìn nhà đầu tư
Một câu chuyện định giá đầy kỳ vọng
TypeSafe ra mắt Jev cùng vòng gọi vốn được định giá khoảng 200 triệu USD. Chỉ mười ngày sau, có tin công ty nhận được những lời mời đầu tư có thể đẩy định giá lên 10 tỷ USD[9], và Bloomberg gọi Jev là “mô hình AI không biết chat đang thách thức các đối thủ lớn hơn”[8].
Câu hỏi một nhà đầu tư cẩn thận nên đặt ra là hào kinh tế nằm ở đâu. Như đã nói ở trên, kỹ thuật cốt lõi không phải độc quyền. Chưa đầy mười ngày sau Jev, cộng đồng đã có những mô hình tương tự như Laya, công khai trọng số trên Hugging Face[11]. Các phòng thí nghiệm lớn cũng hoàn toàn có thể ra một chế độ “chỉ trả xác suất” giá rẻ. Ở thời điểm này, giá trị của Jev chủ yếu nằm ở kỳ vọng.
Đừng dùng thẳng con số phần trăm để quyết định bỏ bao nhiêu tiền
Trong đầu tư, xác suất không chỉ dùng để chọn mua hay không, mà còn để chọn mua bao nhiêu. Nhiều cách chia vốn, như tiêu chuẩn Kelly, cho rằng xác suất thắng càng cao thì lệnh càng lớn. Nếu mô hình tự tin quá mức, bạn sẽ đặt lệnh quá lớn so với lợi thế thật.
Hình dưới mô phỏng điều đó với một mô hình giả lập: xếp hạng lệnh đúng hoàn toàn, nhưng con số xác suất thì phóng đại, giống điều bài kiểm tra độc lập đã thấy ở Jev.
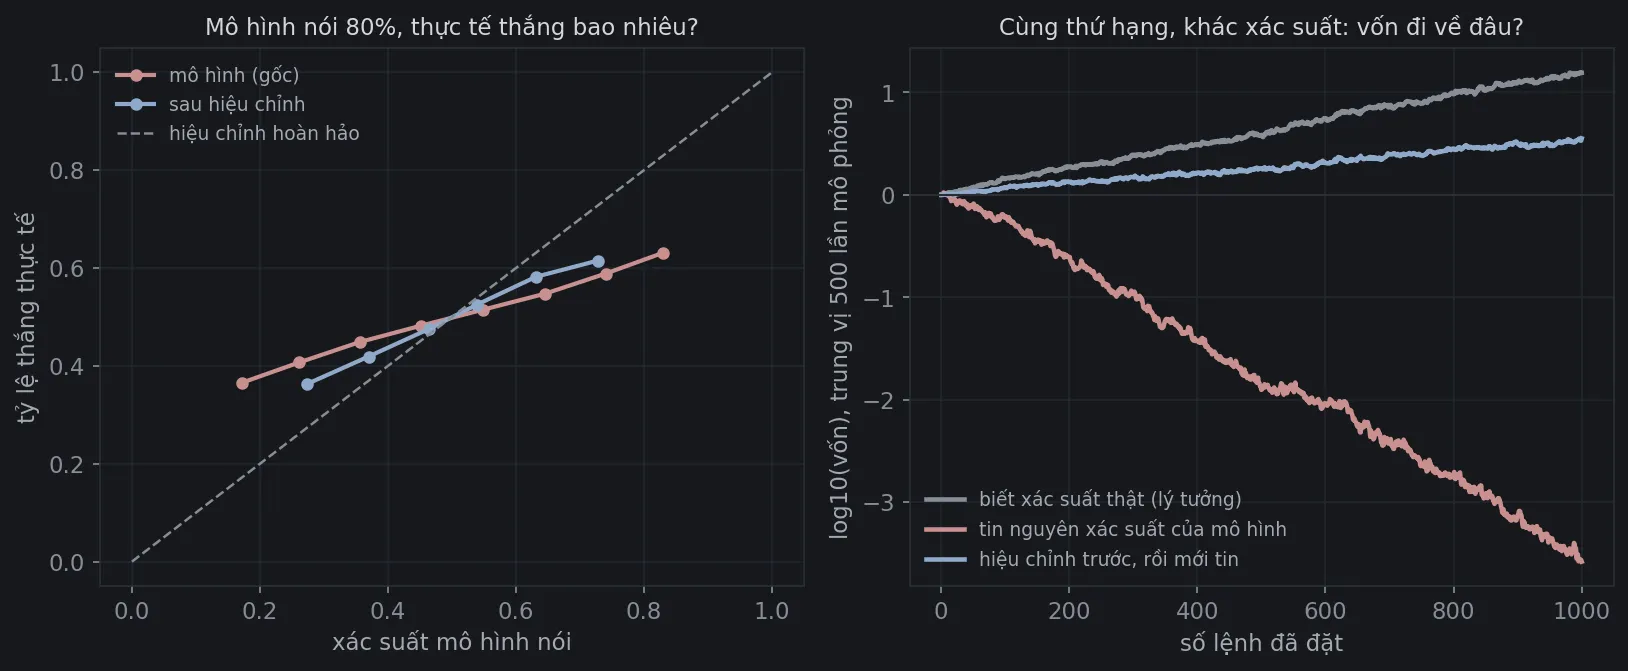
Cùng một mô hình, cùng khả năng chọn lệnh. Người tin nguyên con số mất gần hết vốn, vì lợi thế thật thì nhỏ mà lệnh lại quá lớn. Người hiệu chỉnh trước (dùng một phần dữ liệu để học xem “mô hình nói 70% thì thực tế là bao nhiêu”) vẫn có lãi, dù kém mức lý tưởng, vì phép hiệu chỉnh từ ít dữ liệu vẫn còn sai số. Đây cũng là một dạng của hồi quy về trung bình: ước lượng cực đoan từ ít dữ liệu thường cực đoan hơn sự thật.
Ba quy tắc rút ra:
- Dùng thứ hạng trước, con số sau.
- Tự hiệu chỉnh trên dữ liệu của chính mình, và kiểm tra lại định kỳ.
- Chia nhỏ lệnh hơn mức công thức gợi ý. Nhiều nhà đầu tư chuyên nghiệp chỉ dùng một nửa mức Kelly, chính vì biết xác suất của mình không bao giờ chính xác tuyệt đối.
Kết luận
Jev nhanh và rẻ không nhờ phép màu nào. Nó bỏ hẳn phần viết, vốn là phần chậm và đắt nhất của một LLM, và chỉ giữ lại phần đọc rồi chọn. Đổi lại, nó mất khả năng suy luận dài, giải thích và trả lời câu hỏi mở.
Vì vậy Jev không thay thế các mô hình lớn, mà làm tầng lọc nhanh phía trước chúng: phân loại, chấm điểm, định tuyến hàng triệu quyết định nhỏ với giá rất rẻ. Dùng hiệu quả thì cần chọn đúng việc, đặt câu hỏi rõ, tự đo trên dữ liệu của mình, và luôn nhớ một điều: khi một mô hình nói “80%”, hãy hỏi lại 80% của ai, đo trên dữ liệu nào?
Tài liệu tham khảo
- [1]Jev (AI model). Wikipedia, 2026.
- [2]Flavio Copes. How to use Jev with Python, 2026. Cách gọi API, bảng giá và giới hạn tốc độ tính đến tháng 9/2026.
- [3]Jev: TypeSafe’s System One Model Explained. DataCamp, 2026.
- [4]Victor Dibia. How Jev works: calibrated decision models, 2026.
- [5]What is Jev?. Browserbase, 2026.
- [6]xbill. Jev After Eight Days of Independent Tests: Level With Mid-Price LLMs, Behind the Frontier. DEV Community, 2026. Tổng hợp 14 preprint arXiv, 104 repo GitHub và 33 bài viết đánh giá Jev.
- [7]Adilmp. Does Jev confidence mean anything? A calibration audit of TypeSafe’s Jev. GitHub, 2026.
- [8]Jev, an AI Model That Can’t Chat, Takes On Bigger Rivals. Bloomberg, 2026.
- [9]TypeSafe AI’s Jev Model Attracts $10 Billion Valuation Amidst AI Cost Concerns. GuruFocus, 2026.
- [10]drillan. Jev (TypeSafe System One) finance & trading projects — surveyed 2026-09-20. GitHub Gist, 2026.
- [11]Jev, Laya Go Viral: New Class of AI Models Sweeps Silicon Valley. x-cmd, 2026.