Lạm phát điểm: bao nhiêu bằng xuất sắc là hợp lý?
Lạm phát điểm là gì, bao nhiêu phần trăm bằng xuất sắc là hợp lý, và phân phối chuẩn nói gì? Từ lễ tốt nghiệp đến xếp hạng tín nhiệm, qua mô phỏng.
Mục lục
Một lễ tốt nghiệp, một nửa lên nhận bằng xuất sắc
Một sáng tháng 8, lễ tốt nghiệp của một trường đại học nọ. Người dẫn chương trình đọc tên từng sinh viên, và cứ hai bạn bước lên sân khấu thì có một bạn nhận bằng xuất sắc. Phụ huynh vỗ tay đều. Nhưng ở hàng ghế nhà tuyển dụng, có người nghiêng sang hỏi người bên cạnh: vậy trong số này, ai thật sự đứng đầu?
Câu hỏi ấy là câu hỏi của bài này: bao nhiêu phần trăm bằng xuất sắc là hợp lý, và khi tỷ lệ tăng lên thì nhãn “xuất sắc” còn phân loại được bao nhiêu. Câu trả lời ngắn: không có một con số đẹp chung cho mọi nơi. Tỷ lệ hợp lý phụ thuộc vào việc nhãn ấy dùng để làm gì. Nếu nhãn dùng để chọn ra người nổi bật, nó phải gắn cho phần nhỏ, cỡ 5 đến 10%. Nếu nhãn chỉ chứng nhận đạt chuẩn, nó có thể gắn cho nhiều người, nhưng khi ấy cần thêm một tín hiệu khác để phân biệt họ.
Bài này đi qua phân phối chuẩn để tính ngưỡng của từng nhóm đầu, chạy một mô phỏng để thấy nhãn mất độ chọn lọc ra sao khi gắn cho nhiều người, rồi so với một hiện tượng cùng bản chất trong đầu tư: lạm phát xếp hạng tín nhiệm.
Bằng xuất sắc dùng để làm gì?
Một tấm bằng thật ra làm hai việc khác nhau, và ta hay lẫn chúng.
Việc thứ nhất là chứng nhận: người này đạt một chuẩn. Giống bằng lái xe, ai qua bài thi thì có, không cần giới hạn số người. Việc thứ hai là xếp hạng: người này nằm ở đâu so với những người khác. Giống thứ hạng trong một cuộc chạy, chỉ vài người đứng đầu có huy chương.
Theo quy chế đào tạo đại học hiện hành, bằng xuất sắc ứng với điểm trung bình tích lũy từ 3,60 đến 4,00 trên thang 4, giỏi từ 3,20 đến dưới 3,60, khá từ 2,50 đến dưới 3,20[6]. Đây là một chuẩn tuyệt đối. Về nguyên tắc, nếu mọi sinh viên đều đạt chuẩn thì mọi người đều có thể nhận bằng xuất sắc. Nhưng nhà tuyển dụng đọc cùng một tấm bằng theo cách thứ hai: “người này thuộc nhóm đầu”. Hai cách đọc ấy chỉ khớp nhau khi nhãn xuất sắc gắn cho một nhóm nhỏ.
Phân phối chuẩn nói gì về nhóm đầu?
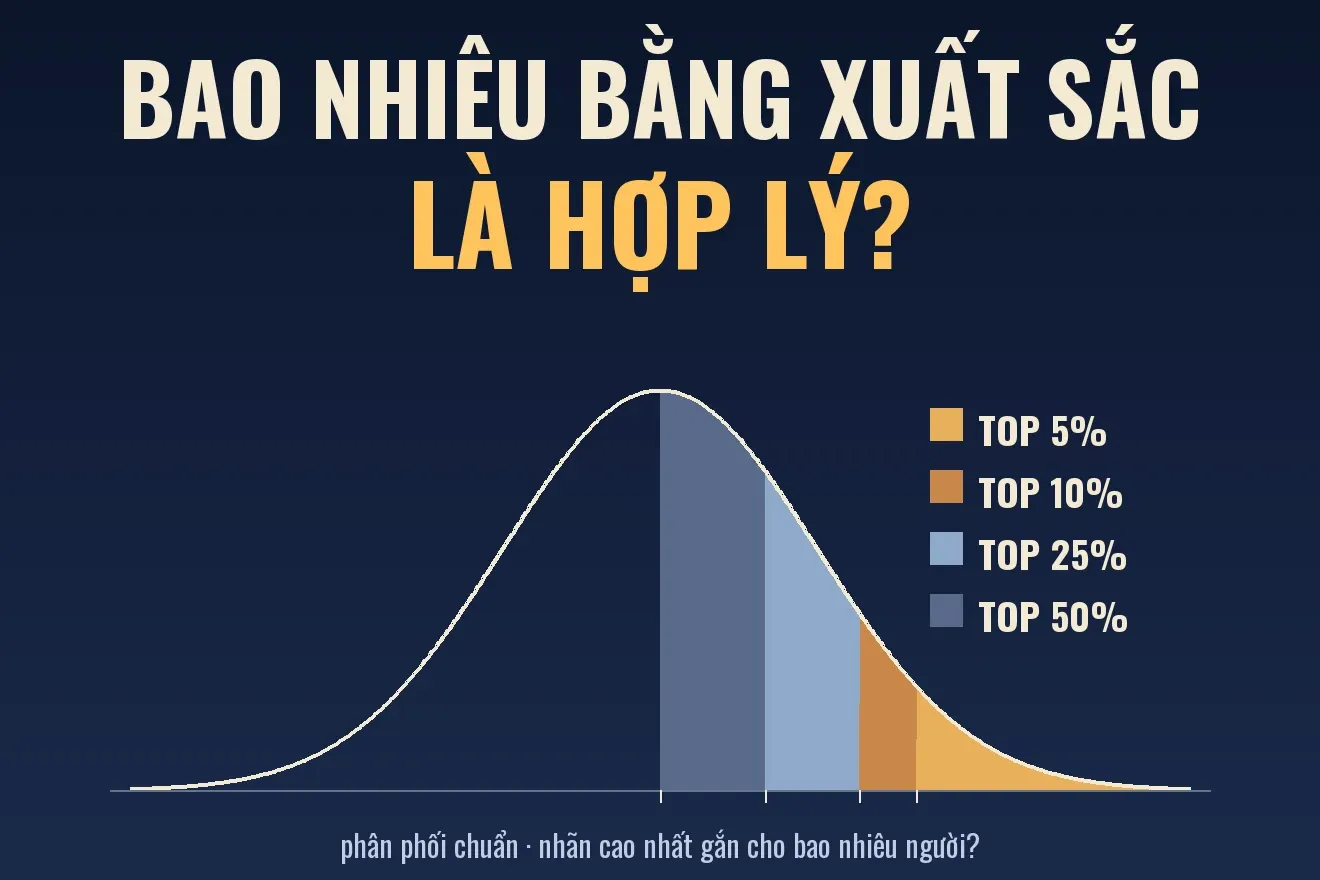
Hình dung điểm thi của một lớp lớn. Phần lớn học sinh nằm quanh mức trung bình, càng xa trung bình càng ít người, đều về hai phía. Hình dạng ấy gọi là phân phối chuẩn (đường cong hình chuông). Khoảng 68% giá trị nằm trong một độ lệch chuẩn quanh trung bình, khoảng 95% trong hai độ lệch chuẩn và khoảng 99,7% trong ba[4]. Độ lệch chuẩn đo mức dàn trải: nó giống như bề rộng của đám đông quanh vạch giữa sân.
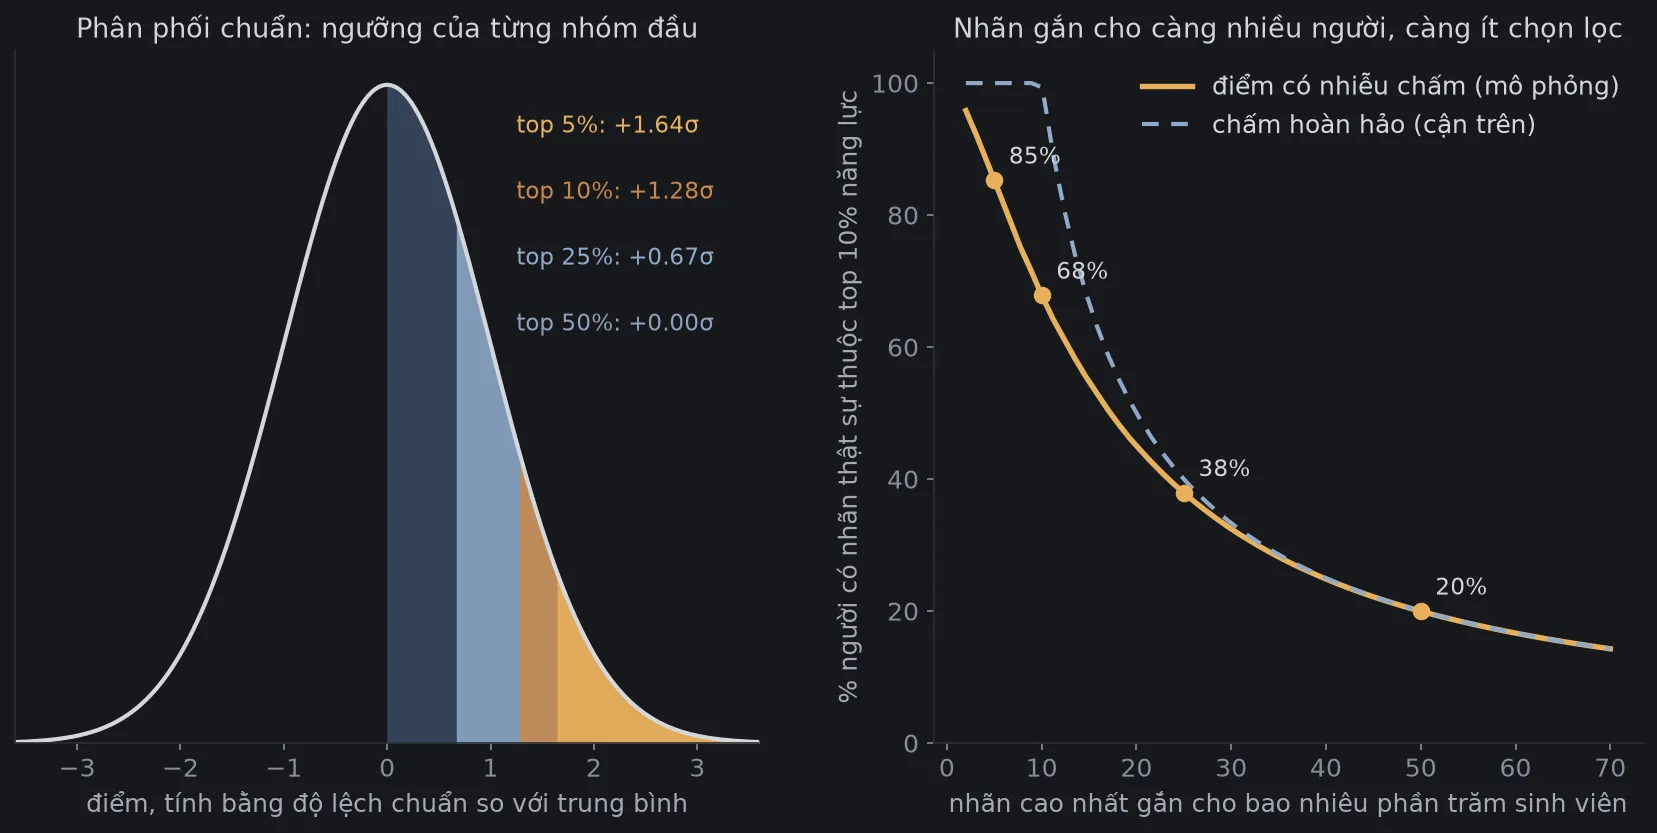
Khi dữ liệu đúng là phân phối chuẩn, ta tính được ngưỡng của từng nhóm đầu. Kết quả từ phần code ở cuối bài:
| Nhóm đầu | Ngưỡng điểm |
|---|---|
| 5% giỏi nhất | trung bình + 1,64 độ lệch chuẩn |
| 10% giỏi nhất | trung bình + 1,28 độ lệch chuẩn |
| 25% giỏi nhất | trung bình + 0,67 độ lệch chuẩn |
| 50% giỏi nhất | đúng ở trung bình |
Dòng cuối là điều đáng chú ý: nhãn gắn cho 50% sinh viên nghĩa là ngưỡng của nó nằm ngay giữa đám đông. Người ở ngay trên vạch giữa và người ở ngay dưới vạch giữa gần như không khác nhau, nhưng một người có nhãn cao nhất còn người kia thì không.
Cần nói ngay giới hạn: phân phối chuẩn xuất hiện khi một đại lượng là tổng của rất nhiều yếu tố nhỏ độc lập, và nó thường bị dùng sai với dữ liệu lệch mạnh hoặc bị chặn[4]. Điểm trung bình tích lũy bị chặn ở 4,0 nên không thể đúng là phân phối chuẩn. Ta dùng nó như một mốc tham chiếu, không phải một quy luật phải theo.
Nhãn gắn cho càng nhiều người thì còn chọn lọc được bao nhiêu?
Giả sử một nhà tuyển dụng muốn tìm 10% sinh viên giỏi nhất về năng lực thật. Họ dùng nhãn “xuất sắc” để lọc. Nếu nhãn chỉ gắn cho đúng 10% và điểm phản ánh năng lực hoàn hảo, mọi người có nhãn đều thuộc top 10%. Nếu nhãn gắn cho 50%, thì dù điểm hoàn hảo, nhiều nhất chỉ 1 trên 5 người có nhãn thuộc top 10%, vì 50% là gấp 5 lần 10%.
Thực tế còn tệ hơn, vì điểm không bao giờ phản ánh năng lực hoàn hảo: đề thi may rủi, người chấm khác nhau, ngày thi tốt ngày thi xấu. Chính nhiễu này là lý do người đứng đầu lần này hay kém đi ở lần sau, như bài hồi quy về trung bình đã nói. Mình mô phỏng 200.000 sinh viên, mỗi người có một năng lực thật theo phân phối chuẩn. Điểm của họ bằng năng lực cộng một nhiễu chấm điểm có độ lệch chuẩn 0,5. Kết quả, tính trong số những người có nhãn:
| Nhãn gắn cho | Thật sự thuộc top 10% năng lực (có nhiễu) | Cận trên (chấm hoàn hảo) |
|---|---|---|
| 5% | 85% | 100% |
| 10% | 68% | 100% |
| 25% | 38% | 40% |
| 50% | 20% | 20% |
Khi nhãn gắn cho 5%, hầu hết người có nhãn là người giỏi nhất. Khi gắn cho 50%, chỉ khoảng 1 trong 5 người có nhãn thuộc top 10%, bất kể chấm điểm tốt đến đâu. Đó là điều nhà tuyển dụng ở hàng ghế sau cảm nhận: nhãn không còn cho họ biết nhiều.
Một ví dụ đời thường: một nhà hàng mà ai cũng được 5 sao. Khách vẫn đọc được 5 sao, nhưng không biết quán nào thật sự ngon. Muốn phân biệt, họ phải tìm tín hiệu khác: bình luận chi tiết, số lượt đặt chỗ.
Báo chí ghi lại điều gì về “lạm phát điểm”?
Người ta gọi là lạm phát điểm (grade inflation) tình trạng điểm cao được cho nhiều hơn dù chất lượng bài làm không đổi, khiến điểm bị mất giá[3]. Cần phân biệt: chỉ riêng việc điểm trung bình tăng chưa chứng minh có lạm phát. Muốn chứng minh phải cho thấy bài làm không xứng đáng điểm cao hơn[3].
Tại Việt Nam, vấn đề này được bàn nhiều trong tháng 10 năm 2026. Theo báo chí, tại một hội nghị về giáo dục đại học ngày 1/10/2026, Bộ trưởng Bộ Giáo dục và Đào tạo nêu lo ngại tỷ lệ giỏi và xuất sắc tăng ở nhiều trường trong khi chất lượng thực chưa rõ. Ngày 16/10/2026, Bộ yêu cầu các trường rà soát kết quả học tập và không áp đặt tỷ lệ giỏi, xuất sắc[1]. Theo bản tin của CafeF, các trường được yêu cầu phân tích phân bố điểm theo ngành, khóa và hình thức đào tạo, đối chiếu với chuẩn đầu ra và phản hồi của nhà tuyển dụng, đồng thời không hạ chuẩn để chạy theo thành tích[2].
Cùng thời điểm, một bài báo tổng hợp thông báo tốt nghiệp năm 2025 và 2026 ghi nhận mức chênh lệch lớn giữa các khối ngành. Ở nhiều trường khối kinh tế và tài chính, nhóm giỏi và xuất sắc chiếm khoảng ba phần tư số sinh viên tốt nghiệp hoặc hơn. Ở một số trường kỹ thuật, tỷ lệ xuất sắc chỉ vài phần trăm. Ở một số trường y, có đợt không có sinh viên nào tốt nghiệp loại xuất sắc[1].
Bài báo đó không đưa ra phân tích độc lập về nguyên nhân của chênh lệch[1]. Mình cũng không suy diễn thêm. Điều có thể rút ra từ chính số liệu là: tỷ lệ giữa các khối ngành cách nhau rất xa, từ vài phần trăm đến hơn một nửa lớp, nên tỷ lệ xuất sắc chưa thể so sánh trực tiếp giữa các nơi.
Nhiều bằng xuất sắc có nhất thiết là xấu?
Không. Có ít nhất ba lý do chính đáng khiến tỷ lệ cao mà không có lạm phát.
Thứ nhất, chấm theo chuẩn năng lực (criterion-referenced) khác với chấm theo đường chuông (norm-referenced). Nếu nhà trường đặt chuẩn rõ ràng và sinh viên đạt chuẩn thật, thì nhiều sinh viên đạt xuất sắc là kết quả đúng, không cần bắt phân phối theo hình chuông. Thứ hai, chất lượng đầu vào có thể tăng theo thời gian. Thứ ba, việc quy đổi từ thang 10 sang thang 4 làm nhiều mức điểm khác nhau dồn về cùng một bậc.
Vậy lạm phát được nhận ra bằng cách nào? Không phải từ tỷ lệ một mình. Phải so cùng một mức bài làm qua các năm, hoặc đối chiếu với một phép đo bên ngoài: đề thi chung, kiểm tra chéo bài thi, hoặc kết quả sau tốt nghiệp. Đó chính là các việc mà Bộ yêu cầu các trường làm: lấy mẫu bài thi, đối chiếu với phản hồi của nhà tuyển dụng[2].
Có một ví dụ nước ngoài cho thấy tỷ lệ cũng có thể kéo lùi được khi nhà trường đặt chính sách. Một trường đại học ở Mỹ đặt mục tiêu giảm tỷ lệ điểm A: nó từ 47,9% năm học 2002–03 xuống 39,7% năm học 2008–09[3]. Ví dụ này không nói chính sách ấy tốt hay xấu, chỉ cho thấy tỷ lệ là thứ có thể điều chỉnh bằng chuẩn chấm.
Cũng nên biết cái giá của sự dồn điểm. Một nguồn tổng hợp ghi nhận khi điểm bị dồn lên cao, sinh viên ở phân vị 98 và sinh viên ở phân vị 82 có thể trở nên không phân biệt được[3]. Đó là sự nén thông tin: bậc điểm giữ nguyên nhưng khoảng cách thật giữa các sinh viên bị che đi.
Cùng cơ chế ở đầu tư: lạm phát xếp hạng
Nhãn cao nhất gắn cho quá nhiều đối tượng cũng xảy ra ở tài chính. Ví dụ rõ nhất là xếp hạng tín nhiệm: AAA là bậc cao nhất, nghĩa là ít rủi ro vỡ nợ nhất.
Từ năm 2000 đến 2007, hãng xếp hạng Moody’s xếp gần 45.000 chứng khoán gắn với các khoản vay thế chấp ở mức AAA, nhiều hơn một nửa số chứng khoán loại này mà hãng đã xếp hạng. Theo các tác giả được dẫn lại, 70% đến 80% các phần mới của sản phẩm nợ cấu trúc (CDO) được xếp AAA, dù tài sản bên dưới phần lớn chỉ ở mức BBB hoặc A-trừ. Đến tháng 4 năm 2010, theo ước tính của Ủy ban điều tra khủng hoảng tài chính Mỹ, 73% số chứng khoán thế chấp mà Moody’s xếp AAA năm 2006 đã bị hạ xuống mức rác[5]. Một số con số ở đây đến từ sách báo chí hoặc trích dẫn gián tiếp, nên hãy xem là mức độ lớn hơn là số chính xác[5].
Nguyên nhân thường được nêu là mâu thuẫn lợi ích: các ngân hàng đầu tư trả phí cho hãng xếp hạng để lấy mức xếp hạng mong muốn, và một nghiên cứu về 6.500 xếp hạng cho thấy mức xếp hạng thiên về những bên phát hành mang lại nhiều việc làm ăn hơn cho hãng[5].
Liên hệ với bài toán của chúng ta khá trực tiếp. Khi AAA gắn cho đa số, nhà đầu tư không thể dùng nhãn ấy để chọn ra phần an toàn nhất. Họ phải tìm tín hiệu khác: tự phân tích tài sản bên dưới, chênh lệch lãi suất so với trái phiếu chính phủ, hay các cách định giá tài sản riêng. Chuyện này cũng giống việc nhà tuyển dụng không thể chỉ dựa vào nhãn xuất sắc.
Ba điều dễ hiểu sai
Tỷ lệ xuất sắc cao thì chắc chắn là lạm phát? Không chắc. Như đã nói, chuẩn chấm, đầu vào và cách quy đổi điểm đều ảnh hưởng. Muốn kết luận phải có phép đo bên ngoài hoặc so sánh cùng mức bài làm qua thời gian[3].
Điểm phải theo phân phối chuẩn thì mới “đẹp”? Không. Phân phối chuẩn là một mốc tham chiếu hữu ích để tính ngưỡng, nhưng điểm bị chặn ở trần và chấm theo chuẩn năng lực không cần có hình chuông[4]. Điều cần có là nhãn cao nhất vẫn nói được điều gì đó.
Chỉ cần quy định cứng tỷ lệ xuất sắc là xong? Cũng không hẳn. Chính các văn bản quản lý được báo chí dẫn lại đã nêu không áp đặt tỷ lệ[1]. Lý do dễ hiểu: nếu tỷ lệ bị cố định, nhãn có thể được dùng để so sánh nội bộ nhưng không còn nói được liệu cả khóa học giỏi lên hay kém đi. Khi một chỉ số trở thành mục tiêu, người ta tối ưu nó thay vì tối ưu điều nó đo.
Viết gọn bằng ký hiệu
Phần này dành cho bạn muốn xem công thức. Bỏ qua cũng không mất ý chính.
Nếu điểm theo phân phối chuẩn có trung bình và độ lệch chuẩn , ngưỡng của nhóm phần trăm đầu là
trong đó là hàm ngược của hàm phân phối chuẩn tắc. Với ta có .
Nếu điểm phản ánh hoàn hảo xếp hạng năng lực và nhãn gắn cho nhóm phần đầu, tỷ lệ người có nhãn thuộc nhóm phần đầu năng lực là
Ví dụ , cho , khớp dòng cuối của bảng. Khi điểm có nhiễu, độ chính xác nằm dưới cận này.
Tự tay mô phỏng
Đoạn Python dưới đây tính ngưỡng của các nhóm đầu bằng phân phối chuẩn, mô phỏng 200.000 sinh viên giả định với năng lực thật và nhiễu chấm điểm, rồi đo độ chọn lọc của nhãn cao nhất. Nó vẽ ra Hình 1. Số liệu hoàn toàn giả định và mô hình rất đơn giản: nó giả định năng lực theo phân phối chuẩn và nhiễu cộng thêm, trong khi điểm thật bị chặn và có thể lệch. Nhiễu 0,5 do mình chọn. Seed cố định (2026) nên chạy lại cho kết quả giống hệt. Cần numpy và matplotlib.
from statistics import NormalDist
import matplotlib.pyplot as pltimport numpy as np
plt.rcParams.update({"figure.facecolor": "#16181c", "axes.facecolor": "#16181c", "text.color": "#d4d7dc",                     "axes.edgecolor": "#2a2e35", "axes.labelcolor": "#a4a9b2",                     "xtick.color": "#878d97", "ytick.color": "#878d97", "font.size": 12})
CHUAN = NormalDist()                      # phân phối chuẩn tắc: trung bình 0, độ lệch chuẩn 1TY_LE = [0.05, 0.10, 0.25, 0.50]          # nhãn cao nhất gắn cho 5%, 10%, 25%, 50% sinh viên
# Phần 1: ngưỡng điểm (tính theo độ lệch chuẩn trên trung bình) để nằm trong nhóm đầufor p in TY_LE:    print(f"nhóm đầu {p:.0%}: ngưỡng = trung bình + {CHUAN.inv_cdf(1 - p):.2f} độ lệch chuẩn")
# Phần 2: mô phỏng. Năng lực thật ~ chuẩn tắc; điểm = năng lực + nhiễu chấm điểm (độ lệch chuẩn 0,5).rng = np.random.default_rng(2026)N = 200_000nang_luc = rng.standard_normal(N)diem = nang_luc + 0.5 * rng.standard_normal(N)top10_that = nang_luc >= np.quantile(nang_luc, 0.90)     # 10% giỏi nhất theo năng lực thật

def do_chinh_xac(ty_le, d=diem):    """Trong số người được gắn nhãn (nhóm đầu theo điểm), bao nhiêu phần trăm thật sự thuộc top 10% năng lực."""    co_nhan = d >= np.quantile(d, 1 - ty_le)    return top10_that[co_nhan].mean()

print("nhãn gắn cho   độ chính xác (có nhiễu)   độ chính xác (chấm hoàn hảo)")for p in TY_LE:    ly_tuong = min(1.0, 0.10 / p)    print(f"{p:>10.0%}   {do_chinh_xac(p):>22.0%}   {ly_tuong:>26.0%}")
# Vẽfig = plt.figure(figsize=(14, 6))o = fig.add_gridspec(1, 2, width_ratios=[1.05, 1], wspace=0.24)
ax = fig.add_subplot(o[0])x = np.linspace(-3.6, 3.6, 600)y = np.exp(-x ** 2 / 2) / np.sqrt(2 * np.pi)ax.plot(x, y, color="#d4d7dc", lw=2)mau = {0.05: "#e8b05a", 0.10: "#c9884a", 0.25: "#8fa9c9", 0.50: "#3a4a63"}for p in TY_LE[::-1]:    z = CHUAN.inv_cdf(1 - p)    ax.fill_between(x, 0, y, where=x >= z, color=mau[p], alpha=0.85)for p, dy in zip(TY_LE, (0.37, 0.33, 0.29, 0.25)):    z = CHUAN.inv_cdf(1 - p)    ax.text(1.25, dy, f"top {p:.0%}: +{z:.2f}σ", color=mau[p] if p < 0.5 else "#8fa0bd", fontsize=11)ax.set_xlim(-3.6, 3.6)ax.set_ylim(0, 0.42)ax.set_yticks([])ax.set_xlabel("điểm, tính bằng độ lệch chuẩn so với trung bình")ax.set_title("Phân phối chuẩn: ngưỡng của từng nhóm đầu", color="#d4d7dc", fontsize=13)
ax = fig.add_subplot(o[1])ps = np.linspace(0.02, 0.70, 60)ax.plot(ps * 100, [do_chinh_xac(p) * 100 for p in ps], color="#e8b05a", lw=2.6, label="điểm có nhiễu chấm (mô phỏng)")ax.plot(ps * 100, [min(1, 0.10 / p) * 100 for p in ps], color="#8fa9c9", lw=2, ls=(0, (4, 3)), label="chấm hoàn hảo (cận trên)")for p in TY_LE:    v = do_chinh_xac(p) * 100    ax.scatter([p * 100], [v], color="#e8b05a", s=55, zorder=3)    ax.annotate(f"{v:.0f}%", (p * 100, v), xytext=(7, 8), textcoords="offset points", color="#d4d7dc", fontsize=11)ax.set_xlabel("nhãn cao nhất gắn cho bao nhiêu phần trăm sinh viên")ax.set_ylabel("% người có nhãn thật sự thuộc top 10% năng lực")ax.set_ylim(0, 105)ax.legend(frameon=False, loc="upper right")ax.set_title("Nhãn gắn cho càng nhiều người, càng ít chọn lọc", color="#d4d7dc", fontsize=13)for a_ in fig.axes:    for sp in ("top", "right"):        a_.spines[sp].set_visible(False)fig.savefig("lam-phat-diem.png", dpi=150, bbox_inches="tight")
Kết quả in ra:
nhóm đầu 5%: ngưỡng = trung bình + 1.64 độ lệch chuẩnnhóm đầu 10%: ngưỡng = trung bình + 1.28 độ lệch chuẩnnhóm đầu 25%: ngưỡng = trung bình + 0.67 độ lệch chuẩnnhóm đầu 50%: ngưỡng = trung bình + 0.00 độ lệch chuẩnnhãn gắn cho độ chính xác (có nhiễu) độ chính xác (chấm hoàn hảo) 5% 85% 100% 10% 68% 100% 25% 38% 40% 50% 20% 20%Bạn có thể đổi hệ số 0.5 ở dòng tính diem để thử các mức nhiễu khác. Nhiễu càng lớn thì đường vàng càng rời xa cận trên. Bạn cũng có thể đổi 0,90 trong top10_that thành 0,95 để hỏi về top 5% thay vì top 10%.
Quay lại lễ tốt nghiệp
Người nghiêng sang hỏi ở hàng ghế nhà tuyển dụng không hỏi sai. Anh ấy đang hỏi một việc mà nhãn xuất sắc, khi gắn cho một nửa, khó trả lời. Bản thân nhãn không có lỗi: nó vẫn chứng nhận rằng những sinh viên ấy đạt chuẩn của trường.
Muốn nhãn nói thêm điều gì đó, có hai hướng, và có thể dùng cả hai. Một là giữ chuẩn của nhãn gắn với phần ít người hơn. Hai là thêm một tín hiệu tách biệt cho nhóm nhiều người ấy, như thứ hạng trong khóa hay một bài đánh giá chung, để người đọc biết ai đứng ở đâu. Bài này không bảo hướng nào đúng, chỉ chỉ ra rằng một nhãn gắn cho nửa đám đông thì cần một thứ khác đi kèm.
Vẽ minh họa hình học miễn phí cho học sinh và giáo viên: EyeViz.
Tài liệu tham khảo
- [1]Doãn Nhàn. Chênh lệch tỷ lệ tốt nghiệp giỏi, xuất sắc giữa một số trường kinh tế - kỹ thuật - y dược. Tạp chí điện tử Giáo dục Việt Nam, đăng ngày 19/10/2026, 2026.
- [2]Siết tình trạng 'lạm phát' điểm số trong trường đại học. CafeF, đăng ngày 19/10/2026, 2026.
- [3]Grade inflation. Wikipedia.
- [4]Normal distribution. Wikipedia.
- [5]Credit rating agencies and the subprime crisis. Wikipedia.
- [6]Thông tư 08/2021/TT-BGDĐT ban hành Quy chế đào tạo trình độ đại học. Bộ Giáo dục và Đào tạo, 2021.