HDD vs SSD: khác nhau gì khi thiết kế hệ thống?
HDD vs SSD khác nhau không chỉ ở tốc độ. Hiểu đọc tuần tự, IOPS và độ trễ để chọn ổ cho cơ sở dữ liệu, kho video và hệ thống lưu trữ nhiều tầng.
Mục lục
Bạn chép một bộ phim vào ổ cứng. Thanh tiến trình chạy đều. Nhưng khi mở một thư mục chứa nhiều tệp nhỏ, máy lại khựng từng lúc. Tổng dung lượng có thể ít hơn bộ phim, vậy tại sao công việc lại lâu hơn?
HDD vs SSD không chỉ là cuộc so sánh xem ổ nào chép tệp nhanh hơn. HDD đọc dữ liệu bằng đầu đọc và đĩa quay, nên mỗi lần đổi vị trí có thể phải chờ chuyển động cơ học. SSD dùng chip nhớ, không có bước di chuyển đầu đọc ấy. Vì vậy SSD thường có lợi thế rõ khi hệ thống phải lấy nhiều mẩu dữ liệu rải rác; HDD vẫn đáng cân nhắc khi cần dung lượng lớn với chi phí thấp và chủ yếu đọc theo từng dải dài[1].
Khi thiết kế một dịch vụ, câu hỏi không dừng ở “cần bao nhiêu terabyte?”. Bạn còn phải biết dữ liệu được lấy ra như thế nào, người dùng được phép chờ bao lâu, và điều gì xảy ra khi nhiều yêu cầu cùng đến.
HDD và SSD khác nhau thế nào bên trong?
Hãy tưởng tượng một kho hồ sơ có những dãy kệ. Muốn lấy một tập giấy, nhân viên phải đi đến đúng kệ rồi tìm đúng vị trí. Nếu khách tiếp theo hỏi tập giấy ở đầu bên kia, nhân viên phải di chuyển tiếp.
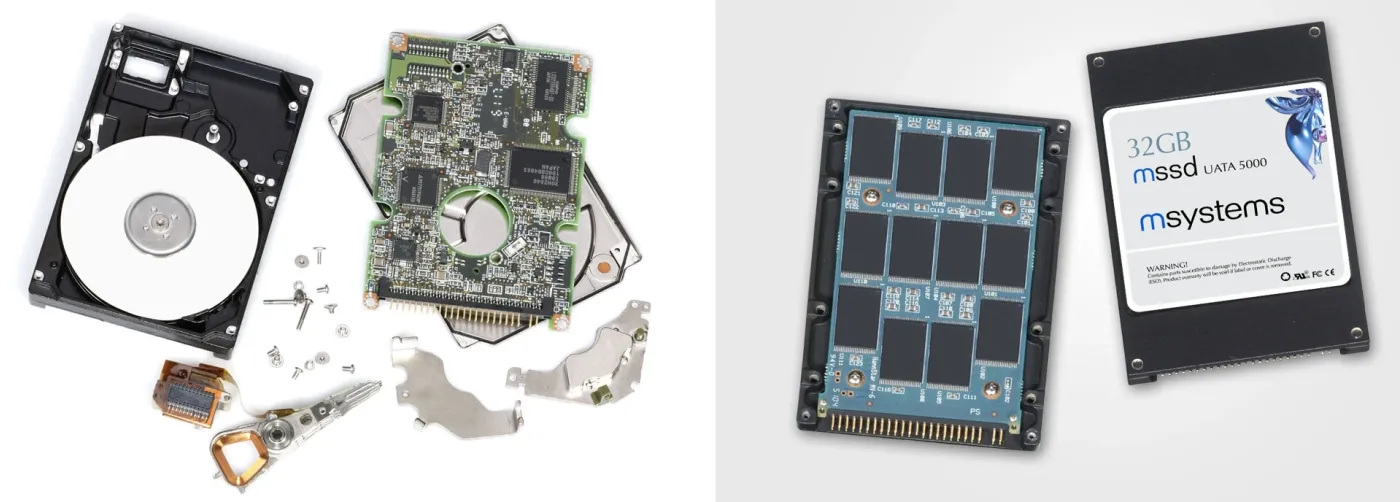
HDD, viết tắt của hard disk drive, cũng có phần chờ vị trí như vậy. Dữ liệu được lưu bằng từ tính trên những đĩa quay. Cụm đầu đọc phải đến đúng vùng, rồi chờ phần dữ liệu cần đọc quay tới bên dưới. Sau đó ổ mới truyền dữ liệu ra ngoài[1].
Có thể hình dung thời gian phục vụ một lần đọc gồm ba phần: đến đúng chỗ, chờ đúng đoạn quay tới, rồi chuyển dữ liệu. Đọc một dải dài giúp chia phần chờ ban đầu cho nhiều byte. Nhảy qua nhiều vị trí khiến phần chờ ấy lặp lại.
SSD, solid-state drive, lưu dữ liệu trong chip nhớ, thường là bộ nhớ flash NAND. Giống một kho có hệ thống điện tử chọn ngăn thay vì nhân viên phải đi bộ, SSD không cần đưa đầu đọc tới vị trí vật lý. Bộ điều khiển nhận yêu cầu rồi tổ chức truy cập các chip nhớ[1].
Điều đó không có nghĩa SSD trả dữ liệu ngay lập tức. Bộ điều khiển, chip nhớ, đường truyền và các yêu cầu đang chờ đều có thể tạo độ trễ. SSD loại bỏ một nguyên nhân chờ lớn của HDD, chứ không loại bỏ mọi nguyên nhân chờ.
Cũng đừng nhầm SSD với RAM, bộ nhớ làm việc của máy. RAM giống mặt bàn đang bày hồ sơ để xử lý; SSD và HDD giống chỗ cất hồ sơ lâu dài. Hai loại ổ đều giữ được dữ liệu khi tắt máy trong điều kiện sử dụng phù hợp, nhưng không thay thế vai trò của RAM.
Vì sao chép phim nhanh mà mở nhiều tệp nhỏ lại chậm?
Đọc tuần tự (sequential read) là lấy những vùng dữ liệu nằm nối tiếp nhau, như nhân viên lấy cả chồng hồ sơ trên cùng một kệ. Đọc ngẫu nhiên (random read) là lấy ở những vị trí rải rác, như liên tục nhận yêu cầu từ các dãy kệ khác nhau.
“Ngẫu nhiên” ở đây nói về vị trí truy cập, không nhất thiết do chương trình tung xúc xắc. Tra đơn hàng của từng khách khác nhau có thể tạo ra kiểu đọc ấy, dù từng câu truy vấn hoàn toàn có chủ đích.
Một tệp phim lớn thường tạo cơ hội đọc tuần tự. Mở nhiều tệp nhỏ có thể đòi hỏi tìm cả thông tin quản lý tệp lẫn nội dung ở nhiều nơi. Nếu chúng nằm rải rác, HDD phải đổi vị trí nhiều lần. Tệp lớn bị chia rải rác cũng có thể chậm; nhiều tệp nhỏ được sắp gần nhau và đọc gom lại có thể đỡ hơn.
Vì vậy, “một tệp” và “tuần tự” không phải cùng một khái niệm. Cách dữ liệu nằm trên ổ và cách phần mềm gửi lệnh mới quyết định công việc thực tế. Hệ điều hành còn có thể đọc đón trước hoặc giữ dữ liệu đã đọc để giảm số lần hỏi ổ.
Tài liệu Amazon EBS phân biệt đúng hai dạng công việc này. Các loại ổ dựa trên SSD được hướng tới thao tác nhỏ, thường xuyên; các loại dựa trên HDD được hướng tới luồng dữ liệu lớn, đọc ghi tuần tự[2]. Đây là cách phân loại dịch vụ cụ thể của AWS, không phải lời hứa rằng mọi HDD hoặc SSD đều có cùng hiệu năng.
Đừng chỉ nhìn con số MB/s trên hộp
Một xe tải có thể chở nhiều hàng trong mỗi chuyến nhưng vẫn mất lâu để giao từng phong bì. Lưu trữ cũng cần phân biệt lượng hàng đi qua với thời gian chờ một món.
Thông lượng (throughput) là lượng dữ liệu truyền được trong một khoảng thời gian, thường ghi bằng MB/s hoặc MiB/s. Độ trễ (latency) là thời gian từ lúc gửi yêu cầu tới lúc nhận kết quả. IOPS, số thao tác vào ra mỗi giây, giống số lượt giao hàng hoàn thành, chưa cho biết mỗi lượt chở bao nhiêu[3].
Giả sử một hệ thống hoàn thành 1.000 lượt đọc mỗi giây, mỗi lượt đúng 4 KiB. Thông lượng chỉ khoảng 3,91 MiB/s. Đây là phép tính minh họa: nhân số lượt với dung lượng mỗi lượt, rồi đổi đơn vị. Nó không phải kết quả đo một mẫu ổ.
Nếu mỗi lượt là 1 MiB và vẫn giữ được 1.000 lượt mỗi giây, thông lượng sẽ là 1.000 MiB/s. Nhưng đó là chữ “nếu” quan trọng: đường truyền và ổ có trần riêng, nên tăng kích thước lượt đọc có thể khiến số lượt mỗi giây giảm. Không thể ghép IOPS tối đa của một bài thử với MB/s tối đa của bài thử khác rồi coi là cùng một trạng thái vận hành.
Trong bài này, KiB bằng 1.024 byte, MiB bằng 1.024 KiB. Đơn vị MB dùng hệ thập phân lại bằng 1.000.000 byte. Giống hai cách đóng thùng khác nhau, cần dùng cùng đơn vị trước khi so số.
Bao nhiêu người đang cùng xếp hàng?
Độ sâu hàng đợi (queue depth, QD) cho biết có bao nhiêu yêu cầu còn chưa hoàn thành tại thời điểm xét. QD bằng 1 giống một khách chỉ đặt món tiếp theo sau khi nhận món trước. QD lớn hơn giống nhiều phiếu gọi món cùng nằm trong bếp.
SSD có thể tận dụng nhiều yêu cầu đồng thời để làm việc trên nhiều phần bộ nhớ. HDD có thể sắp lại một số yêu cầu để bớt di chuyển. Nhưng gửi thêm yêu cầu không làm tài nguyên tăng vô hạn: đến một lúc hàng chờ dài hơn và khách chờ lâu hơn[3].
Bởi vậy, một con số IOPS cao cần đi cùng kích thước thao tác, tỷ lệ đọc ghi và độ sâu hàng đợi. Với trang thanh toán, thời gian chờ từng yêu cầu còn quan trọng hơn con số tổng đẹp trong bài thử.
Cùng 256 MiB, vì sao thời gian lại khác nhau?
Ta dựng một kho giả định có hai loại ổ. HDD mất 8 mili giây chuẩn bị mỗi lần tới vùng mới, rồi truyền ở 180 MiB/s. SSD mất 0,1 mili giây chuẩn bị mỗi lượt, rồi truyền ở 500 MiB/s. Toàn bộ thông số này do ta chọn để minh họa, không đại diện cho sản phẩm cụ thể.
Đọc tổng cộng 256 MiB theo từng yêu cầu nối tiếp, không dùng dữ liệu lưu sẵn, không gom lệnh. Mỗi lượt nhỏ nằm ở một vùng mới. Trường hợp cuối đọc cả dải liên tục và chỉ trả chi phí chuẩn bị một lần. Code gần cuối bài tính ra:
| Cách đọc trong mô hình | Số lượt | HDD | SSD |
|---|---|---|---|
| Mỗi lượt 4 KiB, vị trí rải rác | 65.536 | 525,71 giây | 7,07 giây |
| Mỗi lượt 64 KiB, vị trí rải rác | 4.096 | 34,19 giây | 0,92 giây |
| Mỗi lượt 1 MiB, vị trí rải rác | 256 | 3,47 giây | 0,54 giây |
| Một dải 256 MiB liên tục | 1 | 1,43 giây | 0,51 giây |
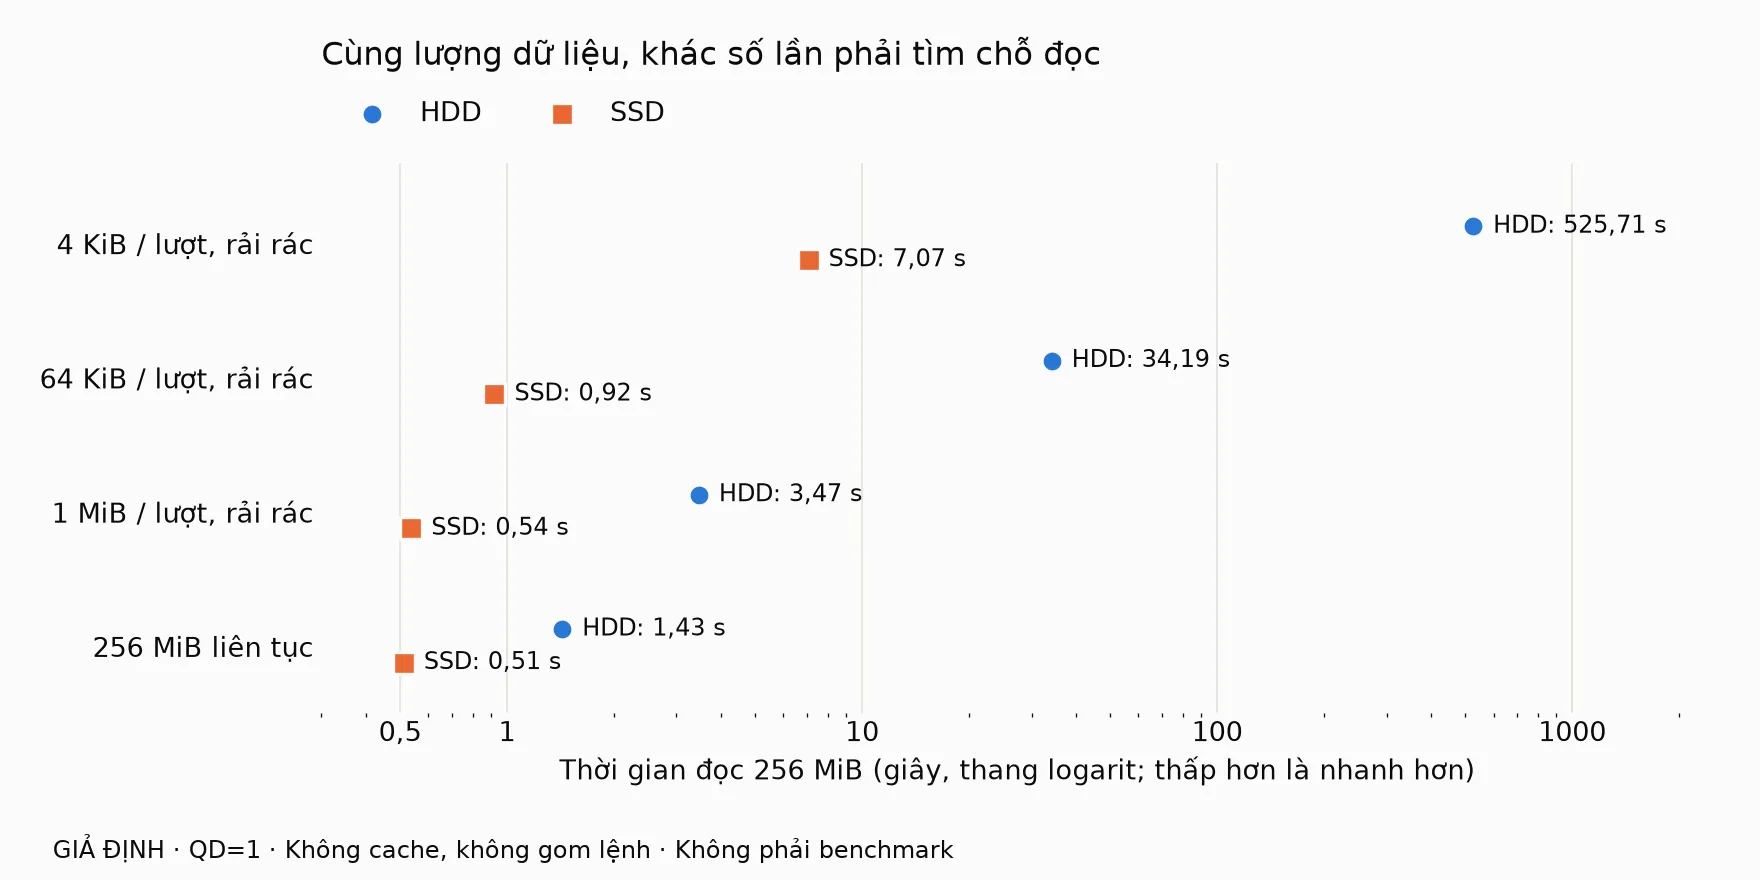
Với lượt đọc 4 KiB, HDD trong mô hình dành phần lớn thời gian cho 65.536 lần chuẩn bị. Khi chuyển sang một dải dài, phần ấy gần như biến mất. SSD vẫn nhanh hơn, nhưng khoảng cách thay đổi theo cách đọc chứ không phải một tỷ lệ cố định.
Mô hình cố ý bỏ qua nhiều thứ: đọc đón trước, bộ nhớ đệm, xử lý song song, vị trí thật trên đĩa và chi phí hệ thống tệp. Dòng cuối cũng không khẳng định hệ điều hành gửi đúng một lệnh 256 MiB. Nó đại diện cho một luồng liên tục lý tưởng, không phải cách chia lệnh của thiết bị thật.
Bài học là gom dữ liệu chỉ giúp khi thực sự giảm việc tìm và chờ. Đóng nhiều tệp vào một tệp lớn nhưng sau đó vẫn nhảy qua các vị trí rải rác chưa chắc tạo ra cùng lợi ích.
Cơ sở dữ liệu cần dung lượng hay cần tìm nhanh?
Giả sử bạn mở lịch sử đơn hàng. Cơ sở dữ liệu tìm mã khách trong một danh mục rồi lấy những trang dữ liệu tương ứng. Chỉ mục (index) giống mục lục của kho hồ sơ: thay vì đọc hết kho, ta tìm các vị trí có khả năng chứa thứ cần lấy.
Nhưng mục lục và hồ sơ có thể ở nhiều chỗ. Một truy vấn chỉ trả về ít chữ vẫn có thể phải đọc nhiều trang trên ổ. Bài tìm kiếm nhị phân và cách cơ sở dữ liệu đọc theo trang giải thích vì sao giảm số lần đọc thường quan trọng hơn giảm vài phép so sánh.
SSD thường là điểm bắt đầu hợp lý cho phần dữ liệu được hỏi thường xuyên và cần phản hồi ngắn. Tuy vậy, đổi ổ không chữa được một truy vấn phải lục cả kho khi chỉ cần một đơn hàng. Nếu dữ liệu cần đọc đã nằm trong RAM, ổ nhanh hơn cũng có thể ít ảnh hưởng đến lượt truy vấn đó.
Cache, nơi giữ bản để dùng lại, giống chồng hồ sơ đã đặt sẵn trên bàn. Nó giảm số lần xuống kho, nhưng lúc vừa khởi động hoặc gặp dữ liệu chưa có, hệ thống vẫn phải đọc ổ. Vì thế cần đo cả lúc đã có sẵn dữ liệu lẫn lúc bộ nhớ đệm trống. Câu chuyện đổi ảnh đại diện nhưng vẫn thấy ảnh cũ đi sâu vào lợi ích và cái giá của những bản sao này.
Vì sao cơ sở dữ liệu thích ghi vào sổ trước?
Khi sửa nhiều hồ sơ ở các kệ khác nhau, có một cách giảm việc phải chạy khắp kho ngay lập tức: ghi thay đổi vào sổ theo thứ tự, rồi cập nhật kệ sau.
Đó là trực giác của nhật ký ghi trước (write-ahead log, WAL). PostgreSQL yêu cầu thông tin nhật ký tương ứng được đưa tới nơi lưu bền trước khi ghi các trang dữ liệu thay đổi. Với cấu hình cam kết bền vững, giao dịch có thể xác nhận sau khi phần nhật ký cần thiết đã được lưu bền; các trang dữ liệu được ghi sau và có thể phục hồi từ nhật ký[4].
“Lưu bền” không chỉ là đưa vào RAM của hệ điều hành. Nó giống việc sổ đã nằm trong chỗ cất chịu được sự cố theo cam kết của hệ thống, chứ không còn là lời nhắn trên mặt bàn. Cơ chế yêu cầu đẩy dữ liệu xuống thiết bị, chẳng hạn fsync, liên quan trực tiếp đến thời gian chờ xác nhận.
Ghi nối tiếp giúp giảm di chuyển trên HDD. Trên SSD, giảm số lần đồng bộ và gom công việc vẫn có ích. Nhưng WAL không biến toàn bộ cơ sở dữ liệu thành một luồng tuần tự: đọc hồ sơ và cập nhật các trang phía sau vẫn còn đó. Đây cũng là lý do cách tổ chức kiểu cuốn sổ ghi của Kafka đáng hiểu, dù không thể coi mọi hệ thống dùng sổ ghi là cùng một kiến trúc.
SSD có điểm yếu nào ngoài giá?
NAND không hoạt động như một tờ giấy có thể tẩy riêng từng chữ tùy ý. Nó ghi theo đơn vị trang nhưng xóa theo khối lớn hơn. Khi cập nhật, bộ điều khiển thường ghi dữ liệu mới sang chỗ khác và đánh dấu bản cũ không còn hợp lệ[6].
Đến lúc dọn chỗ, những trang còn dùng trong một khối có thể phải được chuyển đi trước khi xóa cả khối. Thu gom rác (garbage collection) ở đây giống dọn một kệ: phải chuyển các hồ sơ còn giá trị sang kệ khác rồi mới bỏ được cả phần cũ.
Các lần chép nội bộ tạo ra khuếch đại ghi (write amplification): ứng dụng gửi một lượng dữ liệu, nhưng chip nhớ thực sự phải nhận nhiều lượt ghi hơn. Giống sửa một hồ sơ mà nhân viên còn phải chuyển cả chồng giấy xung quanh, công việc phía sau lớn hơn yêu cầu ban đầu[6].
Chip flash cũng có giới hạn chịu ghi xóa. TBW, terabytes written, là một chỉ số mức ghi tích lũy dùng trong thông số độ bền; cần đọc định nghĩa và điều kiện bảo hành của đúng mẫu ổ. Nó giống hạn mức quãng đường trong bảo hành xe, không phải lời hẹn rằng cứ chạm con số đó là thiết bị lập tức hỏng[1].
Vì vậy, hệ thống ghi nhiều cần xem khả năng duy trì tốc độ sau giai đoạn ghi ngắn ban đầu, dung lượng trống, mức chịu ghi và hành vi khi mất điện. Không có bộ phận chuyển động cũng không đồng nghĩa không thể mất dữ liệu. HDD lẫn SSD đều cần kế hoạch sao lưu và thử khôi phục.
SATA và NVMe có phải hai loại bộ nhớ?
Không. SATA và NVMe mô tả cách giao tiếp với thiết bị lưu trữ, giống đường vận chuyển vào kho, không phải thứ cất bên trong kho. SSD có thể dùng SATA; NVMe thường chạy qua PCIe để khai thác đường truyền và khả năng xử lý phù hợp với bộ nhớ flash[5].
M.2 lại là chuẩn hình dạng và kết nối vật lý thường gặp, giống kích thước cánh cửa và kiểu chân cắm[5]. Có SSD M.2 dùng SATA, cũng có loại dùng NVMe. Thấy thanh ổ nhỏ chưa đủ để suy ra tốc độ hoặc tính tương thích.
Trong thiết kế hệ thống, tên giao tiếp chỉ là một phần. Một SSD có đường truyền nhanh vẫn có thể bị giới hạn bởi kiểu đọc ghi, nhiệt độ, bộ điều khiển hoặc công việc đang chờ.
Nên chọn HDD, SSD hay dùng cả hai?
Hãy quay lại kho hồ sơ. Hồ sơ được hỏi liên tục nên đặt gần quầy. Những thùng lưu từ lâu có thể nằm ở kho xa hơn, nếu thời gian lấy về vẫn đáp ứng nhu cầu.
Lưu trữ theo tầng (tiered storage) áp dụng cùng cách nghĩ: đặt dữ liệu ở các lớp có chi phí và mức phục vụ khác nhau. Dữ liệu “nóng” là phần được dùng thường xuyên, như đơn hàng đang xử lý. Dữ liệu “lạnh” là phần ít được hỏi, như video gốc đã dựng xong và chỉ thỉnh thoảng mở lại. Hai từ này không nói về nhiệt độ ổ.
| Công việc chính | Điểm bắt đầu nên cân nhắc | Điều phải kiểm tra |
|---|---|---|
| Tra cứu giao dịch, nhiều lượt đọc nhỏ | SSD | Độ trễ khi đông yêu cầu, dữ liệu có sẵn trong RAM hay chưa |
| Tìm kiếm tương tác, nhiều vị trí rải rác | SSD | Số vùng phải đọc cho mỗi yêu cầu |
| Kho video gốc, chủ yếu lấy từng tệp lớn | HDD hoặc tầng dung lượng rẻ | Tổng thông lượng khi nhiều người cùng đọc |
| Nhật ký đang ghi và xử lý liên tục | Tùy tải, có thể dùng SSD hoặc HDD | Có thật sự tuần tự không, cần xác nhận bền nhanh đến mức nào |
| Lưu trữ lâu dài, ít truy cập | Tầng chi phí thấp phù hợp | Thời gian lấy lại, chi phí truy xuất, thử khôi phục |
Đây là điểm xuất phát, không phải quy tắc cứng. Một kho video có hàng nghìn người cùng nhảy tới những đoạn khác nhau sẽ tạo công việc khác với một người chép nguyên tệp. Một hệ thống nhật ký nhiều luồng cũng chưa chắc tạo thành một luồng tuần tự ở thiết bị cuối.
Chi phí phải tính theo cả dịch vụ đáp ứng được, không chỉ theo dung lượng mua vào. HDD có thể rẻ hơn trên mỗi terabyte, nhưng nếu cần nhiều ổ để đủ lượt tìm hồ sơ mỗi giây, phần tiết kiệm ấy có thể giảm. SSD đắt hơn mỗi terabyte vẫn có thể hợp lý cho phần dữ liệu nhỏ nhưng được hỏi liên tục[1].
Nếu thuê lưu trữ đám mây, hãy đọc giới hạn dịch vụ: dung lượng, IOPS, thông lượng, độ trễ và giới hạn phía máy chủ. Tài liệu EBS lưu ý cấu hình máy và đặc điểm thao tác đều có thể giới hạn hiệu năng[2]. Nhãn “SSD” không tự bảo đảm ứng dụng sẽ khai thác được tốc độ của chip bên dưới.
Trước khi quyết định, hãy xác định kích thước lượt đọc ghi điển hình, mức đồng thời và tỷ lệ truy cập rải rác. Sau đó thử với công việc gần thực tế, chạy đủ lâu để thấy trạng thái ổn định, không chỉ đoạn tăng tốc ban đầu. Ghi cả thời gian chờ của nhóm yêu cầu chậm, chẳng hạn p99, mức mà 99% lượt hoàn thành không chậm hơn. Nó giống việc nhìn thời gian phục vụ gần cuối hàng, thay vì chỉ lấy thời gian trung bình của cả quán.
Tự tay mô phỏng số lần phải tìm chỗ đọc
Đoạn Python này tạo đúng hình và bảng ở trên. Chạy từ thư mục dự án có matplotlib; chương trình chỉ tính toán, không thử tốc độ hay ghi đè dữ liệu trên ổ. Không có ngẫu nhiên nên chạy lại sẽ cho cùng kết quả.
Mô hình dùng quy tắc: thời gian bằng số lượt nhân chi phí chuẩn bị, cộng tổng dung lượng chia tốc độ truyền. Bạn có thể đổi các giả định ở drives, hoặc đổi sizes để xem việc gom lượt đọc ảnh hưởng ra sao.
from pathlib import Path
import matplotlibmatplotlib.use("Agg")import matplotlib.pyplot as pltfrom matplotlib.ticker import FuncFormatter
# Mô hình giả định, không đọc hay ghi thử lên ổ đĩa thật.TOTAL = 256 * 1024**2sizes = [4 * 1024, 64 * 1024, 1024**2, TOTAL]labels = ["4 KiB / lượt, rải rác", "64 KiB / lượt, rải rác",          "1 MiB / lượt, rải rác", "256 MiB liên tục"]drives = {"HDD": (0.008, 180 * 1024**2),          "SSD": (0.0001, 500 * 1024**2)}colors = ["#2a78d6", "#eb6834"]surface, ink, grid = "#fcfcfb", "#0b0b0b", "#e1e0d9"plt.rcParams.update({"font.family": "DejaVu Sans", "font.size": 12,                     "text.color": ink, "axes.labelcolor": ink,                     "xtick.color": ink, "ytick.color": ink})fig, ax = plt.subplots(figsize=(11, 5.5), facecolor=surface)ax.set_facecolor(surface)for i, (name, (delay, rate)) in enumerate(drives.items()):    # QD=1: chờ xong một lượt mới gửi lượt tiếp theo.    times = [(TOTAL // size) * delay + TOTAL / rate for size in sizes]    ys = [j + (i - 0.5) * 0.25 for j in range(len(sizes))]    ax.scatter(times, ys, s=90, marker=["o", "s"][i], color=colors[i],               edgecolor=surface, linewidth=1.5, label=name, zorder=3)    for t, y in zip(times, ys):        text = f"{name}: {t:.2f} s".replace(".", ",")        ax.annotate(text, (t, y), xytext=(9, 0),                    textcoords="offset points", va="center", fontsize=11)    print(name, ", ".join(f"{t:.4f} s" for t in times))ax.set_xscale("log")ax.set_xlim(0.3, 2500)ax.set_xticks([0.5, 1, 10, 100, 1000])ax.xaxis.set_major_formatter(FuncFormatter(lambda x, _: f"{x:g}".replace(".", ",")))ax.set_yticks(range(len(labels)), labels)ax.set_ylim(3.5, -0.6)ax.set_xlabel("Thời gian đọc 256 MiB (giây, thang logarit; thấp hơn là nhanh hơn)")ax.set_title("Cùng lượng dữ liệu, khác số lần phải tìm chỗ đọc", loc="left", pad=44)ax.grid(axis="x", color=grid, linewidth=0.7)ax.tick_params(axis="both", length=0)for spine in ax.spines.values():    spine.set_visible(False)ax.legend(loc="lower left", bbox_to_anchor=(0, 1.02), ncol=2, frameon=False)fig.text(0.03, 0.025, "GIẢ ĐỊNH · QD=1 · Không cache, không gom lệnh · Không phải benchmark", fontsize=11)fig.tight_layout(rect=(0.01, 0.075, 0.99, 0.99))out = Path("images/hdd-vs-ssd/kich-thuoc-luot-doc.png")out.parent.mkdir(parents=True, exist_ok=True)fig.savefig(out, dpi=160, facecolor=surface)plt.close(fig)
Bỏ bước chờ nối tiếp sẽ cần một mô hình khác, không phải chỉ chia mọi thời gian cho số yêu cầu đồng thời. Thiết bị có giới hạn riêng, và nhiều việc cùng đến cũng làm phát sinh hàng chờ. Mục đích của phép tính này là tách phần chờ vị trí khỏi phần truyền dữ liệu, không dự đoán tốc độ của máy bạn.
Trở lại bộ phim và thư mục nhiều tệp
Bộ phim được chép nhanh vì nó có thể cho ổ làm một việc dài, ít phải dừng tìm chỗ khác. Thư mục nhiều tệp nhỏ có thể bắt ổ lặp lại công việc chuẩn bị, dù tổng số byte ít hơn. SSD giảm mạnh phần chờ cơ học ấy, còn tổ chức dữ liệu tốt giúp giảm số lần phải đi lấy.
Khi thiết kế hệ thống, bạn không chỉ mua một cái kho đủ rộng. Bạn đang thiết kế cách phục vụ những người liên tục đến hỏi hồ sơ. Chọn HDD hay SSD bắt đầu từ việc nhìn xem họ hỏi gì, hỏi theo thứ tự nào và được phép đứng chờ bao lâu.
Ảnh bìa: Rochellesinger / Wikimedia Commons, giấy phép CC BY-SA 2.5. Ảnh được thu nhỏ và chuyển sang WebP; bản ảnh đã chuyển đổi được chia sẻ theo cùng giấy phép.
Vẽ minh họa hình học miễn phí cho học sinh và giáo viên: EyeViz.
Tài liệu tham khảo
- [1]Hard disk drive versus solid-state drive. IBM Think.
- [2]Amazon EBS volume types. Amazon Web Services.
- [3]Amazon EBS I/O characteristics and monitoring. Amazon Web Services.
- [4]Write-Ahead Logging (WAL). PostgreSQL Documentation.
- [5]Solid-state drives (SSDs). IBM Think.
- [6]Write amplification. Wikipedia.