Đổi ảnh đại diện rồi, sao người khác vẫn thấy ảnh cũ?
Đổi ảnh đại diện nhưng vẫn hiện ảnh cũ? Tìm hiểu cache, cách hệ thống giữ bản sao và vì sao chatbot AI cũng phải cân nhắc khi dùng lại câu trả lời.
Mục lục
Bạn vừa đổi ảnh đại diện. Trên điện thoại, ảnh mới đã hiện. Bạn nhắn cho một người bạn: “Thấy ảnh mới chưa?”
“Ảnh nào? Vẫn như cũ mà.”
Bạn mở laptop kiểm tra. Đúng là ảnh cũ. Bấm tải lại trang. Vẫn thế. Trong một thoáng, bạn bắt đầu nghi ngờ mình chưa bấm lưu.
Một nguyên nhân có thể nằm ở cache, nơi giữ bản sao để lần sau dùng lại, khỏi phải đi lấy từ đầu. Ảnh mới đã được lưu ở nguồn, nhưng đâu đó trên đường tới người xem, bản cũ vẫn được sử dụng. Không phải mọi lỗi đổi ảnh đều do cache; đây là một tình huống giúp ta thấy cơ chế ấy rõ nhất.
Vậy tại sao một hệ thống lại cố giữ thứ đã cũ? Muốn trả lời, hãy thử hình dung mỗi lần mở lại một trang web, máy tính đều phải làm lại mọi thứ.
Nếu mỗi lần đều phải đi lấy lại
Bạn mở trang một quán cà phê để xem thực đơn. Vài phút sau, bạn mở lại để gửi cho bạn bè. Ảnh các món vẫn như trước, tên quán vẫn vậy, địa chỉ cũng chưa đổi.
Nếu thiết bị đã có những tấm ảnh ấy, tải lại toàn bộ chỉ khiến bạn chờ và tốn thêm dung lượng mạng. Giống như vừa tra được một số điện thoại, ta thường ghi lại thay vì mở danh bạ tìm từ đầu mỗi lần cần gọi.
Cache làm đúng việc ấy với dữ liệu. Khi cần một thứ, hệ thống tìm trong chỗ đã lưu trước. Có và còn được phép dùng thì lấy ra: cache hit. Không có hoặc không dùng được thì phải tìm đến nguồn: cache miss.
“Nguồn” cũng không nhất thiết chỉ là một tệp ảnh. Nó có thể là cơ sở dữ liệu, kết quả của một phép tính tốn thời gian, hoặc câu trả lời từ một dịch vụ khác. Lợi ích nằm ở phần công việc được tránh làm lại.
Đây cũng là tinh thần quen thuộc trong bài Bloom filter: thêm một bước kiểm tra rẻ ở phía trước để giảm công việc đắt ở phía sau. Nhưng Bloom filter giúp loại những lần tra cứu không cần thiết; cache có thể giữ luôn kết quả cần trả.
Vì sao đổi ảnh đại diện rồi vẫn hiện ảnh cũ?
Hãy tưởng tượng một trang web lưu ảnh của bạn tại địa chỉ /anh-dai-dien/lan.jpg. Laptop tải ảnh này lúc 9 giờ. Máy chủ cho phép bản ảnh được dùng lại trong mười phút.
9 giờ 2 phút, bạn đổi ảnh. Nội dung ở địa chỉ ấy đã khác, nhưng laptop chưa nhất thiết biết. Nếu chính sách cache vẫn cho phép dùng bản đang giữ, nó có thể tiếp tục hiển thị ảnh tải lúc 9 giờ.
“Còn hạn sử dụng” khác với “mới nhất tại nguồn”. Còn hạn chỉ có nghĩa bản sao vẫn được phép dùng theo quy tắc đã đặt ra. Nó không chứng minh rằng trong thời gian ấy chẳng có gì thay đổi.
Với HTTP, máy chủ có thể chỉ định khoảng thời gian này bằng Cache-Control: max-age=600. Khi bản lưu không còn đủ mới theo quy tắc, cache thường phải kiểm tra lại hoặc lấy bản khác trước khi phục vụ; hết hạn không đồng nghĩa tệp lập tức bị xóa khỏi ổ đĩa[2].
Thời gian sống thường được gọi là TTL, viết tắt của time to live. Chọn TTL dài giúp tái sử dụng nhiều hơn, nhưng cũng kéo dài khoảng thời gian có thể chưa thấy cập nhật. Chọn ngắn khiến bản sao được kiểm tra hoặc thay thế thường xuyên hơn.
Không có một con số hợp lý cho tất cả: ảnh của một bài viết đã hoàn thành có thể giữ lâu; tình trạng còn chỗ của một chuyến xe lại cần cách xử lý khác.
Bạn đang nhìn bản sao ở đâu?
Trên Internet, không chỉ laptop có thể giữ ảnh. Một đường đi đơn giản có thể là:
Trình duyệt → CDN → Máy chủ gốcTrình duyệt giữ bản trên thiết bị của bạn. CDN, mạng lưới máy chủ phân phối nội dung, có thể giữ bản gần khu vực người xem. Máy chủ gốc giữ nội dung mà những nơi kia lấy về. Trong một ứng dụng phức tạp, còn có thể có cache phía máy chủ cho dữ liệu hồ sơ hoặc kết quả truy vấn[1].
Vì thế, xóa bản trong trình duyệt chưa chắc đã lấy được ảnh mới: yêu cầu tiếp theo có thể gặp một bản cũ ở tầng khác. Ngược lại, nếu thông tin hồ sơ vẫn trỏ tới địa chỉ ảnh cũ, tải ảnh hoàn toàn chính xác cũng chưa giải quyết được vấn đề.
Điện thoại và laptop không nhất thiết có cùng bản lưu, tải vào cùng thời điểm hay đi qua cùng máy chủ trung gian. Hai màn hình khác nhau không nhất thiết có nghĩa một trong hai thiết bị bị lỗi.
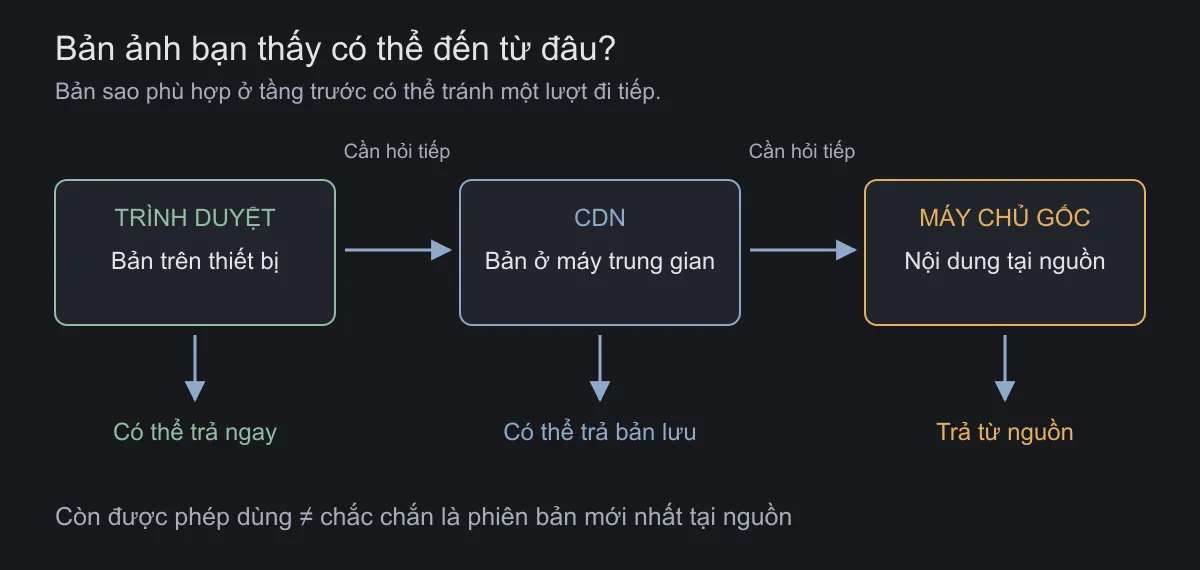
Có dùng mạng không, và có tải lại ảnh không?
Hãy theo một tệp ảnh qua ba lần mở trang. Lần đầu, thiết bị chưa có gì nên phải nhận nội dung từ máy chủ phục vụ ảnh. Lần sau, nó có thể dùng ngay bản đã giữ. Lần khác nữa, nó hỏi xem bản giữ ấy còn đúng không rồi mới quyết định có tải lại.
| Tình huống | Có hỏi máy chủ qua mạng? | Có truyền lại toàn bộ nội dung ảnh? |
|---|---|---|
| Bản trong trình duyệt còn được phép dùng ngay | Không cần cho yêu cầu ảnh đó | Không |
Kiểm tra phiên bản và nhận 304 Not Modified |
Có | Không |
| Máy chủ gửi một bản ảnh để thay thế | Có | Có |
Đây là ba đường đi khác nhau, dù cuối cùng bạn có thể vẫn thấy cùng một tấm ảnh. “Không tải lại ảnh” chưa chắc là “không hỏi lại máy chủ”. Một yêu cầu qua mạng cũng chưa chứng minh đã lấy dữ liệu từ nguồn gốc: CDN có thể là nơi trả lời[1].
Với người dùng, các bước này gần như vô hình. Nhưng với người vận hành, chúng khác nhau về độ trễ, dung lượng truyền và lượng công việc ở phía sau. Đến cuối bài, bạn có thể tự quan sát chúng trong trình duyệt.
Muốn thấy ảnh mới, có phải xóa hết cache?
Có một cách dễ hiểu hơn: ảnh mới có địa chỉ mới.
Thay vì ghi đè nội dung của lan.jpg, hệ thống lưu thành lan-v2.jpg rồi cập nhật hồ sơ để trỏ tới địa chỉ mới. Bản cũ có thể vẫn nằm trong cache, nhưng khi trang đã nhận được địa chỉ mới, nó sẽ yêu cầu đúng ảnh mới. Với tài nguyên web, tên tệp thường chứa mã băm của nội dung để phân biệt phiên bản. Cách này thường được gọi là cache busting[1].
Cũng có trường hợp không cần tải lại cả tệp. Cache hỏi nguồn xem phiên bản mình giữ có còn khớp không; nếu có, nguồn trả lời 304 Not Modified và bản cũ tiếp tục được dùng. Những dấu nhận diện như ETag giúp thực hiện việc kiểm tra ấy[2].
Một lựa chọn khác là chủ động vô hiệu hóa bản lưu khi dữ liệu thay đổi, gọi là invalidation. Nhưng càng nhiều nơi giữ bản sao, càng cần xác định nơi nào phải nhận được thông báo và chuyện gì xảy ra nếu thông báo đến chậm.
Đổi tên ảnh giải quyết chuyện nhận diện phiên bản; thông tin hồ sơ trỏ tới ảnh nào vẫn cần được cập nhật. Mỗi giải pháp chỉ tháo một phần của nút thắt.
Đã xóa cache, sao ảnh cũ còn quay lại?
Tạm rời tệp ảnh để nhìn vào thông tin hồ sơ: một bản ghi chứa tên và địa chỉ ảnh đại diện. Ứng dụng giữ bản ghi này trong cache để tránh hỏi cơ sở dữ liệu mỗi lần ai đó mở trang cá nhân.
Cách làm dễ nghĩ nhất là: đọc thì tra cache trước, không thấy thì đọc cơ sở dữ liệu rồi lưu kết quả; sửa thì cập nhật cơ sở dữ liệu và xóa bản cache. Cách tổ chức ấy thường được gọi là cache-aside.
Nhìn riêng từng yêu cầu, mọi thứ có vẻ hợp lý. Nhưng người xem và người sửa hồ sơ có thể cùng xuất hiện.
Giả sử An mở trang cá nhân của bạn đúng lúc bạn đổi ảnh:
| Thời điểm | Yêu cầu đọc của An | Yêu cầu đổi ảnh của bạn |
|---|---|---|
| 1 | Không thấy hồ sơ trong cache | |
| 2 | Đọc được hồ sơ phiên bản 1 từ cơ sở dữ liệu, nhưng chưa ghi vào cache | |
| 3 | Lưu hồ sơ phiên bản 2, trỏ tới ảnh mới | |
| 4 | Xóa khóa cache của hồ sơ | |
| 5 | Ghi kết quả phiên bản 1 đã đọc vào cache |
Bạn đã lưu ảnh mới. Bước xóa cache cũng đã chạy. Thế mà yêu cầu đến sau vẫn có thể đọc phiên bản 1, vì yêu cầu của An hoàn thành muộn và đưa dữ liệu cũ trở lại.
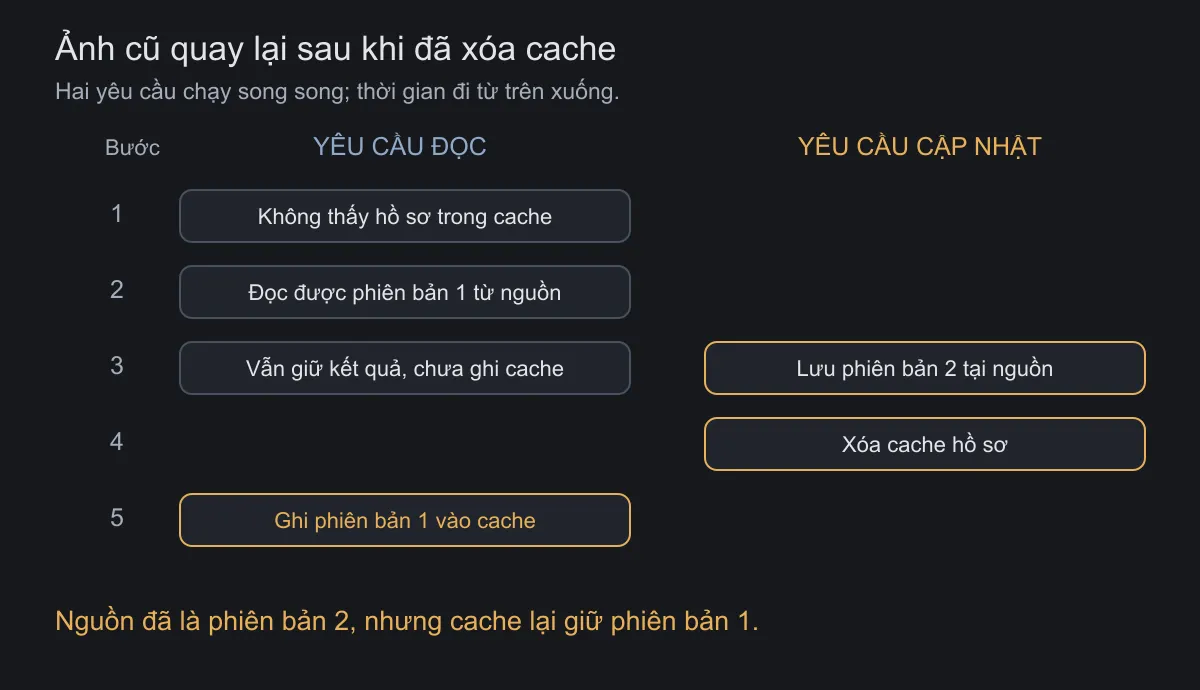
Đây là một race condition: kết quả phụ thuộc thứ tự các thao tác xen vào nhau. Bài toán đồng bộ cache không chỉ nằm ở việc nhớ gọi lệnh xóa[7].
Đổi thứ tự hai bước có đủ không?
Nếu xóa cache trước rồi mới cập nhật cơ sở dữ liệu, khoảng trống giữa hai bước cũng có thể cho một yêu cầu đọc lấy dữ liệu cũ và nạp lại. Nếu ghi cả dữ liệu mới vào cache, một yêu cầu cũ hoàn thành muộn vẫn có thể ghi đè, trừ khi có cơ chế ngăn điều đó.
Một hướng là gắn phiên bản cho dữ liệu và chỉ chấp nhận kết quả phù hợp. Nhưng con số phiên bản tự nó chưa đủ: nếu xóa sạch cả dấu vết của phiên bản mới nhất, nơi nhận bản cũ lấy gì để biết phải từ chối? Quy tắc so sánh cần được thực hiện cùng thao tác ghi, và thông tin về phiên bản cần được giữ ở nơi thích hợp. Khóa phối hợp hoặc luồng cập nhật có thứ tự là những lựa chọn khác, đổi lại thêm chờ đợi và phức tạp.
Ví dụ hai yêu cầu ở trên là tình huống giản lược để nhìn thấy vấn đề. Trong một hệ thống thật, còn phải xét yêu cầu bị lỗi, thông báo cập nhật đến muộn, và bản sao cơ sở dữ liệu chưa theo kịp. Không có một thao tác riêng lẻ bảo đảm mọi tầng luôn nhìn thấy bản mới ngay lập tức.
Vì vậy câu hỏi thiết kế nên là: loại dữ liệu này cho phép cũ trong bao lâu, và hệ thống sẽ phát hiện hoặc sửa sự lệch ấy thế nào? Với ảnh đại diện, có thể chọn một khoảng chấp nhận được rồi dùng TTL làm cơ chế sửa sai dự phòng. Với quyền truy cập, yêu cầu sẽ khác.
Chỗ nhớ có hạn, nên quên thứ gì?
Ngay cả khi xử lý được cập nhật, ta vẫn không thể giữ mọi thứ mãi mãi. Đây là lúc một câu hỏi về thiết kế trở thành bài toán thuật toán.
Hãy cho cache ba chỗ, mỗi chỗ chứa một ảnh. Các yêu cầu lần lượt là A, B, C, A, D.
Sau ba yêu cầu đầu, cả ba chỗ đã đầy. Yêu cầu A tiếp theo tìm thấy ảnh ngay. Đến D, phải bỏ một ảnh để lấy chỗ.
LRU, least recently used, bỏ thứ lâu nhất chưa được dùng. Bị hỏi gần đây là dấu hiệu cho thấy có thể sắp được hỏi tiếp. Trong ví dụ này, A vừa được dùng, nên B bị bỏ.
LFU, least frequently used, nhìn vào số lần được dùng. A đã được hỏi hai lần, B và C mỗi ảnh một lần; B và C cùng có tần suất thấp nhất. Muốn chọn giữa chúng cần thêm quy tắc phân xử. Những hệ thống thực tế có thể dùng cách đếm gần đúng và giảm dần ảnh hưởng của lịch sử cũ[3].
Hai cách đều đang đoán tương lai từ quá khứ. LRU có thể bị một đợt đọc hàng loạt đẩy mất những thứ hữu ích. LFU có thể giữ quá lâu những thứ từng được hỏi nhiều nhưng nay hết được quan tâm.
Một đợt xem lướt có thể làm bộ nhớ quên nhầm
Giữ nguyên cache ba chỗ. Buổi sáng, người dùng liên tục xem hai ảnh A và B: chuỗi yêu cầu là A, B, A, B, A, B. Cả hai đều đã được hỏi ba lần.
Buổi trưa, một tác vụ lần lượt đọc C, D, E, mỗi ảnh đúng một lần. Sau đó người dùng quay lại A, B.
Với LRU, C vào chỗ trống. D vào thì A bị bỏ vì lâu hơn B chưa được dùng. E vào thì B cũng bị bỏ. Khi người dùng quay lại, cả A và B đều phải tải lại.
Với một LFU đơn giản, A và B có tần suất cao hơn các ảnh chỉ được đọc một lần. C vào chỗ trống, rồi C nhường chỗ cho D, D nhường chỗ cho E. A và B vẫn còn khi người dùng trở lại.
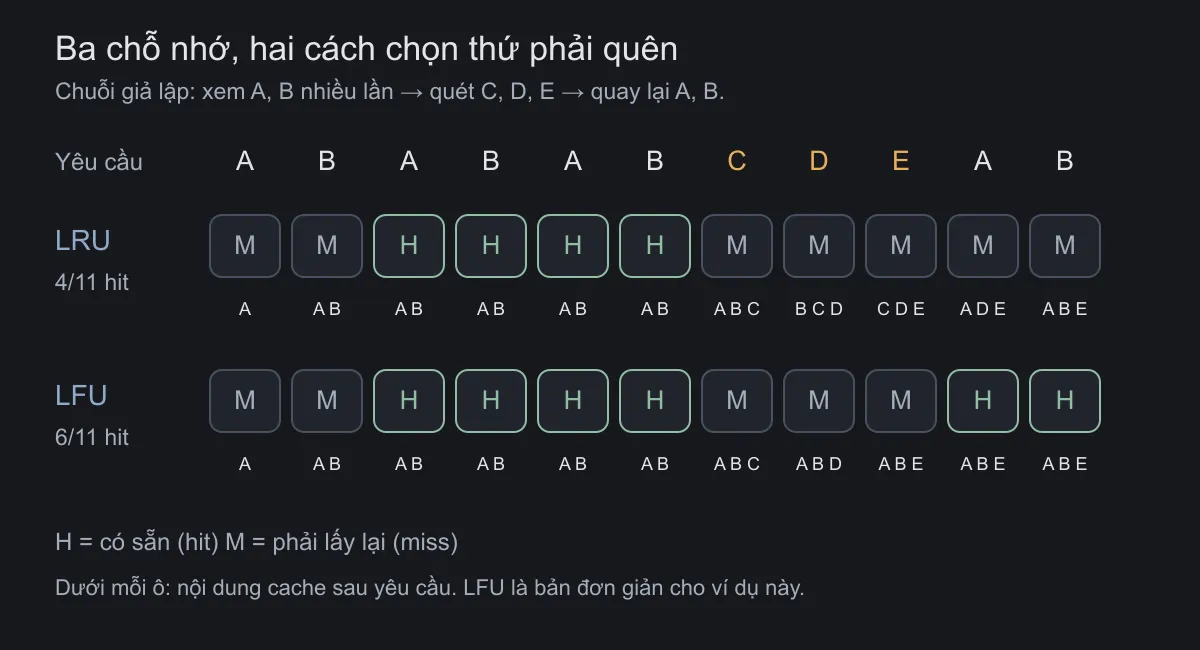
Đổi câu chuyện một chút, kết luận sẽ khác. Nếu từ buổi trưa mọi người chuyển hẳn sang D và E, việc tiếp tục ưu tiên A và B theo lịch sử buổi sáng có thể làm lãng phí chỗ. Đó là lý do bộ đếm cần có cách quên dần quá khứ, hoặc chính sách phải kết hợp nhiều tín hiệu.
Một chi tiết nữa thường bị ví dụ bằng chữ cái che đi: ảnh thật không có cùng kích thước. Giữ một ảnh rất lớn có thể chiếm chỗ của nhiều ảnh nhỏ. Tối ưu số lần hit, số byte tiết kiệm và thời gian xử lý tránh được không nhất thiết cho cùng một lựa chọn.
Chẳng hạn, một cache trả được 90 ảnh thumbnail nhưng bỏ lỡ 10 tệp rất lớn có thể có tỷ lệ hit theo số yêu cầu cao, trong khi vẫn phải truyền rất nhiều dữ liệu. Bởi vậy, “hit rate bao nhiêu?” nên đi cùng câu hỏi “hit ấy giúp tránh được việc gì?”.
Điểm dễ lẫn là bỏ để lấy chỗ — eviction — và bỏ vì không còn phù hợp — invalidation — giải quyết hai vấn đề khác nhau. Một tấm ảnh cũ vẫn được xem liên tục có thể được LRU giữ rất tốt. Thuật toán đang làm đúng nhiệm vụ giữ đồ hay được dùng, dù nội dung cần được cập nhật.
Khi mọi người cùng đến lấy một bản mới
Thử một tình huống giả định: có 1.000 yêu cầu mỗi giây hỏi cùng một nội dung. Cache trả được 99% yêu cầu, nên nguồn chỉ phải nhận khoảng 10 yêu cầu mỗi giây.
Bây giờ bản đang được hỏi nhiều nhất hết hạn. Nếu tất cả yêu cầu cùng thấy thiếu và cùng đi lấy lại, nguồn có thể đột ngột nhận một lượng việc lớn hơn nhiều so với lúc bình thường. Hiện tượng này gọi là cache stampede.
Những cách ứng phó gồm gom các yêu cầu trùng để chỉ một yêu cầu đi lấy bản mới, hoặc làm mới trước khi hết hạn. Nếu nội dung cho phép, hệ thống có thể tạm phục vụ bản cũ trong lúc cập nhật. Rải thời điểm hết hạn cũng giúp tránh nhiều mục đồng loạt cần tải lại[4].
Ở đây xuất hiện một lựa chọn rất thực tế: với ảnh đại diện, chờ thêm một chút để thấy bản mới có thể chấp nhận được. Với quyền truy cập vừa bị thu hồi, tiếp tục tin bản cũ lại có hậu quả khác. Chính sách cache cần đi cùng ý nghĩa của dữ liệu.
Ngày cache trống hoàn toàn
Còn một tình huống khác: cả cụm cache vừa được thay mới, hoặc ứng dụng vừa khởi động lại với bộ nhớ trống. Những mục thường được hỏi nhất đều chưa có. Đây là cold cache.
Quay lại ví dụ 1.000 yêu cầu mỗi giây: nguồn từng chỉ thấy khoảng 10 yêu cầu. Khi cache trống và chưa kịp được lấp, lượng việc có thể tiến gần 1.000 yêu cầu mỗi giây, tùy số nội dung trùng nhau và cách gom yêu cầu. Thêm dung lượng bộ nhớ chưa giải quyết được khoảng chuyển tiếp ấy: các chỗ trống vẫn phải được điền.
Microsoft nhấn mạnh cần xét cả tình huống cache không sẵn sàng và khả năng nguồn dữ liệu chịu lượng yêu cầu tăng lên[9]. Một hệ thống chạy tốt khi mọi thứ đã được nhớ sẵn chưa chứng minh nó khởi động lại được dưới cùng mức tải.
Có thể nạp trước những nội dung thường được hỏi, rồi chuyển người dùng sang dần. Nhưng nạp trước toàn bộ kho dữ liệu lại tốn tài nguyên và có thể chính nó gây quá tải. Chọn dữ liệu để làm nóng cũng là một bài toán về hành vi truy cập.
Gom yêu cầu trùng và giới hạn tải cũng làm hai việc khác nhau. Gom yêu cầu giúp một nghìn người cùng hỏi ảnh A chỉ cần chờ một lượt lấy ảnh A. Nếu họ hỏi một nghìn ảnh khác nhau, cơ chế ấy ít giúp ích hơn; hệ thống vẫn cần kiểm soát lượng việc cùng đi tới nguồn.
Phần kiểm soát đó nối sang bài sliding window và giới hạn yêu cầu. Cache làm giảm công việc trong điều kiện thuận lợi; giới hạn tải giúp hệ thống biết mình chấp nhận bao nhiêu việc khi điều kiện ấy không còn.
AI có thể dùng lại câu trả lời không?
Một chatbot nhận hai câu hỏi:
“Tôi đổi ảnh đại diện ở đâu?”
“Muốn thay ảnh hồ sơ thì vào mục nào?”
Hai chuỗi chữ khác nhau, nhưng có thể dùng chung một hướng dẫn. Nếu chỉ tìm theo câu chữ chính xác, cache sẽ không nhận ra cơ hội ấy.
Semantic cache, hay cache theo ý nghĩa, biến câu hỏi thành embedding rồi tìm những câu hỏi gần nó. Đây là cùng trực giác “đặt những thứ giống nhau gần nhau” trong bài tìm kiếm bằng hình ảnh. Khi tìm được mục phù hợp, hệ thống có thể dùng lại câu trả lời đã lưu, tránh gọi mô hình để tạo lại toàn bộ[5].
Nhưng hãy đổi sang hai câu này:
“Làm sao cho phép người khác xem ảnh của tôi?”
“Làm sao không cho phép người khác xem ảnh của tôi?”
Phần lớn từ ngữ giống nhau, yêu cầu lại ngược nhau. Một ngưỡng tương đồng không tự bảo đảm hai câu hỏi dùng được chung đáp án.
Còn câu “Tôi có được hoàn tiền không?” có thể giống hệt giữa hai người nhưng phụ thuộc đơn hàng, khu vực, thời điểm và chính sách áp dụng. Vì vậy cần xét ngữ cảnh, phạm vi tài khoản, phiên bản tài liệu và độ mới, bên cạnh độ gần về ý nghĩa. Câu trả lời trong một cuộc hội thoại cũng có thể phụ thuộc những lượt trao đổi trước đó[6].
Muốn dùng lại câu trả lời, hệ thống phải trả lời được câu hỏi khó hơn: những điều kiện khiến câu trả lời cũ đúng còn giữ nguyên không?
Cùng một câu, khác cuộc hội thoại
Bạn đang nhờ chatbot hướng dẫn đổi ảnh trên điện thoại. Người khác đang hỏi cách đổi ảnh trên website. Cả hai cùng gửi: “Nút đó nằm ở đâu?”
Nếu chỉ lấy câu cuối làm khóa cache, hệ thống có thể trả hướng dẫn trên điện thoại cho người đang dùng web. Câu chữ giống hệt vẫn chưa đủ, vì “nút đó” được xác định bởi những lượt trao đổi trước.
Ở đây, thêm lịch sử vào khóa có thể tránh dùng nhầm, nhưng lại làm giảm cơ hội trùng khớp. Khái quát hóa lịch sử giúp tăng tái sử dụng, song cũng có thể làm mất điều kiện quan trọng. Đây là một phần đánh đổi giữa chất lượng và tỷ lệ hit, không chỉ là chọn một con số đo độ tương đồng.
Dùng lại phần đã đọc, nhưng vẫn trả lời mới
Không phải mọi cache trong AI đều giữ đáp án cuối cùng.
Hình dung một trợ lý hỗ trợ khách hàng. Mọi yêu cầu đều bắt đầu bằng cùng một bộ hướng dẫn và tài liệu sản phẩm dài; phía sau mới là câu hỏi riêng của từng người. Nếu phần đầu giống nhau, hệ thống có thể tái sử dụng kết quả tính toán cho tiền tố ấy, rồi tiếp tục xử lý phần mới và sinh câu trả lời.
Đó là ý tưởng của prompt caching hay prefix caching. Trong mô hình Transformer, một dạng trạng thái trung gian được dùng là KV cache. Có thể hình dung nó như những ghi chú tính toán khi mô hình xử lý phần văn bản đã đọc; đây không phải một bản tóm tắt bằng chữ. Tài liệu Anthropic mô tả cơ chế khớp tiền tố và lưu trạng thái tính toán, khác với lưu câu trả lời để dùng lại[8].
| Cách tái sử dụng | Thứ được lưu | Có sinh đáp án mới cho lượt hỏi này không? |
|---|---|---|
| Cache đáp án theo khóa chính xác | Một đáp án đã tạo và các điều kiện đi kèm | Không cần, nếu được phép trả lại nguyên đáp án |
| Semantic cache | Đáp án kèm biểu diễn ý nghĩa để tìm ứng viên gần nhau | Không cần, nếu ứng viên vượt qua kiểm tra phù hợp |
| Cache tiền tố | Trạng thái tính toán cho phần đầu chung của đầu vào | Có, vẫn xử lý phần mới và sinh đáp án |
Với cache tiền tố, hai câu hỏi khác nhau vẫn có thể nhận lợi ích từ cùng bộ tài liệu đặt ở đầu. Nhưng hai bộ tài liệu chỉ gần nghĩa chưa chắc được dùng chung trạng thái: khớp tiền tố đòi hỏi điều kiện khác với tìm kiếm theo ý nghĩa. Thay đổi nội dung hoặc thứ tự ở đầu có thể làm phần dùng lại bị ngắn đi.
Cache tiền tố giúp tránh một phần công việc đọc đầu vào; nó không xóa chi phí tạo từng token đầu ra, và cũng chiếm bộ nhớ. Vì vậy, thấy một sản phẩm nói “có cache” vẫn chưa biết nó đang tiết kiệm ở bước nào.
Một liên hệ khi nhìn vào doanh nghiệp AI
Sau khi hiểu cache, câu hỏi “thêm một triệu lượt dùng thì tốn thêm bao nhiêu?” trở nên thú vị hơn.
Một sản phẩm trả lời hướng dẫn sử dụng ổn định có thể có nhiều cơ hội tái sử dụng. Một trợ lý phải đọc hồ sơ riêng và xử lý tình huống mới cho từng người lại có cấu trúc công việc khác. Cùng số lượt hỏi chưa đủ để suy ra cùng chi phí phục vụ.
Nếu nhìn dưới góc độ đầu tư, đây là một cách đặt câu hỏi về khả năng mở rộng: phần việc nào thực sự phải tính lại, phần nào có thể dùng chung, và việc tái sử dụng có giữ được chất lượng không? Đây là suy luận từ cơ chế vận hành, không phải kết luận về biên lợi nhuận của một công ty cụ thể.
Cache cũng cần bộ nhớ, bước tìm kiếm và công sức vận hành. Semantic cache có thể cần tính embedding trước khi biết có kết quả phù hợp hay không. Tỷ lệ hit cao chỉ có ý nghĩa khi phần tiết kiệm lớn hơn chi phí bổ sung và câu trả lời vẫn đáp ứng yêu cầu. AWS cũng khuyến nghị đo đồng thời hiệu quả chi phí và chất lượng[6].
Mối liên hệ ấy tiếp nối bài điện năng phía sau một prompt AI: nhìn qua giao diện để xem công việc thực sự diễn ra ở phía sau. Với cache, một phần hiệu quả đến từ những công việc đã không phải diễn ra lần nữa.
Cùng một triệu lượt hỏi, hai cấu trúc chi phí
Thử một mô hình giản lược với cache đáp án, không phải cache tiền tố. Tất cả con số sau đều giả định, không phải bảng giá của nhà cung cấp nào.
Mỗi lần tạo một đáp án mới tốn 100 đơn vị chi phí. Mỗi lượt hỏi đều tốn 2 đơn vị để tìm và kiểm tra cache. Duy trì bộ nhớ và ghi bản mới trong kỳ tính thêm một khoản 1 triệu đơn vị. Giả sử các đáp án mới có cùng chi phí và các hit đều đã qua kiểm tra chất lượng.
Khi ấy, chi phí phục vụ một triệu lượt hỏi được tính như sau:
Chi phí = 1.000.000 × [2 + (1 − tỷ lệ hit) × 100] + 1.000.000| Trường hợp giả định | Tỷ lệ hit hợp lệ | Số lượt cần tạo đáp án mới | Tổng chi phí |
|---|---|---|---|
| Không có cache | — | 1.000.000 | 100 triệu đơn vị |
| Sản phẩm A: nhiều câu hỏi lặp lại, nội dung ổn định | 80% | 200.000 | 23 triệu đơn vị |
| Sản phẩm B: nội dung riêng và thường xuyên thay đổi | 10% | 900.000 | 93 triệu đơn vị |
| Có cache nhưng không tìm được đáp án dùng lại | 0% | 1.000.000 | 103 triệu đơn vị |
Trong giả định này, cache cần tỷ lệ hit trên 3% mới rẻ hơn không dùng cache: phần tránh tạo đáp án mới phải bù được 2 triệu chi phí tra cứu và 1 triệu chi phí duy trì. Thực tế, các khoản này có thể đổi theo dung lượng, số lượt ghi và độ phức tạp của bước kiểm tra; ngưỡng 3% chỉ thuộc mô hình đang xét.
Điều đáng giữ lại không phải các con số, mà là cấu trúc câu hỏi. Một sản phẩm có thể phục vụ thêm người dùng với ít công việc tính mới hơn; sản phẩm khác cần xử lý riêng gần như mọi lượt. Khả năng dùng chung tài liệu cũng khác với khả năng dùng chung đáp án.
Khi liên hệ tới đầu tư, cơ chế này giúp kiểm tra một luận điểm về chi phí: tăng trưởng đến từ dạng yêu cầu nào, tiết kiệm có được đo trên công việc thực tế không, và người dùng có nhận đúng chất lượng đã hứa không? Biên lợi nhuận còn phụ thuộc giá bán, nhân sự, thu hút khách hàng và nhiều khoản khác. Hiểu cache giúp đọc một phần của mô hình kinh doanh, chưa đủ để suy ra toàn bộ.
Tự nhìn thấy cache trong trình duyệt
Nếu muốn thử, hãy mở một trang có ảnh trên trình duyệt máy tính rồi mở công cụ dành cho nhà phát triển, chọn tab Network. Trên nhiều trình duyệt, bạn có thể mở bằng phím F12 hoặc menu Inspect. Giữ tùy chọn Disable cache ở trạng thái không chọn trong lượt quan sát đầu.
Lọc danh sách theo ảnh, chọn một tệp rồi xem địa chỉ, mã trạng thái, dung lượng truyền và các header. Sau đó mở lại cùng trang bằng một lượt điều hướng bình thường. Tùy chính sách của trang và cách trình duyệt xử lý, bạn có thể thấy ảnh lấy từ memory cache, disk cache, một yêu cầu kiểm tra phiên bản, hoặc một lần tải nội dung mới. Không phải trang nào cũng cho ra đủ các trường hợp.
Nếu muốn tạo lượt kiểm tra khác, thử tải lại trang thông thường rồi so sánh. Thao tác tải lại có thể khiến trình duyệt kiểm tra lại các bản lưu, nên đừng mặc định mỗi lần bấm tải lại phải có một hit không dùng mạng. Nhãn hiển thị cũng tùy trình duyệt.
Hai header đáng chú ý là Cache-Control, mô tả chính sách dùng bản lưu, và ETag, dấu nhận diện giúp kiểm tra phiên bản. no-cache cho phép lưu nhưng yêu cầu kiểm tra lại trước khi dùng; no-store yêu cầu không lưu phản hồi. Tên gọi đầu tiên dễ khiến người đọc hiểu nhầm rằng cache bị cấm hoàn toàn[2].
Không thấy 304 cũng chưa chứng minh cache không hoạt động. Trình duyệt có thể dùng bản lưu mà không hỏi qua mạng, hoặc CDN trả nội dung từ cache của nó với mã 200. Bài thực hành này giúp quan sát một tầng, không mở được toàn bộ đường đi phía sau.
Trở lại chiếc ảnh chưa chịu đổi
Lần sau, khi bạn đã đổi ảnh mà người khác vẫn thấy bản cũ, có thể đâu đó một bản sao vẫn đang làm đúng điều nó được giao: giữ lại để lần tới trả nhanh hơn.
Vấn đề là thế giới đã thay đổi trước khi bản sao biết điều đó.
Từ một tấm ảnh đến câu trả lời của AI, hệ thống càng giỏi tái sử dụng, càng cần biết rõ khi nào phải ngừng tin vào thứ mình đang nhớ.
Ảnh bìa: Pandu Pratana / Unsplash, sử dụng theo Unsplash License.
Tài liệu tham khảo
- [1]HTTP caching. MDN Web Docs.
- [2]Roy Fielding, Mark Nottingham và Julian Reschke. HTTP Caching — RFC 9111. IETF, 2022.
- [3]Key eviction. Redis Documentation.
- [4]Jas Chhabra. Caching challenges and strategies. Amazon Builders’ Library, 2019.
- [5]Semantic cache. Redis Documentation.
- [6]Semantic caching best practices. Amazon ElastiCache Documentation.
- [7]Cache Consistency: Strategies to Keep Data Fresh. Redis.
- [8]Prompt caching. Anthropic Documentation.
- [9]Caching guidance. Microsoft Azure Architecture Center.