Kafka và RabbitMQ khác nhau thế nào? Bưu điện và cuốn sổ ghi
RabbitMQ giao từng lá thư rồi xóa, Kafka ghi mọi thứ vào một cuốn sổ ai cũng đọc lại được. Hai cách nghĩ khác nhau về tin nhắn, và khi nào nên chọn cái nào.
Mục lục
Bạn đặt một đơn hàng lúc nửa đêm. Trong vài giây sau cú bấm “Đặt hàng”, rất nhiều việc phải xảy ra: kho phải giữ hàng, email xác nhận phải được gửi, điểm thưởng phải được cộng, bộ phận chống gian lận phải soi đơn, bảng thống kê doanh số phải nhảy số. Nếu trang web phải tự làm hết từng việc rồi mới báo “đặt hàng thành công”, bạn sẽ ngồi nhìn vòng tròn quay rất lâu, và chỉ cần dịch vụ gửi email trục trặc là cả đơn hàng hỏng theo.
Cách các hệ thống lớn giải quyết là: trang web chỉ để lại một lời nhắn “có đơn mới, mã 1234”, rồi trả lời bạn ngay. Các dịch vụ khác tự đến lấy lời nhắn và làm phần việc của mình, nhanh hay chậm tùy sức. Thứ giữ những lời nhắn ấy gọi là message broker (người trung gian chuyển tin). Hai cái tên bạn gặp nhiều nhất là RabbitMQ và Kafka.
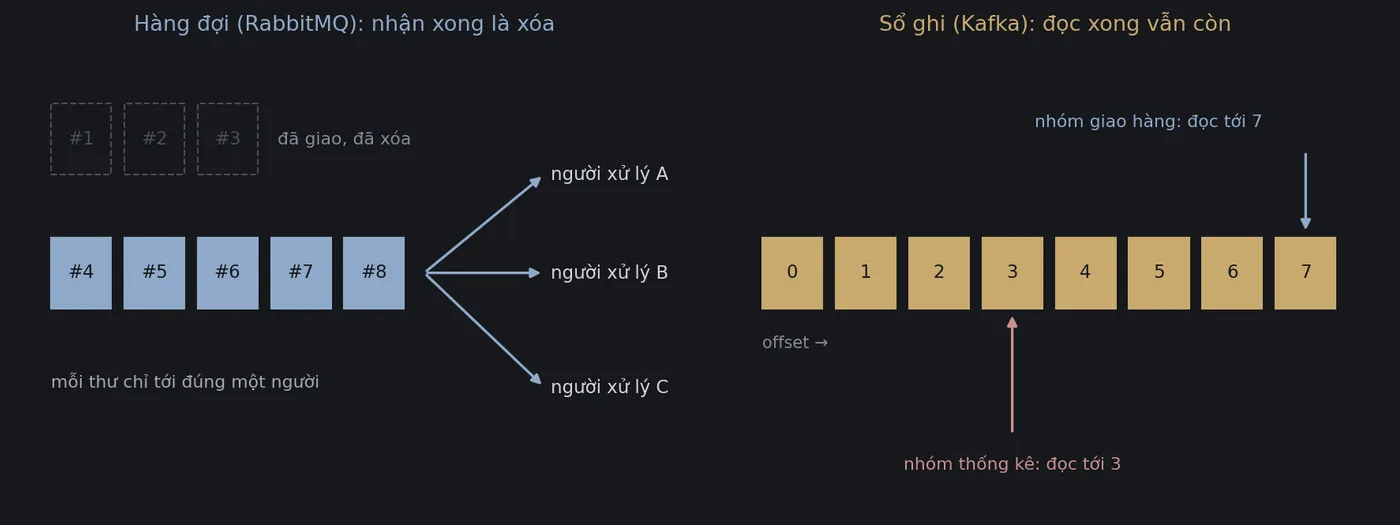
Người ta hay so hai cái này như thể chúng là hai mẫu xe cùng loại, cái nào nhanh hơn. Thật ra chúng là hai cách nghĩ khác nhau. RabbitMQ giống bưu điện: nhận thư, phân loại, giao tận tay đúng người, người nhận ký nhận xong thì thư không còn ở bưu điện nữa. Kafka giống một cuốn sổ ghi chép: mọi chuyện xảy ra đều được ghi nối tiếp vào cuối sổ, không ai xé trang nào khi đọc, và ai muốn đọc thì tự giở tới trang của mình. Bài này giải thích hai cách nghĩ ấy, chúng dẫn tới những khác biệt gì trong thực tế, và khi nào nên chọn cái nào. Cuối bài có một đoạn code nhỏ mô phỏng cả hai.
Vì sao cần một người trung gian?
Không có trung gian, dịch vụ đặt hàng phải gọi thẳng từng dịch vụ khác, như một người phải tự tay gọi điện cho kho, cho kế toán, cho người giao hàng. Cách đó có ba vấn đề:
- Chậm. Khách phải chờ việc chậm nhất xong mới được trả lời.
- Dễ đổ dây chuyền. Một dịch vụ sập là dịch vụ gọi nó cũng báo lỗi.
- Khó mở rộng. Mỗi lần thêm một dịch vụ mới cần biết về đơn hàng, lại phải sửa code dịch vụ đặt hàng để gọi thêm một chỗ.
Đặt một người trung gian ở giữa giải quyết cả ba. Người gửi (producer, người sản xuất tin nhắn) chỉ cần đưa tin cho trung gian. Người nhận (consumer, người tiêu thụ tin nhắn) lấy tin khi rảnh. Lúc cao điểm như ngày 11/11, tin nhắn dồn lại trong trung gian như khách xếp hàng trước quầy, không ai bị từ chối, các dịch vụ phía sau cứ thế xử lý dần. Dịch vụ nào tạm sập thì tin nhắn của nó nằm chờ, khi chạy lại thì làm tiếp.
Cả RabbitMQ lẫn Kafka đều làm được những việc này. Khác biệt nằm ở chỗ tin nhắn sống bao lâu và ai được đọc nó.
RabbitMQ: bưu điện giao tận tay
RabbitMQ ra đời năm 2007, viết bằng ngôn ngữ Erlang, theo một tiêu chuẩn mở về trao đổi tin nhắn tên là AMQP. Mô hình của nó có ba nhân vật chính [4]:
- Exchange (phòng phân loại thư). Producer không gửi thẳng vào hàng đợi mà gửi vào exchange, kèm một routing key (giống địa chỉ ghi trên phong bì, ví dụ
don-hang.ha-noi). - Queue (hộp thư của từng người nhận). Exchange đọc địa chỉ và bỏ thư vào đúng hộp. Có nhiều kiểu phân loại: giao đúng địa chỉ (
direct), giao theo mẫu như “mọi đơn ở Hà Nội” (topic), hoặc photo ra mỗi hộp một bản (fanout). - Consumer (người nhận thư). RabbitMQ chủ động đẩy thư tới consumer, mỗi lần không quá một số lượng đặt trước để không ai bị ngập.
Điểm cốt lõi là ký nhận (acknowledgement, thường gọi tắt là ack) [5]. Consumer xử lý xong một tin nhắn thì gửi ack, giống ký vào phiếu nhận bưu phẩm. Lúc đó RabbitMQ xóa tin nhắn khỏi hàng đợi. Nếu consumer sập giữa chừng mà chưa ký nhận, RabbitMQ đưa tin nhắn ấy cho người khác. Không tin nhắn nào bị bỏ sót, và mỗi tin nhắn chỉ được giao tới đúng một consumer của hộp thư đó.
Nhờ vậy, RabbitMQ rất hợp với kiểu việc “có một việc cần làm, ai rảnh thì làm”: gửi email, thu nhỏ ảnh vừa tải lên, xuất hóa đơn PDF. Muốn làm nhanh hơn? Thêm người nhận vào cùng một hộp thư. Mười người cùng lấy việc từ một hàng thì nhanh gần gấp mười, như mở thêm quầy thu ngân ở siêu thị.
Cái giá phải trả: thư đã giao là mất. Một dịch vụ mới thêm vào hôm nay không thể đọc lại những đơn hàng của hôm qua, vì bưu điện không giữ bản sao. Và RabbitMQ được thiết kế để hàng đợi ngắn: thư đến là giao đi ngay. Nếu tin nhắn dồn lại hàng triệu cái vì không ai lấy, đó là dấu hiệu hệ thống đang có vấn đề, không phải cách dùng bình thường.
Kafka: cuốn sổ ghi không bao giờ xé trang
Kafka ra đời ở LinkedIn khoảng năm 2010, do Jay Kreps, Neha Narkhede và Jun Rao xây dựng, công bố mã nguồn mở năm 2011 [1]. Bài toán của LinkedIn lúc ấy không phải “giao việc cho ai làm”, mà là gom một lượng khổng lồ sự kiện: mỗi lượt xem trang, mỗi cú bấm, mỗi lần tìm kiếm, rồi chuyển cho rất nhiều hệ thống khác nhau cùng dùng, từ hệ thống gợi ý tới kho dữ liệu phân tích. Jay Kreps kể rằng ông đặt tên theo nhà văn Franz Kafka vì đây là một hệ thống được tối ưu cho việc viết, và ông thích văn của Kafka.
Ý tưởng trung tâm của Kafka là log (sổ ghi) [2]: một danh sách chỉ được ghi thêm vào cuối, không sửa, không chèn giữa. Mỗi dòng có một số thứ tự gọi là offset, giống số trang của cuốn sổ. Các khái niệm còn lại xoay quanh cuốn sổ ấy [3]:
- Topic là một cuốn sổ theo chủ đề, ví dụ “đơn hàng” hoặc “lượt xem trang”.
- Partition (phân vùng). Một cuốn sổ quá dày thì một người ghi không kịp, nên Kafka chia topic thành nhiều cuốn nhỏ ghi song song, như một quầy đăng ký có sáu cuốn sổ cho sáu hàng người. Tin nhắn có cùng khóa (ví dụ cùng mã khách hàng) luôn vào cùng một cuốn, nên thứ tự các sự kiện của một khách hàng được giữ nguyên. Giữa các cuốn khác nhau thì không có thứ tự chung.
- Consumer group (nhóm người đọc). Mỗi nhóm là một ứng dụng, ví dụ “giao hàng” hoặc “thống kê”. Kafka không xóa tin nhắn khi có người đọc. Mỗi nhóm tự giữ dấu trang của mình: “tôi đã đọc tới offset 7”. Nhóm giao hàng đọc nhanh, nhóm thống kê đọc chậm, không ai ảnh hưởng ai.
- Retention (thời hạn lưu). Sổ không dày vô hạn. Mặc định Kafka giữ tin nhắn 7 ngày rồi mới xóa phần cũ, bất kể đã có ai đọc hay chưa. Có thể chỉnh thành vài giờ, vài tháng, hoặc giữ mãi mãi.
Khác biệt với bưu điện nằm ở ai chủ động. Consumer của Kafka tự đến lấy (pull): nó hỏi “cho tôi các tin từ offset 7 trở đi”. Vì dấu trang nằm trong tay người đọc, người đọc có thể lùi dấu trang để đọc lại từ hôm qua, từ tuần trước, hoặc từ đầu sổ.
Đây là điều RabbitMQ kiểu truyền thống không làm được, và cũng là lý do Kafka mạnh ở những việc như:
- Thêm dịch vụ mới mà không cần ai gửi lại dữ liệu. Đội chống gian lận viết xong dịch vụ hôm nay, cho nó đọc từ đầu sổ để học từ đơn hàng của cả tuần trước.
- Sửa lỗi rồi chạy lại. Dịch vụ thống kê tính sai suốt hai ngày vì một con bug. Sửa code, lùi dấu trang về hai ngày trước, tính lại.
- Nhiều ứng dụng cùng đọc một dòng sự kiện, mỗi ứng dụng một tốc độ, mà dữ liệu chỉ cần ghi một lần.
Cái giá của cuốn sổ: phân vùng là giới hạn
Kafka giữ thứ tự bằng một quy tắc đơn giản: trong một nhóm, mỗi phân vùng chỉ được giao cho đúng một người đọc. Hai người cùng đọc một cuốn sổ thì không ai biết ai đã xử lý dòng nào, và thứ tự sẽ loạn.
Hệ quả là số phân vùng trở thành trần của tốc độ xử lý song song. Topic có 6 phân vùng thì một nhóm tối đa có 6 người cùng làm việc; người thứ 7 trở đi ngồi chơi. Với RabbitMQ thì không có trần này: thêm người vào cùng một hàng đợi là thêm sức.
Mô phỏng ở cuối bài cho thấy rõ điều đó. Với 60.000 đơn hàng, mỗi đơn cần trung bình 10 mili giây để xử lý (một người làm được khoảng 100 đơn mỗi giây):
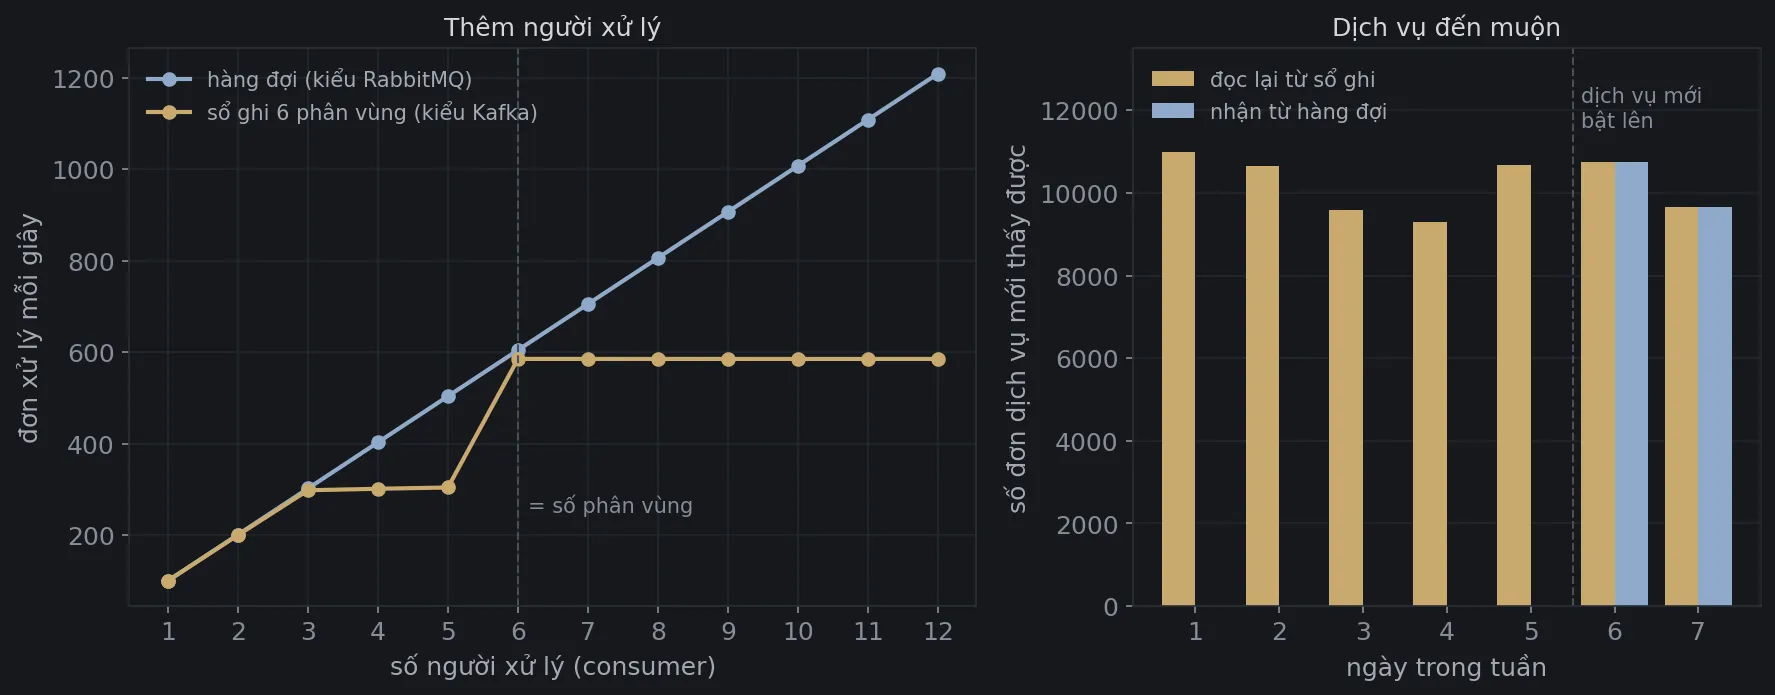
- Hàng đợi: 1 người xử lý 101 đơn mỗi giây, 6 người 605, 12 người 1.209. Tăng đều theo số người.
- Sổ ghi 6 phân vùng: tăng tới 298 đơn mỗi giây với 3 người, rồi đứng yên quanh 300 với 4 và 5 người, nhảy lên 586 khi đủ 6 người, và nằm ngang từ đó tới 12 người.
Đoạn đứng yên ở 4 và 5 người là chi tiết thú vị. Sáu phân vùng chia cho bốn người thì hai người phải ôm hai cuốn sổ, và cả nhóm chỉ nhanh bằng người chậm nhất. Phải tới 6 người, mỗi người một cuốn, mới hết cảnh ấy. Con số 586 thay vì 600 cũng có lý do: khách hàng được chia vào sáu cuốn theo mã khách, nên các cuốn không dày đều nhau, cuốn dày nhất quyết định thời gian.
Bài học thực tế: chọn số phân vùng là một quyết định quan trọng khi thiết kế với Kafka, nên chọn dư ra cho tương lai, vì tăng số phân vùng về sau sẽ làm xáo trộn việc khách hàng nào nằm ở cuốn nào. Đây cũng là bài toán chia dữ liệu cho nhiều máy mà consistent hashing giải quyết ở chỗ khác.
Bên phải hình là thế mạnh của cuốn sổ. Một dịch vụ chống gian lận bật lên vào đầu ngày thứ 6. Đọc từ sổ ghi, nó thấy đủ 71.597 đơn của cả tuần. Đăng ký nhận từ hàng đợi, nó chỉ thấy 20.407 đơn của hai ngày cuối, vì thư của năm ngày trước đã giao xong và xóa từ lâu.
So sánh nhanh
| RabbitMQ | Kafka | |
|---|---|---|
| Hình ảnh | Bưu điện giao tận tay | Cuốn sổ ghi nối tiếp |
| Tin nhắn sau khi xử lý | Xóa khi người nhận ký nhận | Giữ nguyên tới hết thời hạn lưu (mặc định 7 ngày) |
| Ai chủ động | Broker đẩy tin tới consumer | Consumer tự kéo tin về, tự giữ dấu trang |
| Đọc lại dữ liệu cũ | Không (hàng đợi kiểu truyền thống) | Có, lùi offset là được |
| Nhiều ứng dụng cùng đọc | Mỗi ứng dụng cần một hàng đợi riêng, mỗi hàng một bản sao | Ghi một lần, bao nhiêu nhóm đọc cũng được |
| Thêm người xử lý | Thêm vào hàng đợi là nhanh thêm | Tối đa bằng số phân vùng |
| Thứ tự | Theo thứ tự trong một hàng đợi, nhưng nhiều người cùng lấy thì xong không theo thứ tự | Giữ đúng thứ tự trong mỗi phân vùng |
| Định tuyến | Rất linh hoạt: theo địa chỉ, theo mẫu, phát cho tất cả | Đơn giản: chọn topic và khóa |
| Hợp nhất với | Giao việc, tác vụ chạy nền, yêu cầu – trả lời | Dòng sự kiện, nhật ký, phân tích, đồng bộ dữ liệu giữa hệ thống |
Nên chọn cái nào?
Một câu hỏi giúp phân biệt nhanh: tin nhắn của bạn là một việc cần làm, hay là một sự kiện đã xảy ra?
“Việc cần làm” như “gửi email cho khách 1234”, “thu nhỏ ảnh này”, “xuất hóa đơn đơn 5678”. Mỗi việc chỉ cần một người làm, làm xong thì thôi, không ai cần đọc lại. Đây là đất của RabbitMQ. Thêm vào đó, nếu bạn cần định tuyến phức tạp (đơn Hà Nội đi kho Hà Nội, đơn trên 10 triệu thì thêm bộ phận kiểm duyệt), cần ưu tiên tin nhắn này trước tin nhắn kia, hoặc cần hẹn giờ thử lại một việc thất bại, RabbitMQ có sẵn những công cụ đó. Nó cũng nhẹ, dễ cài, dễ hiểu cho một đội nhỏ.
“Sự kiện đã xảy ra” như “khách 1234 đã đặt đơn”, “người dùng đã xem trang này”, “số dư tài khoản đã đổi”. Sự kiện là sự thật, không ai “làm xong” một sự thật, và nhiều bên khác nhau cùng muốn biết nó: kho, kế toán, thống kê, gợi ý sản phẩm, và cả những dịch vụ năm sau mới viết. Đây là đất của Kafka. Kafka cũng là lựa chọn quen thuộc khi lượng dữ liệu rất lớn, vì ghi nối tiếp vào cuối sổ là cách ghi đĩa nhanh nhất có thể, và vì một tin nhắn được ghi một lần cho mọi người đọc.
Vài hiểu lầm thường gặp:
- “Kafka nhanh hơn RabbitMQ.” Nói vậy chưa đủ. Kafka được tối ưu để chở nhiều (lưu lượng tổng rất lớn), nhờ gom tin thành từng lô. RabbitMQ được tối ưu để giao nhanh từng tin một khi hàng đợi ngắn. Câu hỏi đúng là bạn cần chở nhiều hay cần giao nhanh, và với đa số hệ thống vừa và nhỏ, cả hai đều thừa sức.
- “Kafka đảm bảo thứ tự.” Chỉ trong từng phân vùng. Nếu thứ tự quan trọng, hãy chọn khóa sao cho những sự kiện cần đúng thứ tự (ví dụ của cùng một tài khoản) luôn vào cùng một phân vùng.
- “Có broker rồi thì không lo trùng lặp.” Cả hai đều có thể giao một tin nhắn hơn một lần: consumer xử lý xong nhưng sập trước khi kịp ký nhận hay lưu dấu trang, khi chạy lại sẽ nhận lại tin ấy. Phía xử lý vẫn phải chịu được việc nhận trùng, đúng bài toán idempotency khi chuyển tiền. Kafka có thêm cơ chế giao dịch để hạn chế trùng lặp trong một số luồng xử lý, nhưng đó không phải lý do để bỏ qua bước này.
Ranh giới giữa hai bên cũng đang mờ dần. Từ phiên bản 3.9 (2021), RabbitMQ có thêm kiểu stream: một sổ ghi nối tiếp, đọc không xóa, đọc lại được từ bất kỳ vị trí nào, rất giống Kafka [6]. Còn Kafka 4.0 (2025) đưa vào bản thử nghiệm đầu tiên của tính năng chia việc kiểu hàng đợi, cho phép nhiều người cùng lấy việc từ một phân vùng. Mỗi bên đang mượn điểm mạnh của bên kia. Nhưng cách nghĩ gốc vẫn khác nhau, và hiểu cách nghĩ ấy giúp bạn chọn đúng hơn là thuộc lòng bảng tính năng.
Trong thực tế, rất nhiều công ty dùng cả hai: Kafka làm “dòng sông sự kiện” chảy qua toàn công ty, RabbitMQ (hoặc một hàng đợi tương tự) làm “bàn giao việc” bên trong từng hệ thống.
Tự tay mô phỏng: hàng đợi và sổ ghi
Đoạn Python dưới đây dựng hai mô hình thu nhỏ: một hàng đợi kiểu RabbitMQ (lấy ra là xóa, ai rảnh thì nhận việc kế tiếp) và một sổ ghi kiểu Kafka (6 phân vùng, khách hàng được chia vào phân vùng theo mã khách, mỗi nhóm đọc tự nhớ offset). Nó chạy hai thí nghiệm: xử lý 60.000 đơn hàng với 1 đến 12 người, và một dịch vụ bật lên vào ngày thứ 6 muốn xem đơn cả tuần. Nó vẽ hình 1 và sơ đồ đầu bài. Chỉ cần cài matplotlib. Đây là mô hình để hiểu cách nghĩ, không phải phép đo tốc độ của phần mềm thật.
import heapqimport randomimport zlibfrom collections import deque
import matplotlib.pyplot as plt
plt.rcParams.update({"figure.facecolor": "#16181c", "axes.facecolor": "#16181c", "text.color": "#d4d7dc",                     "axes.edgecolor": "#2a2e35", "xtick.color": "#878d97", "ytick.color": "#878d97", "font.size": 12})random.seed(2026)
PARTITIONS = 6          # topic "đơn hàng" của Kafka chia thành 6 phân vùngN_ORDERS = 60_000       # số đơn hàng cần xử lýSERVICE_MS = 10         # mỗi đơn mất trung bình 10 ms để xử lý

class Queue:    """Kiểu RabbitMQ: thư lấy ra là mất khỏi hàng, ai rảnh thì nhận thư kế tiếp."""
    def __init__(self):        self.items = deque()
    def publish(self, msg):        self.items.append(msg)
    def get(self):        return self.items.popleft() if self.items else None   # đã nhận (ack) là xóa

class Log:    """Kiểu Kafka: sổ ghi nối tiếp, không xóa khi đọc; mỗi nhóm đọc tự nhớ mình đọc tới đâu."""
    def __init__(self, partitions):        self.parts = [[] for _ in range(partitions)]        self.offsets = {}        # (nhóm, phân vùng) → vị trí đọc tiếp theo
    def publish(self, key, msg):        self.parts[zlib.crc32(key.encode()) % len(self.parts)].append(msg)   # cùng khóa → cùng phân vùng → giữ thứ tự
    def read(self, group, p):        i = self.offsets.get((group, p), 0)        if i >= len(self.parts[p]):            return None        self.offsets[(group, p)] = i + 1        return self.parts[p][i]

orders = [(f"khach-{random.randrange(5_000)}", random.expovariate(1 / SERVICE_MS)) for _ in range(N_ORDERS)]

def queue_time(n_workers):    q = Queue()    for _, cost in orders:        q.publish(cost)    free_at = [0.0] * n_workers              # thời điểm mỗi người xử lý rảnh tay    heapq.heapify(free_at)    while (cost := q.get()) is not None:        t = heapq.heappop(free_at)           # người rảnh sớm nhất nhận đơn kế tiếp        heapq.heappush(free_at, t + cost)    return max(free_at)

def log_time(n_workers):    log = Log(PARTITIONS)    for key, cost in orders:        log.publish(key, cost)    busy = [0.0] * n_workers    for p in range(PARTITIONS):              # mỗi phân vùng chỉ giao cho MỘT người trong nhóm        w = p % n_workers        while (cost := log.read("xu-ly-don", p)) is not None:            busy[w] += cost    return max(busy)

workers = list(range(1, 13))rate_q = [N_ORDERS / queue_time(n) * 1000 for n in workers]   # đơn mỗi giâyrate_l = [N_ORDERS / log_time(n) * 1000 for n in workers]for n, a, b in zip(workers, rate_q, rate_l):    print(f"{n:>2} người xử lý   hàng đợi: {a:>5.0f} đơn/giây   sổ ghi {PARTITIONS} phân vùng: {b:>5.0f} đơn/giây")
# Một dịch vụ mới (chống gian lận) bật lên vào đầu ngày thứ 6 và muốn xem đơn của cả tuần.per_day = [random.randint(9_000, 11_000) for _ in range(7)]start_day = 5week = Log(1)for d, n in enumerate(per_day):    for _ in range(n):        week.publish("x", d)seen_log = 0while week.read("chong-gian-lan", 0) is not None:    # nhóm mới đọc từ đầu sổ (offset 0)    seen_log += 1seen_queue = sum(per_day[start_day:])                # hàng đợi: chỉ nhận đơn đến SAU khi dịch vụ đăng kýprint(f"đơn cả tuần: {sum(per_day)}   dịch vụ mới thấy qua sổ ghi: {seen_log}   qua hàng đợi: {seen_queue}")
# Hình 1: thêm người xử lý thì nhanh thêm bao nhiêu? / dịch vụ đến muộn thấy được bao nhiêu đơn?fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12, 4.8), gridspec_kw={"width_ratios": [1.35, 1]})ax1.plot(workers, rate_q, "o-", color="#8fa9c9", lw=2, label="hàng đợi (kiểu RabbitMQ)")ax1.plot(workers, rate_l, "o-", color="#c9a96e", lw=2, label=f"sổ ghi {PARTITIONS} phân vùng (kiểu Kafka)")ax1.axvline(PARTITIONS, color="#4a4e57", ls="--", lw=1)ax1.text(PARTITIONS + 0.15, 250, "= số phân vùng", color="#878d97", fontsize=10)ax1.set_xlabel("số người xử lý (consumer)", color="#a4a9b2")ax1.set_ylabel("đơn xử lý mỗi giây", color="#a4a9b2")ax1.set_title("Thêm người xử lý", color="#d4d7dc", fontsize=12)ax1.set_xticks(workers)ax1.legend(frameon=False, labelcolor="#a4a9b2", fontsize=10, loc="upper left")ax1.grid(color="#22262c")ax1.set_axisbelow(True)
days = list(range(1, 8))ax2.bar([d - 0.2 for d in days], per_day, width=0.4, color=["#c9a96e"] * 7, label="đọc lại từ sổ ghi")ax2.bar([d + 0.2 for d in days], [n if d - 1 >= start_day else 0 for d, n in zip(days, per_day)], width=0.4,        color="#8fa9c9", label="nhận từ hàng đợi")ax2.axvline(start_day + 0.5, color="#4a4e57", ls="--", lw=1)ax2.text(start_day + 0.6, 11_600, "dịch vụ mới\nbật lên", color="#878d97", fontsize=10, ha="left")ax2.set_ylim(0, 13_500)ax2.set_xticks(days)ax2.set_xlabel("ngày trong tuần", color="#a4a9b2")ax2.set_ylabel("số đơn dịch vụ mới thấy được", color="#a4a9b2")ax2.set_title("Dịch vụ đến muộn", color="#d4d7dc", fontsize=12)ax2.legend(frameon=False, labelcolor="#a4a9b2", fontsize=10, loc="upper left")ax2.grid(axis="y", color="#22262c")ax2.set_axisbelow(True)fig.tight_layout()fig.savefig("hai-mo-phong.png", dpi=150, bbox_inches="tight")
# Hình 2 (ảnh đầu bài): hàng đợi giao thư xong là xóa; sổ ghi giữ nguyên, mỗi nhóm có dấu trang riêng.fig, (a, b) = plt.subplots(1, 2, figsize=(12, 4.6))for ax in (a, b):    ax.set_xlim(0, 10)    ax.set_ylim(0, 6)    ax.axis("off")a.set_title("Hàng đợi (RabbitMQ): nhận xong là xóa", color="#8fa9c9", fontsize=13)for i in range(5):    a.add_patch(plt.Rectangle((0.6 + i * 1.1, 2.6), 0.9, 0.9, color="#8fa9c9"))    a.text(1.05 + i * 1.1, 3.05, f"#{i + 4}", ha="center", va="center", color="#16181c", fontsize=11)for i in range(3):    a.add_patch(plt.Rectangle((0.6 + i * 1.1, 4.3), 0.9, 0.9, fill=False, ec="#4a4e57", ls="--"))    a.text(1.05 + i * 1.1, 4.75, f"#{i + 1}", ha="center", va="center", color="#4a4e57", fontsize=11)a.text(4.0, 4.75, "đã giao, đã xóa", color="#878d97", fontsize=10.5, va="center")for j, (y, name) in enumerate([(4.3, "người xử lý A"), (3.05, "người xử lý B"), (1.6, "người xử lý C")]):    a.annotate("", xy=(8.0, y), xytext=(6.2, 3.05), arrowprops=dict(arrowstyle="-|>", color="#8fa9c9", lw=1.6))    a.text(8.1, y, name, va="center", color="#d4d7dc", fontsize=11)a.text(0.6, 1.6, "mỗi thư chỉ tới đúng một người", color="#a4a9b2", fontsize=10.5)
b.set_title("Sổ ghi (Kafka): đọc xong vẫn còn", color="#c9a96e", fontsize=13)for i in range(8):    b.add_patch(plt.Rectangle((0.6 + i * 1.1, 2.6), 0.9, 0.9, color="#c9a96e"))    b.text(1.05 + i * 1.1, 3.05, f"{i}", ha="center", va="center", color="#16181c", fontsize=11)b.text(0.6, 2.1, "offset →", color="#878d97", fontsize=10)for x_off, y, name, color in [(7, 4.6, "nhóm giao hàng: đọc tới 7", "#8fa9c9"), (3, 1.0, "nhóm thống kê: đọc tới 3", "#c98f8f")]:    x = 1.05 + x_off * 1.1    b.annotate("", xy=(x, 3.55 if y > 3 else 2.55), xytext=(x, y), arrowprops=dict(arrowstyle="-|>", color=color, lw=1.6))    b.text(min(x, 6.4), y + (0.3 if y > 3 else -0.45), name, ha="center", color=color, fontsize=10.5)fig.tight_layout()fig.savefig("hang-doi-va-so-ghi.png", dpi=150, bbox_inches="tight")
1 người xử lý hàng đợi: 101 đơn/giây sổ ghi 6 phân vùng: 101 đơn/giây 2 người xử lý hàng đợi: 202 đơn/giây sổ ghi 6 phân vùng: 201 đơn/giây 3 người xử lý hàng đợi: 302 đơn/giây sổ ghi 6 phân vùng: 298 đơn/giây 4 người xử lý hàng đợi: 403 đơn/giây sổ ghi 6 phân vùng: 302 đơn/giây 5 người xử lý hàng đợi: 504 đơn/giây sổ ghi 6 phân vùng: 305 đơn/giây 6 người xử lý hàng đợi: 605 đơn/giây sổ ghi 6 phân vùng: 586 đơn/giây 7 người xử lý hàng đợi: 706 đơn/giây sổ ghi 6 phân vùng: 586 đơn/giây 8 người xử lý hàng đợi: 806 đơn/giây sổ ghi 6 phân vùng: 586 đơn/giây 9 người xử lý hàng đợi: 907 đơn/giây sổ ghi 6 phân vùng: 586 đơn/giây10 người xử lý hàng đợi: 1008 đơn/giây sổ ghi 6 phân vùng: 586 đơn/giây11 người xử lý hàng đợi: 1108 đơn/giây sổ ghi 6 phân vùng: 586 đơn/giây12 người xử lý hàng đợi: 1209 đơn/giây sổ ghi 6 phân vùng: 586 đơn/giâyđơn cả tuần: 71597 dịch vụ mới thấy qua sổ ghi: 71597 qua hàng đợi: 20407Con số khớp với tính tay. Một người xử lý trung bình 10 mili giây mỗi đơn thì làm được 100 đơn mỗi giây, nên hàng đợi với người cho khoảng . Với sổ ghi, mỗi người phụ trách một số cuốn sổ, và cả nhóm xong khi người ôm nhiều việc nhất xong: 4 hoặc 5 người thì có người ôm 2 trong 6 cuốn, tức khoảng một phần ba khối việc, nên tốc độ chỉ khoảng đơn mỗi giây.
Bạn có thể đổi PARTITIONS thành 12 để thấy đường vàng bám sát đường xanh tới tận 12 người, hoặc đổi số khách hàng từ 5.000 xuống 20 để thấy các phân vùng lệch nhau rõ rệt: khi có ít khóa, vài cuốn sổ dày cộp còn vài cuốn gần như trống, và thêm người cũng không giúp được.
Hai câu hỏi khác nhau
RabbitMQ trả lời câu hỏi “việc này giao cho ai?”. Nó làm tốt nhất khi mỗi tin nhắn là một việc, giao đúng người, làm xong thì quên. Kafka trả lời câu hỏi “chuyện gì đã xảy ra?”. Nó làm tốt nhất khi mỗi tin nhắn là một sự thật, ghi lại một lần, để bao nhiêu người đọc cũng được, hôm nay hay tuần sau. Lần tới có ai hỏi nên dùng cái nào, hãy hỏi lại: hệ thống của bạn cần một bưu điện, hay một cuốn sổ?
Vẽ minh họa hình học miễn phí cho học sinh và giáo viên: EyeViz.
Tài liệu tham khảo
- [1]Jay Kreps, Neha Narkhede và Jun Rao. Kafka: a Distributed Messaging System for Log Processing. NetDB Workshop, 2011.
- [2]Jay Kreps. The Log: What every software engineer should know about real-time data's unifying abstraction. LinkedIn Engineering, 2013.
- [3]Apache Software Foundation. Apache Kafka Documentation. kafka.apache.org, 2026.
- [4]RabbitMQ. AMQP 0-9-1 Model Explained. RabbitMQ Docs, 2026.
- [5]RabbitMQ. Consumer Acknowledgements and Publisher Confirms. RabbitMQ Docs, 2026.
- [6]RabbitMQ. Streams and Super Streams. RabbitMQ Docs, 2026.