Consistent hashing: thêm máy chủ mà không xáo trộn dữ liệu
Consistent hashing là gì: vì sao chia dữ liệu bằng phép chia lấy dư làm 91% dữ liệu đổi chỗ khi thêm một máy, và vòng băm chỉ làm 9% đổi chỗ.
Mục lục
Đêm siêu sale, lượng người vào một trang mua sắm tăng gấp mười. Kỹ sư thêm máy chủ bộ nhớ đệm (cache) để gánh tải, và trang web… chậm hẳn đi. Nghe vô lý, nhưng đó là chuyện có thật nếu dữ liệu được chia cho các máy bằng cách đơn giản nhất. Consistent hashing (băm nhất quán) là kỹ thuật giải quyết đúng vấn đề này: một cách chia dữ liệu cho nhiều máy chủ sao cho khi thêm hay bớt một máy, chỉ một phần nhỏ dữ liệu phải đổi chỗ, thay vì gần như toàn bộ.
Bài này kể vì sao cách chia “thông thường” sụp đổ khi số máy thay đổi, ý tưởng vòng tròn của consistent hashing, mẹo “nút ảo” để chia tải cho đều, và những hệ thống đang dùng nó, từ Akamai tới Amazon. Cuối bài có một đoạn code để bạn tự đếm xem bao nhiêu dữ liệu phải dọn nhà.
Chia dữ liệu cho nhiều máy: cách dễ nhất
Một trang web lớn không để mọi dữ liệu trên một máy. Thông tin của hàng triệu người dùng được chia ra nhiều máy chủ, mỗi máy giữ một phần. Câu hỏi đầu tiên: dữ liệu của người dùng số 12345 nằm ở máy nào?
Cách dễ nhất: biến mã người dùng thành một con số trông như ngẫu nhiên bằng hàm băm (cùng loại “máy xay” trong bài Bloom filter), rồi chia lấy dư cho số máy. Có 10 máy thì lấy số ấy chia cho 10, dư 3 thì vào máy 3. Cách này nhanh, không cần nhớ gì, và chia khá đều.
Rắc rối đến khi số máy thay đổi. Thêm máy thứ 11, giờ phải chia cho 11 thay vì 10, và số dư của gần như mọi người dùng đều khác đi. Mô phỏng ở cuối bài với 100.000 người dùng cho thấy 91% dữ liệu phải chuyển sang máy khác chỉ vì thêm một máy.
Với bộ nhớ đệm, điều đó nghĩa là gần như mọi lần tra cứu đều trượt: máy mới được hỏi về dữ liệu mà nó chưa có, cùng lúc ấy hàng loạt yêu cầu dội thẳng xuống cơ sở dữ liệu phía sau. Thêm máy để gánh tải lại tạo ra một cơn sóng tải mới, đúng lúc hệ thống đang yếu nhất. Với dữ liệu lưu trữ thật, 91% dữ liệu phải sao chép qua mạng, có khi mất hàng giờ.
Ý tưởng vòng tròn
Năm 1997, một nhóm nghiên cứu ở MIT công bố một cách khác, trong bài báo về việc giảm tải cho những trang web bị truy cập dồn dập[1]. Hai đồng tác giả, Tom Leighton và Danny Lewin, năm sau lập ra Akamai, công ty phân phối nội dung đã nhắc tới trong bài Bloom filter.
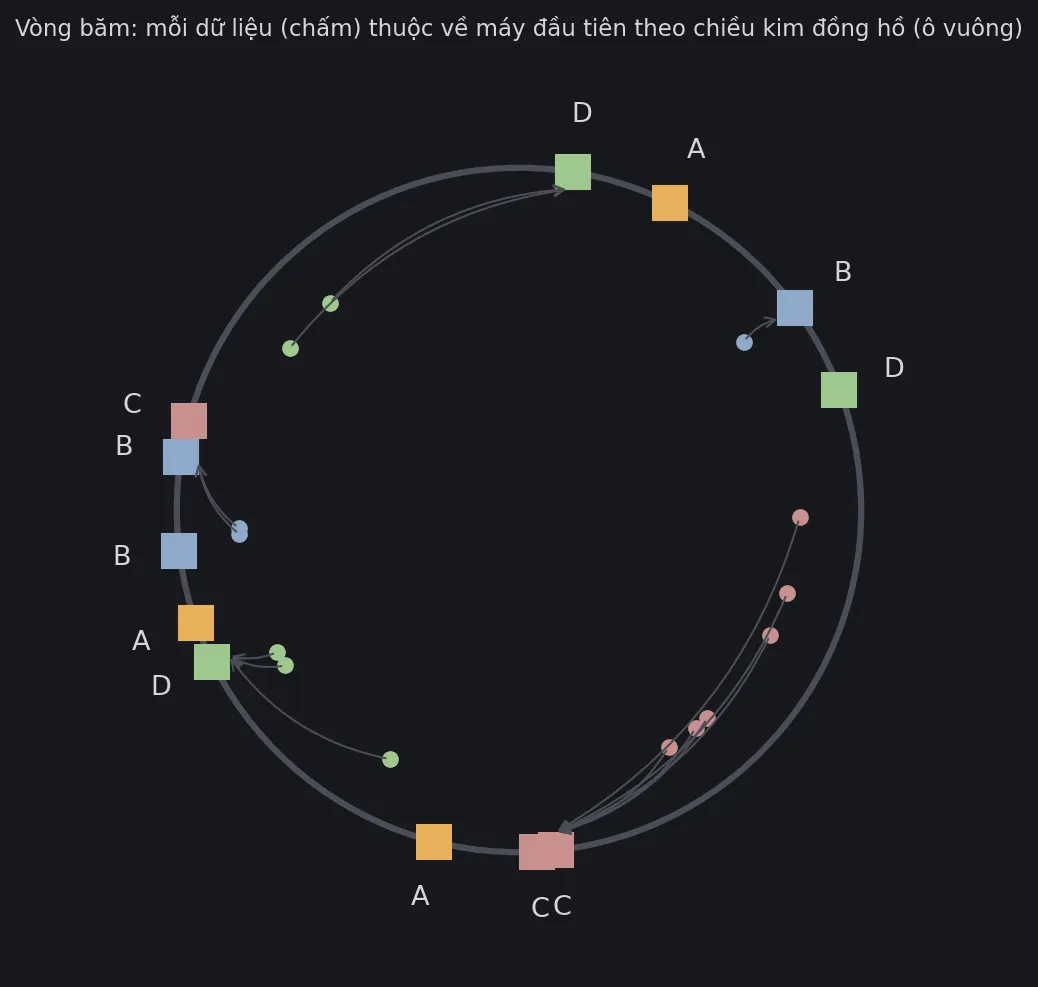
Ý tưởng như sau. Hãy uốn dãy số mà hàm băm tạo ra thành một vòng tròn, như mặt đồng hồ. Rồi:
- Đặt các máy chủ lên vòng: băm tên mỗi máy để ra một vị trí trên vòng.
- Đặt dữ liệu lên vòng: băm mã của mỗi dữ liệu để ra một vị trí.
- Quy tắc: mỗi dữ liệu thuộc về máy đầu tiên gặp được khi đi theo chiều kim đồng hồ từ vị trí của nó.
Ảnh đầu bài là một vòng như vậy: các chấm là dữ liệu, các ô vuông là máy, mỗi mũi tên chỉ tới máy giữ chấm ấy.
Giờ thêm một máy mới. Nó rơi vào một vị trí trên vòng, và chỉ “cướp” những dữ liệu nằm ngay trước nó, những dữ liệu trước đây thuộc về máy kế tiếp. Mọi dữ liệu khác giữ nguyên chỗ. Với 10 máy lên 11, chỉ khoảng 1/11, tức 9% dữ liệu đổi chỗ, đúng bằng phần máy mới phải nhận. Bớt một máy thì ngược lại: chỉ dữ liệu của máy ấy chuyển sang máy kế tiếp.
Muốn biết một dữ liệu thuộc máy nào, chỉ cần tìm vị trí máy đầu tiên lớn hơn vị trí của dữ liệu trong danh sách vị trí đã sắp xếp. Đó chính là binary search, nhanh dù có hàng nghìn máy.
Nút ảo: chia tải cho đều
Vòng tròn có một nhược điểm. Với chỉ vài máy, vị trí ngẫu nhiên của chúng trên vòng hiếm khi cách đều nhau. Máy nào đứng sau một khoảng trống lớn sẽ phải giữ rất nhiều dữ liệu. Trong mô phỏng ở cuối bài, với mỗi máy một vị trí, máy nặng nhất giữ hơn 30.000 người dùng còn máy nhẹ nhất chỉ giữ khoảng 1.300, trong khi lý tưởng là 10.000 mỗi máy.
Cách sửa là cho mỗi máy nhiều vị trí trên vòng, gọi là nút ảo (virtual node): máy A không xuất hiện một lần mà 200 lần, ở 200 chỗ rải khắp vòng. Các khoảng trống lớn nhỏ bù trừ cho nhau, nên mỗi máy nhận gần đúng phần của mình. Với 200 nút ảo mỗi máy, tải dao động trong khoảng 8.900 tới 11.300, gần mức lý tưởng hơn nhiều.
Nút ảo còn có hai lợi ích nữa. Máy mạnh hơn có thể nhận nhiều nút ảo hơn, tức gánh phần lớn hơn. Và khi một máy hỏng, dữ liệu của nó không đổ hết sang một máy hàng xóm, mà rải ra nhiều máy, vì 200 vị trí của nó có 200 hàng xóm khác nhau.
Ai đang dùng consistent hashing?
Bộ nhớ đệm và mạng phân phối nội dung. Đây là ứng dụng đầu tiên, trong bài báo năm 1997: phân chia nội dung web cho nhiều máy cache sao cho thêm bớt máy không làm cache “trắng” toàn bộ[1].
Amazon Dynamo. Năm 2007, Amazon mô tả Dynamo, kho dữ liệu đứng sau những dịch vụ cần luôn sẵn sàng như giỏ hàng. Dynamo chia dữ liệu bằng consistent hashing có nút ảo, và mỗi dữ liệu được sao lưu ở vài máy kế tiếp trên vòng, để một máy hỏng thì vẫn còn bản khác[2].
Cassandra. Cơ sở dữ liệu phân tán Cassandra, ban đầu phát triển tại Facebook, cũng xếp các máy thành một vòng và chia dữ liệu theo đúng cách ấy[3].
Những biến thể gọn hơn. Năm 2014, hai kỹ sư Google công bố jump consistent hash, một hàm chỉ vài dòng code, không cần lưu vòng tròn nào mà vẫn đảm bảo khi tăng số máy, chỉ phần dữ liệu cần thiết phải chuyển. Đổi lại, nó chỉ hợp với trường hợp máy được đánh số liên tục và chỉ thêm, bớt ở cuối danh sách[4].
Những câu hỏi khi thiết kế
- Bao nhiêu nút ảo? Nhiều nút ảo thì tải đều hơn, nhưng danh sách vị trí dài hơn và tốn bộ nhớ hơn. Vài chục tới vài trăm mỗi máy là mức thường gặp.
- Chuyển dữ liệu thế nào? Consistent hashing cho biết dữ liệu nào phải chuyển, không tự chuyển giúp. Hệ thống vẫn phải sao chép phần ấy sang máy mới trong khi vẫn phục vụ người dùng, rồi mới đổi sang vị trí mới.
- Ai giữ “bản đồ” vòng tròn? Mọi máy và mọi người gọi phải nhìn thấy cùng một vòng. Nếu hai máy chủ ứng dụng có hai phiên bản vòng khác nhau, cùng một dữ liệu sẽ được tìm ở hai nơi. Đây là cùng loại câu hỏi “dữ liệu dùng chung nằm ở đâu” như bài rate limiter và cửa sổ trượt gặp phải khi có cả trăm máy cùng đếm.
- Dữ liệu “nóng”. Consistent hashing chia đều số lượng dữ liệu, không chia đều lượng truy cập. Một sản phẩm đang được cả triệu người xem vẫn nằm trọn trên một máy. Những trường hợp như vậy cần thêm bộ nhớ đệm riêng hoặc nhân bản dữ liệu ấy ra nhiều máy.
Tự tay đếm: bao nhiêu dữ liệu phải dọn nhà?
Đoạn Python dưới đây có 100.000 khóa (mã người dùng) và 10 máy chủ, rồi thêm máy thứ 11. Nó đếm phần khóa phải chuyển sang máy khác với ba cách chia: chia lấy dư, vòng băm một vị trí mỗi máy, và vòng băm 200 nút ảo mỗi máy, đồng thời đếm mỗi máy giữ bao nhiêu khóa. Nó cũng vẽ ảnh đầu bài. Chỉ cần cài matplotlib.
import bisectimport hashlibimport math
import matplotlib.pyplot as plt
plt.rcParams.update({"figure.facecolor": "#16181c", "axes.facecolor": "#16181c", "text.color": "#d4d7dc",                     "axes.edgecolor": "#2a2e35", "xtick.color": "#878d97", "ytick.color": "#878d97", "font.size": 12})

def h(s):    """Băm một chuỗi thành số nguyên 64 bit (dùng MD5 cho dễ tái lập, không vì bảo mật)."""    return int.from_bytes(hashlib.md5(s.encode()).digest()[:8], "big")

class Ring:    """Vòng băm: mỗi máy chủ đặt `vnodes` điểm trên vòng; một khóa thuộc về điểm đầu tiên theo chiều kim đồng hồ."""
    def __init__(self, servers, vnodes=1):        self.points = sorted((h(f"{s}#{i}"), s) for s in servers for i in range(vnodes))        self.keys = [p for p, _ in self.points]
    def owner(self, key):        i = bisect.bisect(self.keys, h(key)) % len(self.keys)   # tìm điểm kế tiếp bằng binary search        return self.points[i][1]

keys = [f"user:{i}" for i in range(100_000)]before, after = [f"server-{i}" for i in range(10)], [f"server-{i}" for i in range(11)]
# Cách 1: lấy dư — máy = hash(khóa) mod số máy.moved_mod = sum(h(k) % 10 != h(k) % 11 for k in keys) / len(keys)
# Cách 2 và 3: vòng băm, 1 điểm hoặc 200 điểm (nút ảo) cho mỗi máy.stats = {}for v in (1, 200):    r10, r11 = Ring(before, v), Ring(after, v)    owners10 = [r10.owner(k) for k in keys]    moved = sum(a != r11.owner(k) for a, k in zip(owners10, keys)) / len(keys)    load = [owners10.count(s) for s in before]    stats[v] = (moved, min(load), max(load))
print(f"thêm máy thứ 11 — lấy dư: {moved_mod:.1%} khóa phải chuyển chỗ")for v, (moved, lo, hi) in stats.items():    vn = lambda n: f"{n:,}".replace(",", ".")                 # viết số kiểu Việt: 10.000    print(f"thêm máy thứ 11 — vòng băm, {v:>3} điểm/máy: {moved:.1%} khóa chuyển chỗ; "          f"10 máy giữ từ {vn(lo)} tới {vn(hi)} khóa (lý tưởng 10.000)")print(f"lý thuyết: lấy dư chuyển ~{1 - 1 / 11:.1%}, vòng băm chuyển ~{1 / 11:.1%}")
# Hình 1: phần khóa phải chuyển, và độ lệch tải giữa các máy.fig, (a1, a2) = plt.subplots(1, 2, figsize=(11, 4.6))names = ["lấy dư", "vòng băm\n1 điểm/máy", "vòng băm\n200 điểm/máy"]moved = [moved_mod, stats[1][0], stats[200][0]]a1.bar(names, [100 * m for m in moved], color=["#c98f8f", "#8fa9c9", "#e8b05a"])for i, m in enumerate(moved):    a1.text(i, 100 * m + 2, f"{m:.0%}", ha="center", color="#d4d7dc")a1.set_ylim(0, 105)a1.set_ylabel("% khóa phải chuyển sang máy khác", color="#a4a9b2")a1.set_title("Thêm máy thứ 11 vào 10 máy", color="#d4d7dc", fontsize=12)for i, v in enumerate((1, 200)):    _, lo, hi = stats[v]    a2.plot([i, i], [lo, hi], color=["#8fa9c9", "#e8b05a"][i], lw=10, solid_capstyle="butt")    a2.text(i + 0.12, hi, f"{hi:,}".replace(",", "."), color="#d4d7dc", va="center", fontsize=10)    a2.text(i + 0.12, lo, f"{lo:,}".replace(",", "."), color="#d4d7dc", va="center", fontsize=10)a2.axhline(10_000, color="#878d97", ls="--", lw=1)a2.text(-0.45, 10_400, "lý tưởng", color="#878d97", fontsize=10, ha="left")a2.set_xticks([0, 1], names[1:])a2.set_xlim(-0.5, 1.6)a2.set_ylabel("số khóa mỗi máy giữ (ít nhất → nhiều nhất)", color="#a4a9b2")a2.set_title("Tải giữa 10 máy có đều không?", color="#d4d7dc", fontsize=12)for ax in (a1, a2):    ax.grid(axis="y", color="#22262c")    ax.set_axisbelow(True)fig.tight_layout()fig.savefig("chuyen-cho-va-tai.png", dpi=150, bbox_inches="tight")
# Hình bìa: vòng băm với 4 máy, mỗi máy 3 điểm; vài khóa và mũi tên tới máy giữ nó.colors = ["#e8b05a", "#8fa9c9", "#c98f8f", "#9fc98f"]ring4 = Ring([f"máy {c}" for c in "ABCD"], 3)fig, ax = plt.subplots(figsize=(8, 8))ax.add_patch(plt.Circle((0, 0), 1, fill=False, color="#4a4e57", lw=3))pos = lambda x: (math.sin(2 * math.pi * x / 2**64), math.cos(2 * math.pi * x / 2**64))for p, s in ring4.points:    x, y = pos(p)    ax.plot(x, y, "s", ms=16, color=colors["ABCD".index(s[-1])], zorder=3)    ax.text(1.17 * x, 1.17 * y, s[-1], ha="center", va="center", color="#d4d7dc", fontsize=13)for k in [f"ảnh:{i}" for i in range(14)]:    kx, ky = pos(h(k))    owner = ring4.owner(k)    i = bisect.bisect(ring4.keys, h(k)) % len(ring4.keys)    ox, oy = pos(ring4.points[i][0])    ax.plot(kx * 0.82, ky * 0.82, "o", ms=7, color=colors["ABCD".index(owner[-1])])    ax.annotate("", xy=(ox * 0.95, oy * 0.95), xytext=(kx * 0.82, ky * 0.82),                arrowprops=dict(arrowstyle="->", color="#4a4e57", lw=1, connectionstyle="arc3,rad=-0.2"))ax.set_xlim(-1.35, 1.35); ax.set_ylim(-1.35, 1.35); ax.set_aspect("equal"); ax.axis("off")ax.set_title("Vòng băm: mỗi dữ liệu (chấm) thuộc về máy đầu tiên theo chiều kim đồng hồ (ô vuông)",             color="#d4d7dc", fontsize=11)fig.savefig("vong-bam.png", dpi=150, bbox_inches="tight")
thêm máy thứ 11 — lấy dư: 90.7% khóa phải chuyển chỗthêm máy thứ 11 — vòng băm, 1 điểm/máy: 7.9% khóa chuyển chỗ; 10 máy giữ từ 1.291 tới 30.515 khóa (lý tưởng 10.000)thêm máy thứ 11 — vòng băm, 200 điểm/máy: 10.3% khóa chuyển chỗ; 10 máy giữ từ 8.912 tới 11.300 khóa (lý tưởng 10.000)lý thuyết: lấy dư chuyển ~90.9%, vòng băm chuyển ~9.1%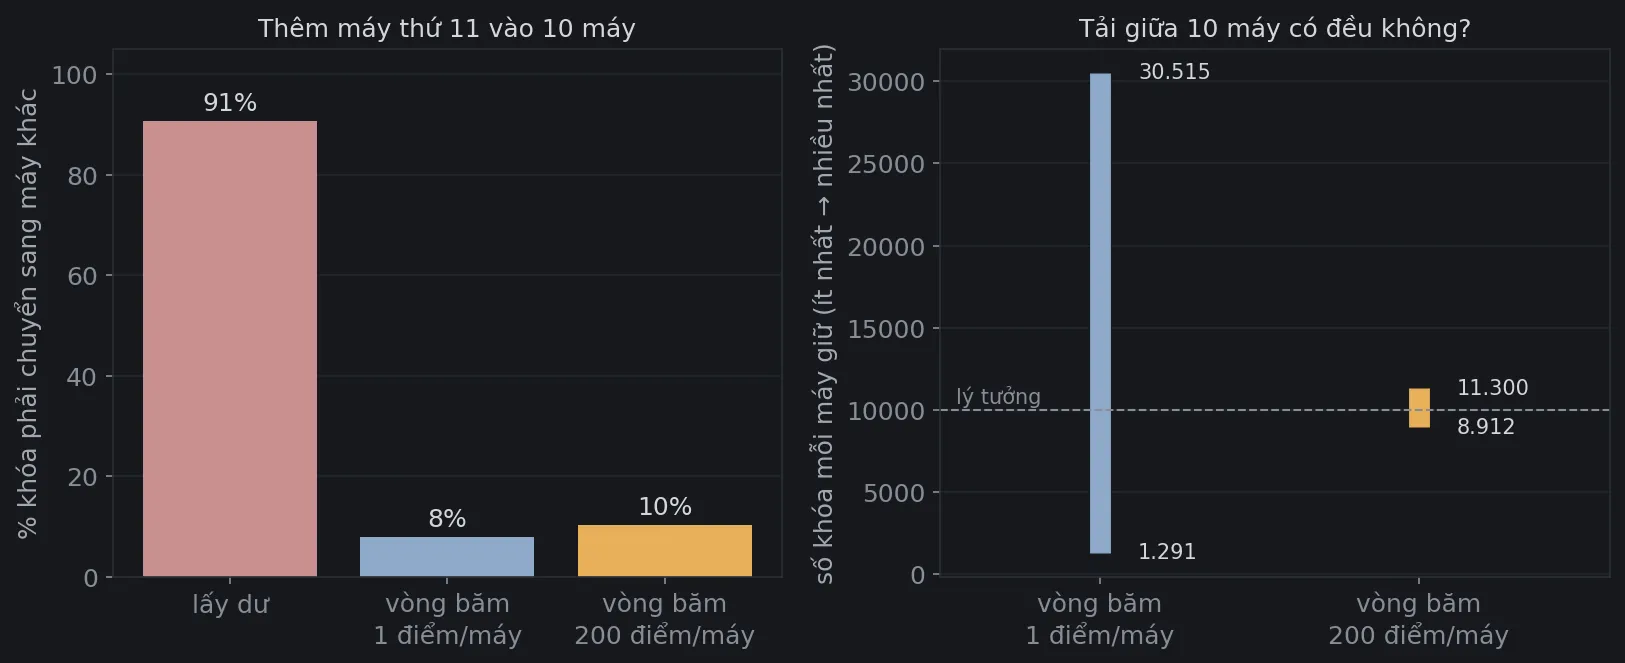
Kết quả khớp với lý thuyết: chia lấy dư làm khoảng 10/11 dữ liệu đổi chỗ, vòng băm chỉ khoảng 1/11. Con số 7,9% và 10,3% lệch quanh 9,1% vì vị trí của máy mới trên vòng là ngẫu nhiên: nó có thể rơi vào một khoảng hẹp hay rộng. Với nút ảo, phần chuyển chỗ vẫn nhỏ, còn tải giữa các máy thì đều hơn hẳn.
Bạn có thể đổi 200 thành 20 hay 1000 để thấy tải đều dần lên khi số nút ảo tăng, hoặc thêm một dòng bỏ bớt một máy để thấy dữ liệu của nó rải ra cho những máy nào.
Chỉ dọn phần cần dọn
Consistent hashing không làm việc chia dữ liệu nhanh hơn. Nó làm cho việc thay đổi rẻ đi: thêm máy, bớt máy, máy hỏng, những chuyện xảy ra hằng ngày trong một hệ thống lớn, chỉ động tới đúng phần dữ liệu liên quan. Đó là một thói quen thiết kế đáng nhớ, không chỉ cho máy chủ: khi chọn cách chia việc, hãy hỏi không chỉ “chia thế này có đều không”, mà cả “khi có thêm một người, bao nhiêu việc phải chia lại từ đầu?”.
Vẽ minh họa hình học miễn phí cho học sinh và giáo viên: EyeViz.
Tài liệu tham khảo
- [1]David Karger, Eric Lehman, Tom Leighton, Rina Panigrahy, Matthew Levine và Daniel Lewin. Consistent hashing and random trees: distributed caching protocols for relieving hot spots on the World Wide Web. STOC ’97, 1997.
- [2]Giuseppe DeCandia và cộng sự. Dynamo: Amazon’s Highly Available Key-value Store. SOSP ’07, 2007.
- [3]Avinash Lakshman và Prashant Malik. Cassandra: a decentralized structured storage system. ACM SIGOPS Operating Systems Review, 44(2), 2010.
- [4]John Lamping và Eric Veach. A Fast, Minimal Memory, Consistent Hash Algorithm. arXiv (Google), 2014.