147 điểm 10 Toán: thống kê phát hiện gian lận thế nào?
Vụ 147 điểm 10 Toán ở Tuyên Quang lộ ra từ bảng điểm. Phổ điểm, luật Benford (đếm số 1) và chữ số cuối giúp phát hiện gian lận ra sao, và khi nào báo nhầm.
Bài này hiện chỉ có bản tiếng Việt.
Mục lục
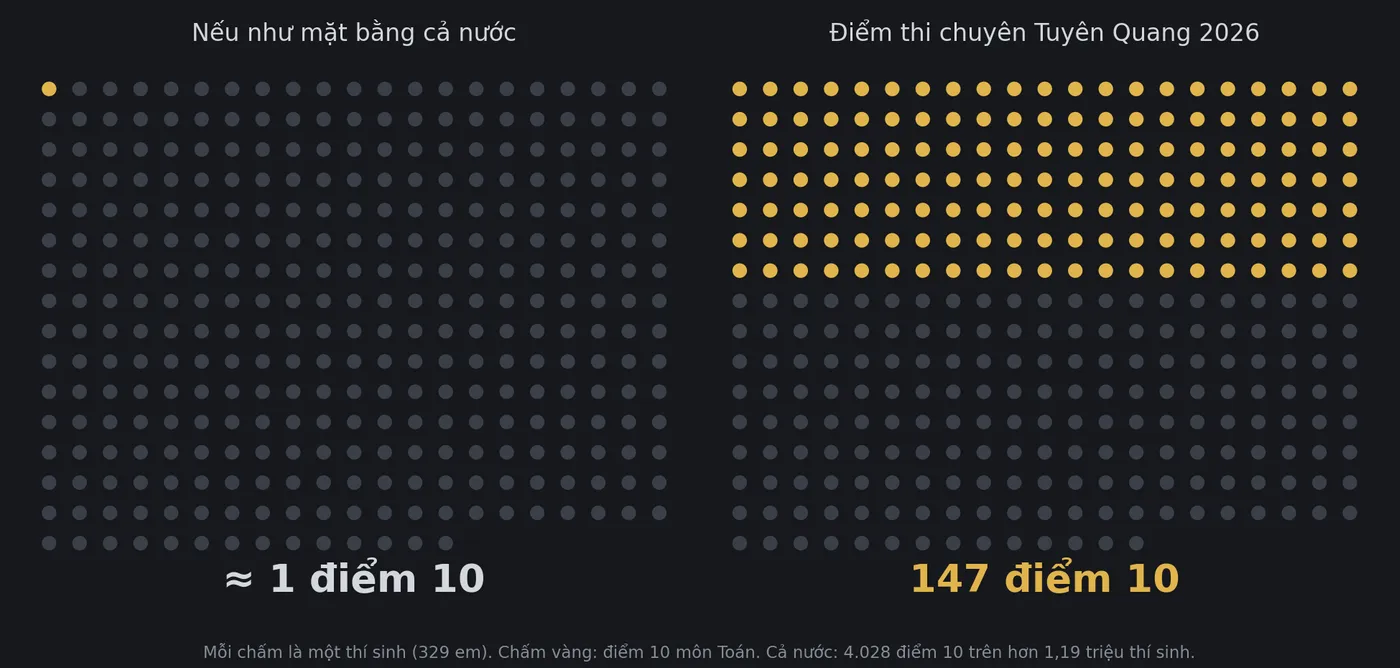
Sáng 1/7/2026, Bộ GD&ĐT công bố điểm thi tốt nghiệp THPT. Cả nước có 4.028 bài Toán đạt điểm 10 [1], trên hơn 1,19 triệu thí sinh [2]. Chỉ hai ngày sau, một con số khác lên mặt báo: riêng điểm thi Trường THPT chuyên Tuyên Quang, 329 thí sinh, có 147 điểm 10 môn Toán, điểm trung bình 9,58. Cả tỉnh có 154 điểm 10, nghĩa là hơn 95% dồn vào một điểm thi [1].
Không ai cần quay phim phòng thi để thấy điều bất thường. Chính bảng điểm đã lên tiếng. Báo Dân Trí nhận xét: dấu hiệu được nhận ra từ phân tích dữ liệu điểm, không phải từ đơn tố cáo hay hình ảnh trong phòng thi [3].
Vậy thống kê phát hiện gian lận bằng cách nào? Câu trả lời ngắn: số liệu thật luôn có một “hình dạng” quen thuộc. Điểm của một đám đông xếp thành một ngọn đồi. Số tiền trên hóa đơn bắt đầu bằng chữ số 1 nhiều hơn hẳn chữ số 9. Chữ số cuối của một con số đếm thật thì chia đều cho 0 đến 9. Người sửa số liệu thường không biết những quy luật này, nên vô tình phá vỡ chúng. Thống kê chỉ ra chỗ nào lệch khỏi hình dạng ấy. Nó không kết tội ai, nhưng chỉ cho người điều tra biết phải nhìn vào đâu.
Bài này đi từ vụ việc có thật, tới ba công cụ (phổ điểm, đếm chữ số đầu, đếm chữ số cuối), tới những lần thống kê báo nhầm, rồi thử chính các công cụ ấy trên dữ liệu cổ phiếu VN30.
147 điểm 10: bảng điểm tự lên tiếng
Hãy hình dung 329 thí sinh như 329 người xếp hàng. Nếu họ giỏi Toán ngang mặt bằng cả nước, cứ khoảng 300 người mới có một điểm 10 (4.028 trên 1,19 triệu, tức 0,34%). Trong 329 người, ta chờ đợi khoảng 1 điểm 10. Nếu họ ngang mặt bằng tỉnh Tuyên Quang (154 điểm 10 trên 17.589 thí sinh [1]), con số chờ đợi là khoảng 3. Thực tế là 147.
Dĩ nhiên đây là trường chuyên, học sinh giỏi hơn mặt bằng nhiều. Vậy hãy rộng tay hết mức: giả sử mỗi em có tới 30% cơ hội đạt điểm 10. Mức này cao gần gấp 2,5 lần một dải số báo danh toàn học sinh giỏi ở Lào Cai cùng năm, nơi có 43 điểm 10 trên 346 thí sinh, tức 12,4% [8]. Ngay cả khi ấy, xác suất để 329 em làm bài độc lập mà có từ 147 điểm 10 trở lên vẫn chỉ vào khoảng 1 phần 70 triệu. Với mức 12,4% như Lào Cai, xác suất ấy nhỏ tới mức có 46 chữ số 0 đứng ngay sau dấu phẩy.
Phép tính trên có một giả định quan trọng: các em làm bài độc lập với nhau. Thực tế, học sinh cùng lớp, cùng thầy thì điểm có liên quan với nhau, nên con số thật không cực đoan đến vậy. Nhưng khoảng cách quá lớn. Không cần tin từng chữ số của xác suất cũng thấy kết quả này rất khó xảy ra một cách tự nhiên.
Diễn biến sau đó diễn ra rất nhanh. Ngày 7/7, cơ quan công an khởi tố vụ án. Tới ngày 1/10/2026, số bị can đã lên 41 người, trong đó có Giám đốc Sở GD&ĐT tỉnh [4]. Bộ GD&ĐT hủy kết quả tại điểm thi này và tổ chức thi lại toàn bộ các môn vào giữa tháng 8.
Kết quả thi lại là phần đáng chú ý nhất với người làm thống kê. Trong 326 thí sinh thi lại môn Toán, không có điểm 10 nào. Điểm cao nhất là 9,5, điểm trung bình 6,24, tức thấp hơn lần đầu 3,34 điểm, và có 58 em dưới 5 điểm [5] [6]. Cùng các em ấy, chỉ khác điều kiện phòng thi, con số quay về một hình dạng rất bình thường.
| Điểm thi chuyên Tuyên Quang | Lần 1 (đã hủy) | Thi lại |
|---|---|---|
| Số điểm 10 môn Toán | 147 | 0 |
| Điểm trung bình môn Toán | 9,58 | 6,24 |
Việt Nam từng gặp chuyện tương tự. Năm 2018, Hà Giang, một tỉnh miền núi không nổi bật về thành tích, bất ngờ dẫn đầu cả nước về số thí sinh điểm cao ở nhiều tổ hợp. Điều tra sau đó xác định 330 bài thi trắc nghiệm của 114 thí sinh đã bị can thiệp: người ta tẩy đáp án sai, tô lại đáp án đúng trước khi đưa phiếu vào máy chấm [7]. Hai vụ cách nhau tám năm, cách làm khác nhau, nhưng đều lộ ra theo cùng một cách: những con số không giống con số thật.
Phổ điểm: đám đông nào cũng có hình dạng
Phổ điểm là biểu đồ đếm xem có bao nhiêu thí sinh ở mỗi mức điểm. Nó giống như xếp tất cả học sinh một trường theo chiều cao: đa số đứng ở khoảng giữa, càng cao hay càng thấp càng ít người. Kết quả là một ngọn đồi. Với hơn một triệu thí sinh, ngọn đồi điểm Toán năm 2026 có đỉnh quanh điểm trung bình 5,65 [2]. Điểm 10 nằm ở đuôi bên phải, mỏng như vài người cao trên 1m90 trong sân trường.
Khi một nhóm nhỏ bị nâng điểm, ngọn đồi của nhóm ấy biến dạng theo những cách rất dễ nhận ra:
- Đuôi phình to. Một nhóm bình thường không thể có gần một nửa số người ở đuôi. Nó giống như một lớp học có 147 bạn cao trên 1m90.
- Dồn cục theo số báo danh. 147 điểm 10 của Tuyên Quang nằm gọn trong một dải số báo danh liên tiếp [3]. Thí sinh ngồi cạnh nhau, cùng phòng, có chung giám thị. Gian lận cũng xảy ra theo phòng, nên dấu vết của nó dồn lại một chỗ thay vì rải đều.
- Nhảy vọt so với chính mình. Hiệu trưởng trường cho biết trong các lần thi thử, học sinh chưa đạt kết quả cao như kỳ thi chính thức [1]. Bình thường, nhóm đứng đầu ở một bài kiểm tra thường tụt bớt ở bài sau. Đây là hiện tượng hồi quy về trung bình, giống như người ném phạt trúng 10/10 hôm nay thì hôm sau thường trúng ít hơn. Cả một nhóm lớn cùng nhảy vọt lên đỉnh là đi ngược quy luật ấy.
Không dấu hiệu nào ở trên là bằng chứng. Nhưng khi cả ba cùng xuất hiện ở một chỗ, chỗ đó đáng được kiểm tra trước.
Khi nào thống kê báo nhầm?
Sau vụ Tuyên Quang, mạng xã hội rộ lên những bảng phân tích về các tỉnh khác. Một số đúng, nhưng nhiều trường hợp hóa ra là báo nhầm.
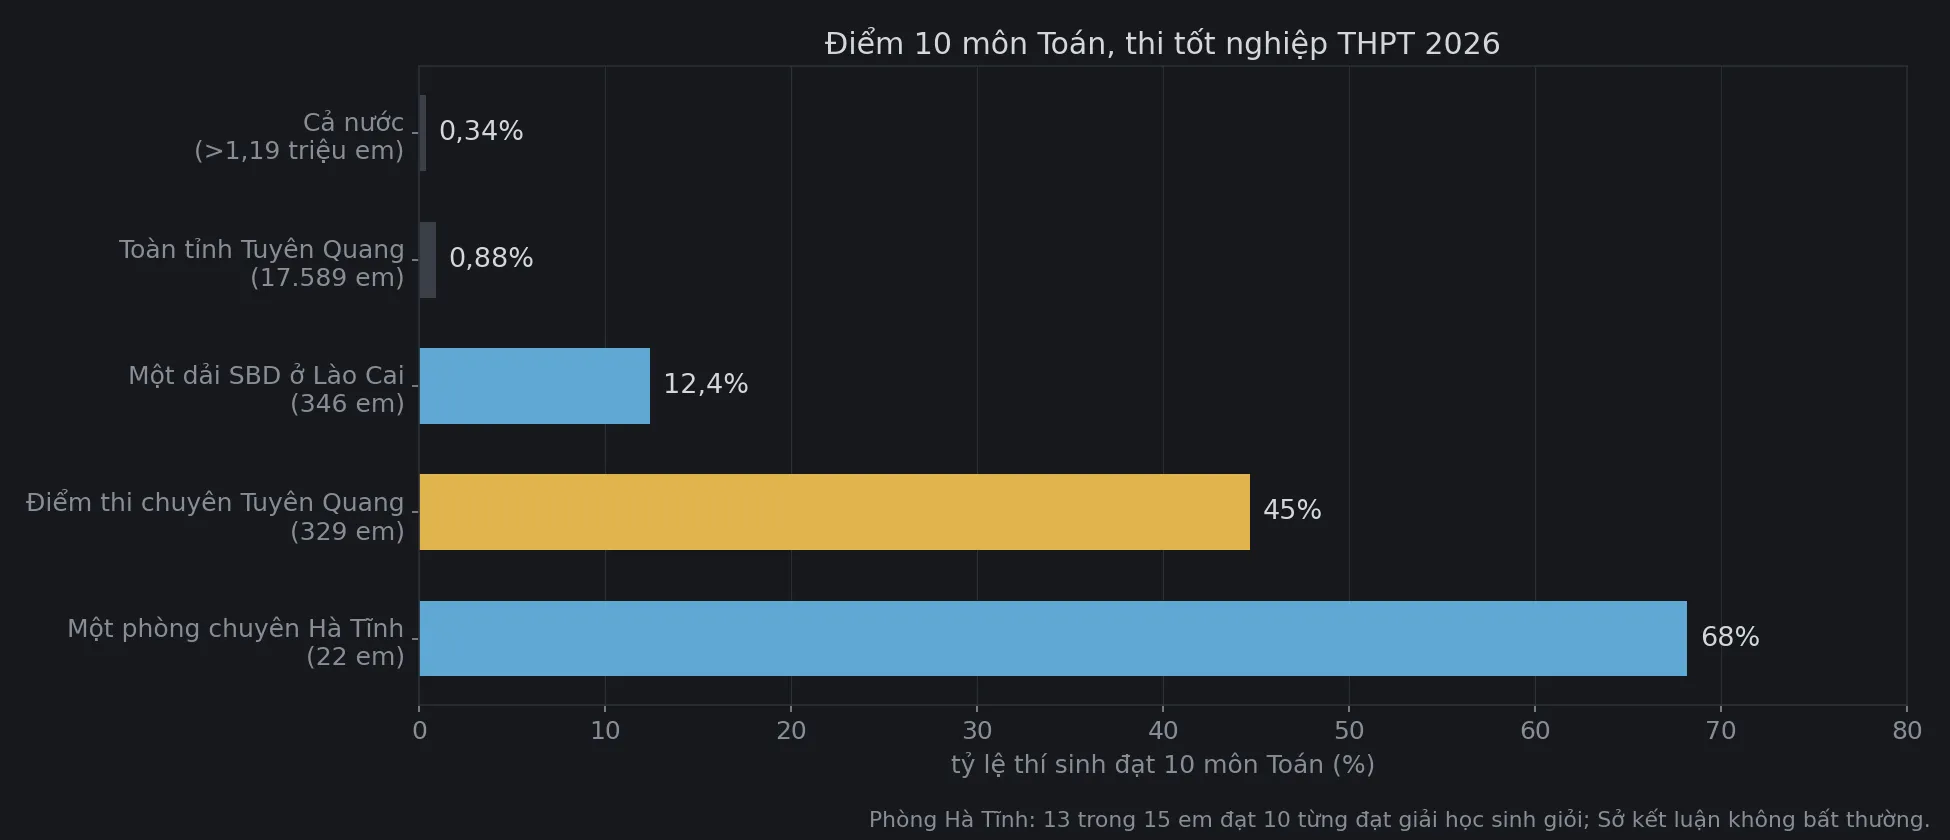
Nhìn Hình 1, tỷ lệ điểm 10 cao nhất không phải ở Tuyên Quang mà ở một phòng thi của trường chuyên Hà Tĩnh: 15 trên 22 em đạt điểm 10. Sở GD&ĐT Hà Tĩnh cho biết 13 em trong số đó từng đạt giải học sinh giỏi tỉnh, hai em có giải quốc gia, và kết luận không có bất thường [9]. Ở Lào Cai, dải 346 số báo danh có 43 điểm 10 được Sở giải thích là “100% đều là học sinh giỏi”. Sở đã đối chiếu kết quả học tập ba năm của các em và chưa ghi nhận dấu hiệu bất thường [8]. Ở Nghệ An, một phòng thi có 13 điểm 10 cũng được Sở kết luận là không có bất thường [10].
Có ba lý do khiến thống kê báo nhầm:
- So sai đối tượng. So một phòng trường chuyên với mặt bằng cả nước thì phòng nào cũng “bất thường”. Giống như thấy cả đội bóng rổ đều cao trên 1m90 rồi kết luận có gì đó mờ ám. Phải so với nhóm cùng loại: trường chuyên với trường chuyên, lớp có giải học sinh giỏi với lớp có giải học sinh giỏi.
- Nhóm quá nhỏ. Với 22 em, chỉ cần vài em xuất sắc ngồi chung một phòng là tỷ lệ đã nhảy rất xa. Điểm khác biệt của Tuyên Quang là quy mô: 329 em, gần gấp 15 lần một phòng thi. Nhóm càng lớn, may rủi càng bị triệt tiêu, nên độ lệch càng có ý nghĩa.
- Soi quá nhiều chỗ. Cả nước có hàng chục nghìn phòng thi. Chỉ do ngẫu nhiên thôi, chắc chắn sẽ có vài phòng trông cực đoan. Đây chính là bài học của nghịch lý ngày sinh nhật: soi đủ nhiều cặp thì thế nào cũng thấy trùng hợp. Vì vậy, một phòng lạ trong hàng chục nghìn phòng đáng ít chú ý hơn nhiều so với một phòng lạ ở nơi ta đã nghi ngờ từ trước.
Hãy nghĩ thống kê như máy dò kim loại ở sân bay. Máy kêu thì nhân viên kiểm tra kỹ hơn, chứ không bắt ngay hành khách. Thắt lưng, đồng hồ cũng làm máy kêu. Điều quyết định là bước kiểm tra tiếp theo: học bạ, điểm thi thử, giải học sinh giỏi, bài thi gốc, camera, lời khai. Ở Tuyên Quang, mọi bước kiểm tra ấy đều đi cùng một hướng, và kỳ thi lại cho kết quả rõ ràng.
Đếm các số 1: luật Benford là gì?
Phổ điểm hữu ích với điểm thi. Với tiền bạc, có một công cụ gây bất ngờ hơn nhiều: đếm xem có bao nhiêu con số bắt đầu bằng chữ số 1.
Bạn hãy thử lấy một xấp hóa đơn điện, một bảng giá nhà, hay dân số các xã trong tỉnh, rồi chỉ nhìn chữ số đầu tiên của mỗi con số. Trực giác bảo rằng chữ số 1 đến 9 sẽ chia đều, mỗi chữ số khoảng 11%. Thực tế không phải vậy. Khoảng 30% con số bắt đầu bằng 1, và chỉ chưa tới 5% bắt đầu bằng 9.
Người đầu tiên để ý chuyện này là nhà thiên văn Simon Newcomb, năm 1881. Thời ấy người ta tra bảng logarit in thành sách, và Newcomb thấy những trang đầu, nơi các số bắt đầu bằng 1, mòn và bẩn hơn hẳn những trang cuối [11]. Năm 1938, kỹ sư Frank Benford kiểm tra lại trên 20.229 con số từ 20 nguồn rất khác nhau: diện tích sông hồ, dân số, hằng số vật lý, số nhà trong danh bạ… Quy luật vẫn đúng [12]. Từ đó nó mang tên ông: luật Benford.
Vì sao lại thế? Hãy nghĩ tới một sổ tiết kiệm 100 triệu đồng, lãi 7% mỗi năm. Muốn số dư đổi chữ số đầu từ 1 sang 2, tức từ 100 lên 200 triệu, số tiền phải tăng gấp đôi, mất khoảng 10 năm. Còn từ 900 triệu lên 1 tỷ chỉ cần tăng 11%, tức khoảng một năm rưỡi. Số dư cứ thế “ngồi lâu” ở chữ số 1 và đi rất nhanh qua chữ số 9. Những đại lượng lớn lên theo phần trăm, như tiền, dân số, doanh thu hay khối lượng giao dịch, đều có tính chất này [13].
Viết thành công thức, tỷ lệ con số bắt đầu bằng chữ số là:
| Chữ số đầu | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 |
|---|---|---|---|---|---|---|---|---|---|
| Tỷ lệ | 30,1% | 17,6% | 12,5% | 9,7% | 7,9% | 6,7% | 5,8% | 5,1% | 4,6% |
Luật này không đúng với mọi loại số, và đây là điều quan trọng nhất cần nhớ. Nó chỉ áp dụng cho dữ liệu trải dài qua nhiều bậc độ lớn (từ hàng chục tới hàng triệu) và không bị chặn trên hay chặn dưới. Số báo danh, số điện thoại, số tài khoản là số được gán, nên không tuân theo luật này [13]. Điểm thi cũng vậy: điểm bị kẹp trong khoảng 0 đến 10, nên không thể “đếm số 1” trên điểm thi. Với điểm thi, ta dùng phổ điểm như ở trên. Luật Benford dành cho tiền.
Ai đã bị phát hiện nhờ đếm chữ số?
Bang Arizona, Mỹ, năm 1993. Một quản lý trong văn phòng Thủ quỹ bang chuyển tiền cho một nhà cung cấp không có thật, tổng cộng gần 2 triệu USD, qua 23 tấm séc. Nhà kế toán Mark Nigrini phân tích lại và thấy hơn 90% số tiền bắt đầu bằng 7, 8 hoặc 9, gần như ngược hẳn luật Benford. Lý do là hầu hết các tấm séc đều ở ngay dưới mức 100.000 USD, ngưỡng mà nếu vượt qua sẽ phải qua thêm một lớp kiểm soát [13]. Người gian lận né một quy tắc, và vô tình để lại một dấu vết khác. Giống như học sinh sửa điểm 4,8 thành 5,0 cho “vừa đủ đỗ”: một bảng điểm có quá nhiều điểm 5,0 tròn trịa sẽ tự tố cáo nó.
Số liệu ngân sách châu Âu. Năm 2011, bốn nhà kinh tế người Đức áp luật Benford lên số liệu kinh tế vĩ mô mà các nước EU báo cáo cho Eurostat. Trong các nước dùng đồng euro, số liệu của Hy Lạp lệch khỏi luật Benford nhiều nhất [15]. Trước đó, năm 2009, Hy Lạp đã phải công bố lại số thâm hụt ngân sách, cao hơn nhiều so với con số báo cáo trước. Nghiên cứu không chứng minh gian lận; nó cho thấy luật Benford đã có thể chỉ đúng chỗ cần soi từ trước.
Nhưng luật Benford cũng có giới hạn. Nhà báo Tim Harford chỉ ra rằng số liệu lợi nhuận hằng tháng mà Bernard Madoff báo cáo, trong vụ lừa đảo đầu tư lớn nhất lịch sử Mỹ, lại khớp với luật Benford [16]. Kẻ gian lận cẩn thận, hoặc may mắn, vẫn có thể lọt qua. Máy dò kim loại không phát hiện được dao bằng gốm.
Chữ số cuối: con người bịa số rất tệ
Công cụ thứ ba còn đơn giản hơn: nhìn chữ số cuối cùng. Với một con số đếm thật đủ lớn, như số phiếu bầu ở một điểm bỏ phiếu (412, 1.387, 905…), chữ số cuối gần như ngẫu nhiên: mỗi chữ số từ 0 tới 9 xuất hiện khoảng 10%.
Con người thì không ngẫu nhiên được. Bạn hãy thử hỏi mười người bạn “nghĩ nhanh một số từ 1 đến 10”: hiếm ai chọn 1 hay 10. Hai nhà khoa học chính trị Bernd Beber và Alexandra Scacco tổng hợp các thí nghiệm tâm lý và chỉ ra ba thói quen của người bịa số [17]:
- Thiên vị vài chữ số, dù được trả tiền để chọn cho thật ngẫu nhiên.
- Ngại lặp lại: người ta nghĩ 33 hay 77 “trông không ngẫu nhiên”, nên ít viết ra hơn mức tự nhiên.
- Thích cặp chữ số liền nhau (23, 34) và ngại cặp xa nhau (27, 81).
Áp lên số phiếu bầu thật, bài kiểm tra của họ cho thấy số liệu bầu cử Thụy Điển năm 2002 sạch, còn Nigeria năm 2003 và Senegal năm 2007 có dấu hiệu bị can thiệp đáng kể [17].
Nhưng chữ số cuối chỉ có ý nghĩa khi ta hiểu quy tắc sinh ra con số. Điểm thi được cộng từ những câu có điểm cố định, nên chỉ nhận một số giá trị nhất định (9; 9,25; 9,5…). Chữ số thập phân cuối vì thế chẳng bao giờ đều. Đó là do cách chấm, không phải do gian lận. Phần sau sẽ cho thấy điều tương tự trên thị trường chứng khoán.
Cổ phiếu: đếm chữ số trên dữ liệu VN30
Kiểm toán viên dùng luật Benford để lọc sổ sách: chạy trên hàng nghìn bút toán của một công ty, rồi soi kỹ những nhóm số lệch khỏi đường cong, chẳng hạn quá nhiều khoản chi ngay dưới hạn mức phải trình ký như ở Arizona [14]. Muốn biết thước đo này hoạt động thế nào, ta thử nó trên một bộ dữ liệu sạch mà ai cũng lấy được: khối lượng khớp lệnh hằng ngày của các cổ phiếu VN30.
Dữ liệu dùng trong phần này. 28 mã trong danh sách VN30 (bỏ TCX và VPL vì mới niêm yết năm 2025), khối lượng khớp lệnh mỗi phiên từ 10/2021 tới 09/2026, nguồn VCI qua thư viện
vnstock. Tổng cộng 34.844 con số. Đây là phân tích minh họa một ý tưởng thống kê, không phải khuyến nghị đầu tư.
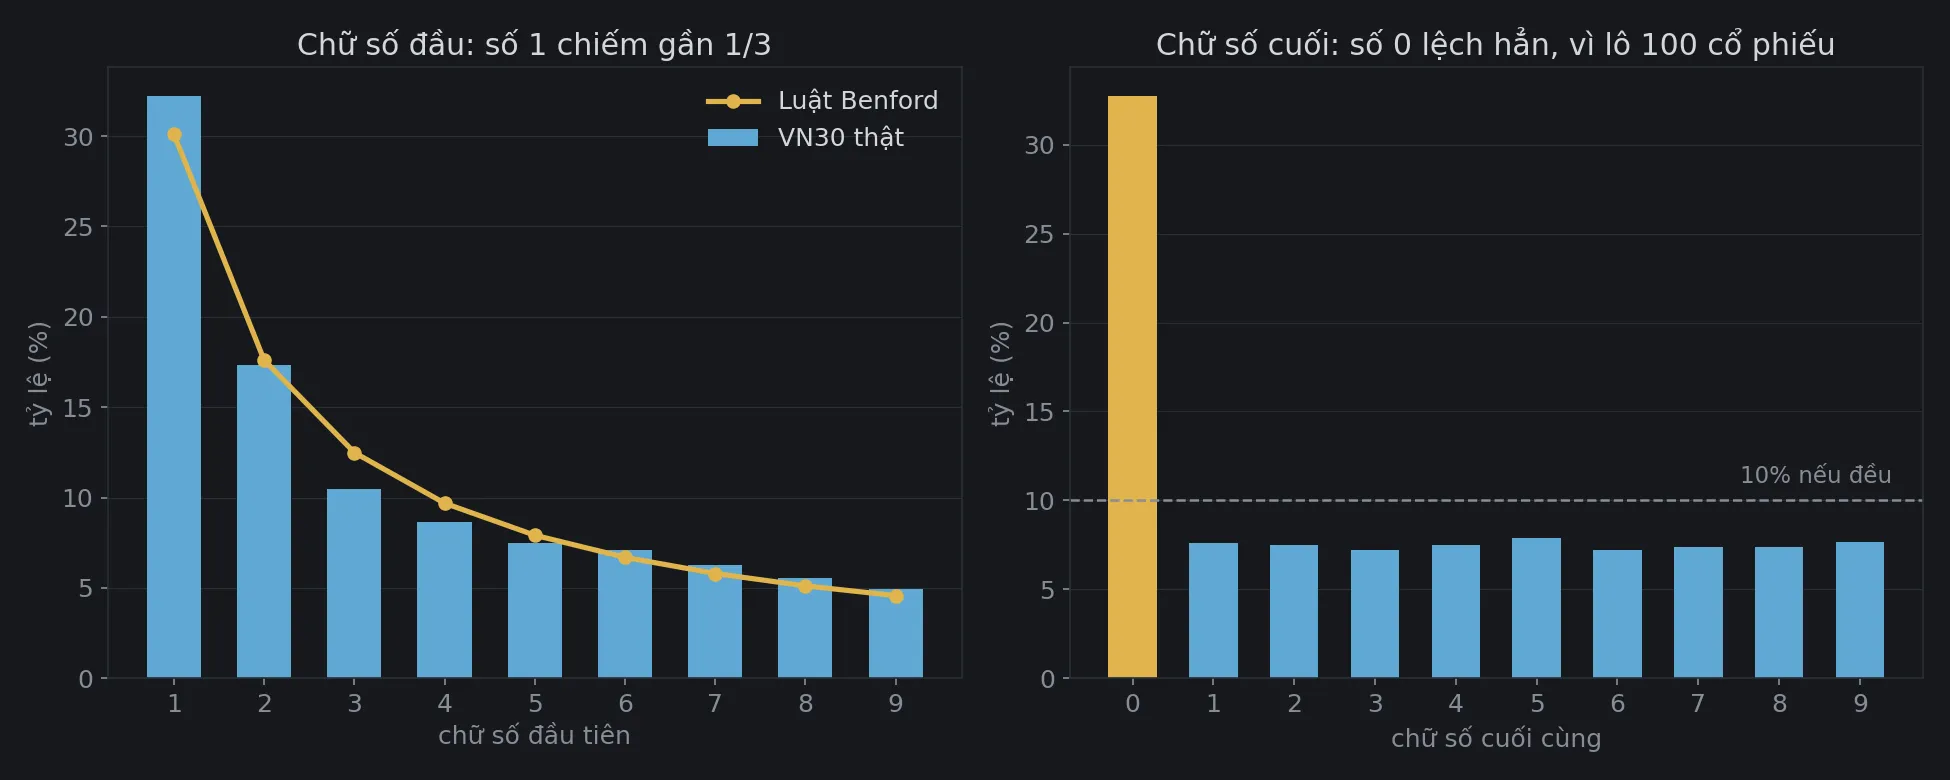
Chữ số đầu (bên trái) khớp với luật Benford khá sát. Chữ số 1 chiếm 32,2% so với 30,1% theo lý thuyết, chữ số 9 chiếm 4,9% so với 4,6%. Thước đo MAD (mean absolute deviation, độ lệch tuyệt đối trung bình) đo xem trung bình mỗi cột lệch khỏi đường cong bao nhiêu, giống như đo xem một bức tường xây lệch khỏi dây dọi trung bình mấy phân. Ở đây MAD bằng 0,0084. Theo thang của Nigrini, dưới 0,006 là rất khớp, 0,006 đến 0,012 là khớp chấp nhận được [14]. Dữ liệu sạch, đúng như ta chờ đợi.
Chữ số cuối (bên phải) lại lệch rất mạnh: 32,7% con số tận cùng bằng 0, gấp hơn ba lần mức 10%. Đây là gian lận chăng? Không. Trên sàn chứng khoán Việt Nam, nhà đầu tư chủ yếu giao dịch theo lô chẵn 100 cổ phiếu, giống như mua trứng theo vỉ 10 quả. Mua theo vỉ thì tổng số trứng bán ra trong ngày tận cùng bằng 0 nhiều hơn hẳn, dù chẳng ai gian dối. Lô lẻ dưới 100 cổ phiếu vẫn được giao dịch, nên tỷ lệ này không lên tới 100%.
Bài học từ cùng một bộ dữ liệu: một độ lệch chỉ đáng ngờ khi ta đã loại trừ được mọi quy tắc có sẵn trong dữ liệu. Lô 100 cổ phiếu, bước chấm điểm, ngưỡng phải trình ký: thiếu hiểu biết về những quy tắc này thì thống kê sẽ “bắt nhầm người”.
Với nhà đầu tư cá nhân, cũng cần thực tế: một báo cáo tài chính năm chỉ có vài chục con số, quá ít để luật Benford phân biệt được gì. Công cụ này mạnh khi chạy trên sổ cái chi tiết hàng nghìn bút toán, thứ chỉ kiểm toán viên và cơ quan quản lý mới có. Điều nhà đầu tư dùng được là cách nghĩ: khi thấy một chuỗi số “đẹp bất thường”, như lợi nhuận tăng đều tăm tắp mỗi quý hay doanh thu luôn vượt kế hoạch đúng vài phần trăm, hãy hỏi nó được so với cái gì và sinh ra từ quy tắc nào.
Tự tay đếm chữ số trên VN30
Đoạn code dưới đây tạo ra đúng Hình 2 và các con số ở mục trên. Cần cài vnstock, pandas, numpy và matplotlib. API key của vnstock không bắt buộc, nhưng gói miễn phí giới hạn số request mỗi phút nên code nghỉ giữa các lần gọi. Dữ liệu là dữ liệu thật nên không có yếu tố ngẫu nhiên. Nếu nguồn dữ liệu cập nhật lại lịch sử, con số có thể lệch ở chữ số thập phân cuối.
import time
import matplotlib.pyplot as pltimport numpy as npimport pandas as pdfrom vnstock import Quote
plt.rcParams.update({"figure.facecolor": "#16181c", "axes.facecolor": "#16181c", "text.color": "#d4d7dc",                     "axes.edgecolor": "#2a2e35", "axes.labelcolor": "#878d97",                     "xtick.color": "#878d97", "ytick.color": "#878d97", "font.size": 12})
SYMBOLS = ["ACB", "BID", "BSR", "CTG", "FPT", "GAS", "GVR", "HDB", "HPG", "LPB",           "MBB", "MCH", "MSN", "MWG", "SAB", "SHB", "SSB", "SSI", "STB", "TCB",           "VCB", "VHM", "VIB", "VIC", "VJC", "VNM", "VPB", "VRE"]
# Khối lượng khớp lệnh từng phiên của 28 mã VN30, 10/2021 → 09/2026vol = []for sym in SYMBOLS:    df = Quote(source="VCI", symbol=sym).history(start="2021-10-01", end="2026-09-30", interval="1D")    df = df[(df["time"] >= "2021-10-01") & (df["time"] <= "2026-09-30")]  # API có thể trả thừa ngày    vol.append(df["volume"])    time.sleep(3.5)  # Tránh vượt giới hạn số request mỗi phút của gói miễn phí.v = pd.concat(vol).astype("int64").to_numpy()v = v[v > 0]
# 1. Chữ số ĐẦU: so với luật Benford, P(d) = log10(1 + 1/d)dau = np.array([int(str(x)[0]) for x in v])thuc_dau = np.bincount(dau, minlength=10)[1:] / len(dau)benford = np.log10(1 + 1 / np.arange(1, 10))mad = np.abs(thuc_dau - benford).mean()  # độ lệch tuyệt đối trung bình (MAD) của Nigrini
# 2. Chữ số CUỐI: nếu không có gì đặc biệt, mỗi chữ số chiếm khoảng 10%cuoi = v % 10thuc_cuoi = np.bincount(cuoi, minlength=10) / len(cuoi)
print(f"{len(v):,} phiên × mã".replace(",", "."))for d in range(1, 10):    print(f"chữ số đầu {d}: thực tế {thuc_dau[d - 1]:6.1%}   Benford {benford[d - 1]:6.1%}")print(f"MAD = {mad:.4f}  (Nigrini: dưới 0,006 rất khớp, 0,006–0,012 chấp nhận được)")print(f"chữ số cuối 0: {thuc_cuoi[0]:.1%}, các chữ số khác: {thuc_cuoi[1:].min():.1%} – {thuc_cuoi[1:].max():.1%}")
fig, (a1, a2) = plt.subplots(1, 2, figsize=(13, 5.2))a1.bar(range(1, 10), thuc_dau * 100, color="#5fa8d3", width=0.6, label="VN30 thật")a1.plot(range(1, 10), benford * 100, color="#e0b44c", marker="o", lw=2.5, label="Luật Benford")a1.set(xticks=range(1, 10), xlabel="chữ số đầu tiên", ylabel="tỷ lệ (%)",       title="Chữ số đầu: số 1 chiếm gần 1/3")a1.legend(frameon=False)
a2.bar(range(10), thuc_cuoi * 100, color=["#e0b44c"] + ["#5fa8d3"] * 9, width=0.6)a2.axhline(10, color="#878d97", ls="--", lw=1.2)a2.text(9.4, 11, "10% nếu đều", color="#878d97", fontsize=11, ha="right")a2.set(xticks=range(10), xlabel="chữ số cuối cùng", ylabel="tỷ lệ (%)",       title="Chữ số cuối: số 0 lệch hẳn, vì lô 100 cổ phiếu")for a in (a1, a2):    a.set_axisbelow(True)    a.grid(color="#2a2e35", lw=0.6, axis="y")fig.tight_layout()fig.savefig("benford-vn30.png", dpi=150)
Kết quả in ra:
34.844 phiên × mãchữ số đầu 1: thực tế 32.2% Benford 30.1%chữ số đầu 2: thực tế 17.3% Benford 17.6%chữ số đầu 3: thực tế 10.4% Benford 12.5%chữ số đầu 4: thực tế 8.7% Benford 9.7%chữ số đầu 5: thực tế 7.5% Benford 7.9%chữ số đầu 6: thực tế 7.1% Benford 6.7%chữ số đầu 7: thực tế 6.3% Benford 5.8%chữ số đầu 8: thực tế 5.5% Benford 5.1%chữ số đầu 9: thực tế 4.9% Benford 4.6%MAD = 0.0084 (Nigrini: dưới 0,006 rất khớp, 0,006–0,012 chấp nhận được)chữ số cuối 0: 32.7%, các chữ số khác: 7.2% – 7.9%Muốn tự thử, bạn có thể thay v bằng một cột số tiền trong bảng chi tiêu của chính mình, hoặc tự gõ tay 200 con số “trông có vẻ ngẫu nhiên” rồi xem chúng lệch khỏi đường cong Benford đến đâu.
Ba câu hỏi trước một con số “đẹp bất thường”
Dù là bảng điểm, báo cáo tài chính hay số liệu một chiến dịch quảng cáo, có ba câu hỏi giúp ta không tin nhầm và cũng không nghi oan:
- So với cái gì? Một phòng trường chuyên phải được so với trường chuyên, không phải với cả nước.
- Đã soi bao nhiêu chỗ? Lục khắp hàng chục nghìn phòng thi hay hàng nghìn mã cổ phiếu thì kiểu gì cũng gặp vài trường hợp cực đoan do ngẫu nhiên.
- Con số được sinh ra theo quy tắc nào? Bước chấm điểm, lô 100 cổ phiếu, ngưỡng phải trình ký: phải loại trừ hết những quy tắc ấy rồi mới nói tới gian lận.
Nếu sau ba câu hỏi con số vẫn lệch, như 147 điểm 10 trên 329 thí sinh, thì thống kê đã làm xong việc của nó: chỉ ra chỗ cần kiểm tra. Phần còn lại là việc của người điều tra, với bài thi gốc, camera và lời khai. Ở Tuyên Quang, câu trả lời cuối cùng đến từ một thí nghiệm mà nhà thống kê nào cũng mong có: cho cùng những thí sinh ấy thi lại trong điều kiện được giám sát chặt chẽ. Lần thứ hai, không có điểm 10 nào.
Tài liệu tham khảo
- [1]Một trường THPT ở Tuyên Quang có 147 điểm 10 toán tốt nghiệp, điểm trung bình 9,58, hiệu trưởng nói gì?. Tuổi Trẻ, 2026. Ngày 3/7/2026.
- [2]Hơn 4.200 điểm 10 môn Toán kỳ thi tốt nghiệp THPT 2026. VOV, 2026. Ngày 1/7/2026. Bài dùng nguồn này cho số thí sinh và điểm trung bình môn Toán; số điểm 10 lấy theo Tuổi Trẻ.
- [3]Sai phạm thi tốt nghiệp THPT 2026: Những lỗ hổng chỉ lộ ra sau kỳ thi. Dân Trí, 2026. Ngày 24/7/2026.
- [4]Khởi tố Giám đốc Sở GD&ĐT Tuyên Quang cùng 40 bị can trong vụ gian lận thi cử. VietNamNet, 2026. Ngày 1/10/2026.
- [5]Công bố điểm thi lần 2 tại chuyên Tuyên Quang: Không có điểm 10 nào, 58 thí sinh dưới trung bình môn toán. Tuổi Trẻ, 2026. Tháng 8/2026.
- [6]Không có thí sinh tại THPT chuyên Tuyên Quang đạt điểm 10 môn toán thi lại. Thanh Niên, 2026. Ngày 19/8/2026.
- [7]Toàn cảnh vụ gian lận điểm thi THPT Quốc gia 2018 gây chấn động: Bê bối bị phanh phui. Tiền Phong.
- [8]Giám đốc Sở GD-ĐT Lào Cai lên tiếng về dải điểm 10 môn Toán tốt nghiệp THPT. VietNamNet, 2026. Ngày 7/7/2026.
- [9]Sở Giáo dục Hà Tĩnh lên tiếng về việc phòng thi có 15 thí sinh đạt điểm 10 môn toán. Tuổi Trẻ, 2026. Ngày 5/7/2026.
- [10]Nghệ An không phát hiện bất thường trong kỳ thi tốt nghiệp THPT. Lao Động, 2026. Ngày 11/7/2026.
- [11]Simon Newcomb. Note on the Frequency of Use of the Different Digits in Natural Numbers. American Journal of Mathematics, 4(1), 39–40, 1881.
- [12]Frank Benford. The Law of Anomalous Numbers. Proceedings of the American Philosophical Society, 78(4), 551–572, 1938.
- [13]Mark J. Nigrini. I've Got Your Number. Journal of Accountancy, 1999.
- [14]Mark J. Nigrini. Benford's Law: Applications for Forensic Accounting, Auditing, and Fraud Detection. Wiley, 2012.
- [15]Bernhard Rauch, Max Göttsche, Gernot Brähler và Stefan Engel. Fact and Fiction in EU-Governmental Economic Data. German Economic Review, 12(3), 243–255, 2011.
- [16]Tim Harford. Look out for No. 1. Financial Times (bản lưu trên blog tác giả), 2011.
- [17]Bernd Beber và Alexandra Scacco. What the Numbers Say: A Digit-Based Test for Election Fraud. Political Analysis, 20(2), 211–234, 2012.