Chia để trị là gì? Từ chồng hồ sơ đến merge sort
Chia để trị giúp giảm công việc bằng cách nào? Theo một chồng hồ sơ qua merge sort để hiểu bước ghép, chi phí tính toán và cách sắp xếp tệp lớn hơn RAM.
Mục lục
Trên bàn là một chồng hồ sơ chưa xếp theo tên. Bạn tìm người đứng đầu bảng chữ cái, rút tờ ấy ra, rồi tìm tiếp trong phần còn lại. Cách làm không khó, nhưng mỗi lượt lại phải nhìn qua gần cả chồng.
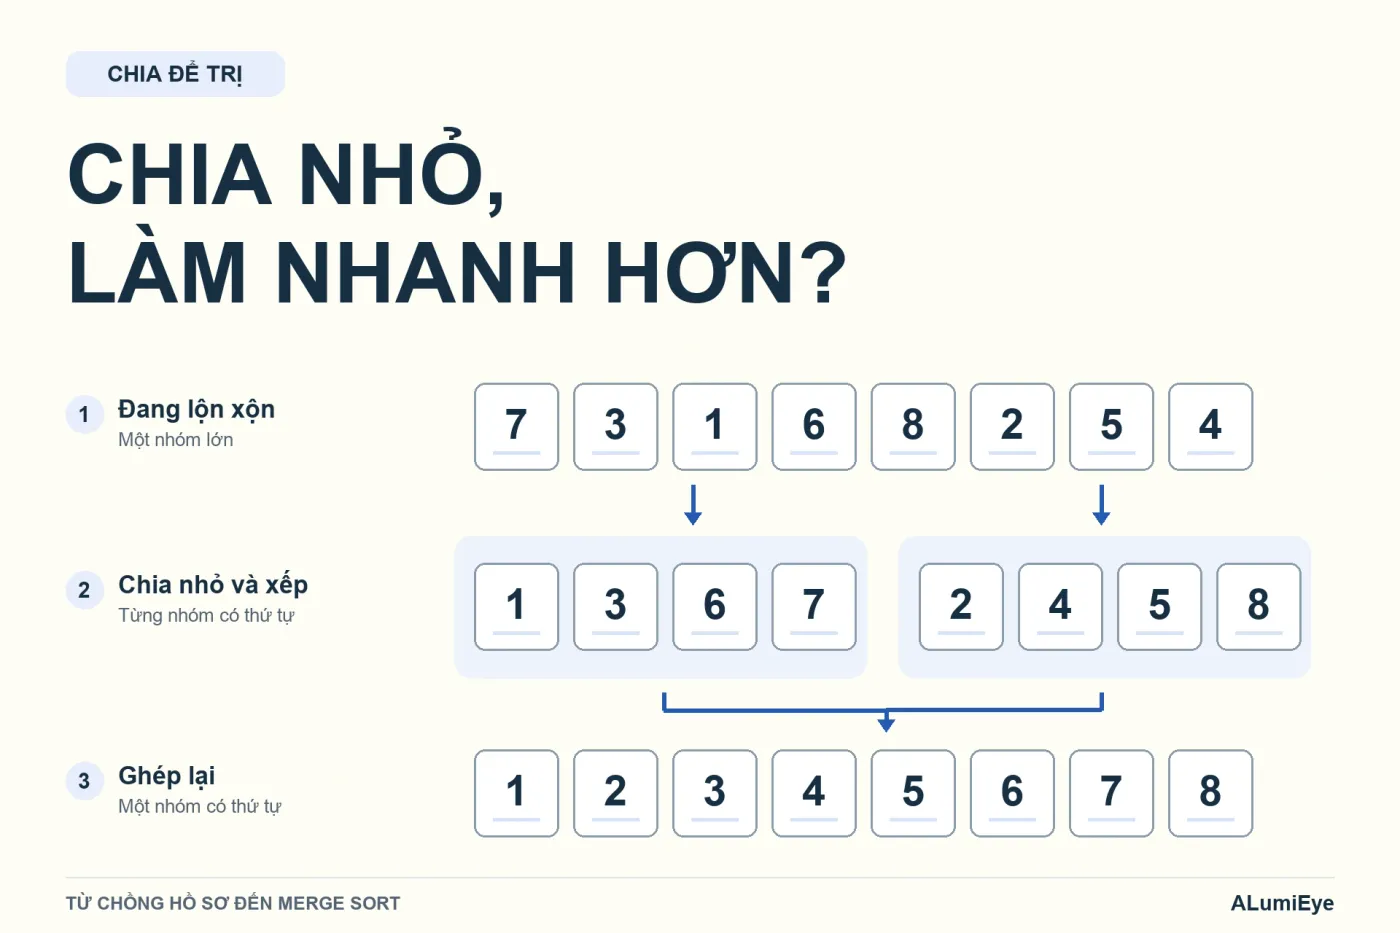
Chia để trị là cách giải bài toán lớn bằng những bài toán nhỏ cùng dạng, rồi ghép kết quả. Với hồ sơ, ta chia chồng làm đôi, sắp từng nửa, rồi trộn hai chồng đã có thứ tự. Thuật toán ấy gọi là sắp xếp trộn (merge sort). Nó tiết kiệm công việc nhờ cách ghép, không phải vì việc chia đôi tự nó làm hồ sơ có thứ tự [1].
Hãy bắt đầu với tám tờ giấy. Từ đó, ta sẽ thấy vì sao cùng một ý tưởng còn dùng được khi dữ liệu lớn đến mức không thể đặt hết vào bộ nhớ máy tính.
Chia để trị: chia rồi ai làm phần còn lại?
Giả sử tám hồ sơ đang nằm theo thứ tự: Lan, Chi, An, Hà, Minh, Bình, Giang, Dung. Trong ví dụ minh họa này, ta chỉ xếp theo tên và các chữ cái đầu đều khác nhau. Chưa cần xử lý những quy tắc khó hơn như tên trùng hoặc thứ tự dấu tiếng Việt.
Chia đôi, bạn có một chồng gồm Lan, Chi, An, Hà. Chồng kia gồm Minh, Bình, Giang, Dung. Cả hai vẫn lộn xộn, nhưng mỗi chồng chỉ còn bốn tờ.
Bạn có thể giao mỗi chồng cho một người. Tuy nhiên, người nhận lại hỏi đúng câu ban đầu: “Sắp bốn tờ này thế nào?” Ta trả lời bằng cùng một cách: chia tiếp thành hai chồng, mỗi chồng hai tờ.
Làm tiếp một lượt, mỗi nhóm chỉ còn một tờ. Một tờ đứng riêng thì không có gì để xếp sai thứ tự. Đó là trường hợp cơ sở (base case): phần việc đã nhỏ đến mức có đáp án ngay, giống một chồng chỉ có hồ sơ của An thì khỏi cần sắp.
Cách dùng lại cùng lời giải trên đầu vào nhỏ hơn gọi là đệ quy (recursion). Ở đây, lời nhờ “sắp chồng này” được chuyển thành hai lời nhờ cùng loại, nhưng ít giấy hơn. Mỗi lượt phải tiến gần chỗ dừng; nếu cứ nhờ tiếp mà chồng không nhỏ đi, công việc sẽ chẳng kết thúc.
Nhưng đến đây, trên bàn mới chỉ có tám tờ tách rời. Công sức chia nhỏ chưa tạo ra danh sách cuối cùng. Nửa còn lại của câu chuyện nằm ở thao tác ghép.
Vì sao ghép hai chồng đã xếp lại dễ?
Giả sử hai chồng nhỏ đã có thứ tự từ trước ra sau. Bên trái là An, Chi, Hà, Lan; bên phải là Bình, Dung, Giang, Minh. Bạn cần tạo một chồng chung, cũng theo tên.
Không phải tìm lại người đứng đầu trong cả tám tờ. Chỉ cần nhìn hai tờ đầu: An và Bình. An đứng trước, nên đặt An vào chồng kết quả, rồi để lộ Chi ở bên trái.
Lần này so Chi với Bình. Bình đứng trước, lấy Bình ra. Cứ thế, ta luôn so hai tờ đang ở đầu hai chồng:
| Hai tên đang nhìn | Tên được lấy tiếp | Phần kết quả đã có |
|---|---|---|
| An và Bình | An | An |
| Chi và Bình | Bình | An, Bình |
| Chi và Dung | Chi | An, Bình, Chi |
| Hà và Dung | Dung | An, Bình, Chi, Dung |
| Hà và Giang | Giang | An, Bình, Chi, Dung, Giang |
| Hà và Minh | Hà | An, Bình, Chi, Dung, Giang, Hà |
| Lan và Minh | Lan | An, Bình, Chi, Dung, Giang, Hà, Lan |
Chồng trái hết. Minh còn lại được đặt nối vào cuối, không cần so với ai nữa. Hai chồng bốn tờ đã được ghép bằng bảy phép so sánh tên trong ví dụ này.
Vì sao không thể bỏ sót một người đáng lẽ đứng trước? Vì mọi tờ phía sau Chi đều không đứng trước Chi; phía sau Bình cũng vậy. Nếu Bình đứng trước Chi, Bình phải đứng trước mọi tờ còn lại ở cả hai bên.
Thứ tự bên trong mỗi chồng cho phép ta chỉ nhìn hai đầu. Mỗi tờ được lấy ra đúng một lần trong lượt ghép ấy, không phải lục lại những tờ đã xử lý. Hai chồng có tổng cộng bao nhiêu tờ thì lượng việc ghép tăng tương ứng bấy nhiêu [1].
Đây là điều phép chia cần tạo ra: những kết quả nhỏ chứa sẵn cấu trúc hữu ích cho bước tiếp theo. Chia xong mà vẫn phải làm lại từ đầu thì chưa tiết kiệm được gì.
Tám tờ giấy đi xuống rồi đi lên thế nào?
Trở lại chồng ban đầu. Ta chưa có sẵn hai chồng bốn tờ đã xếp, nên phải dựng chúng từ những nhóm nhỏ hơn. Ghép Lan với Chi thành Chi, Lan; ghép An với Hà thành An, Hà.
Hai cặp ấy lại được ghép thành An, Chi, Hà, Lan. Ở nửa còn lại, Minh với Bình thành Bình, Minh; Giang với Dung thành Dung, Giang. Ghép tiếp, ta có Bình, Dung, Giang, Minh.
Bây giờ mới dùng lượt ghép tám tờ trong bảng phía trên. Mọi bước đều cùng một quy tắc: chỉ ghép những nhóm mà bên trong đã có thứ tự.
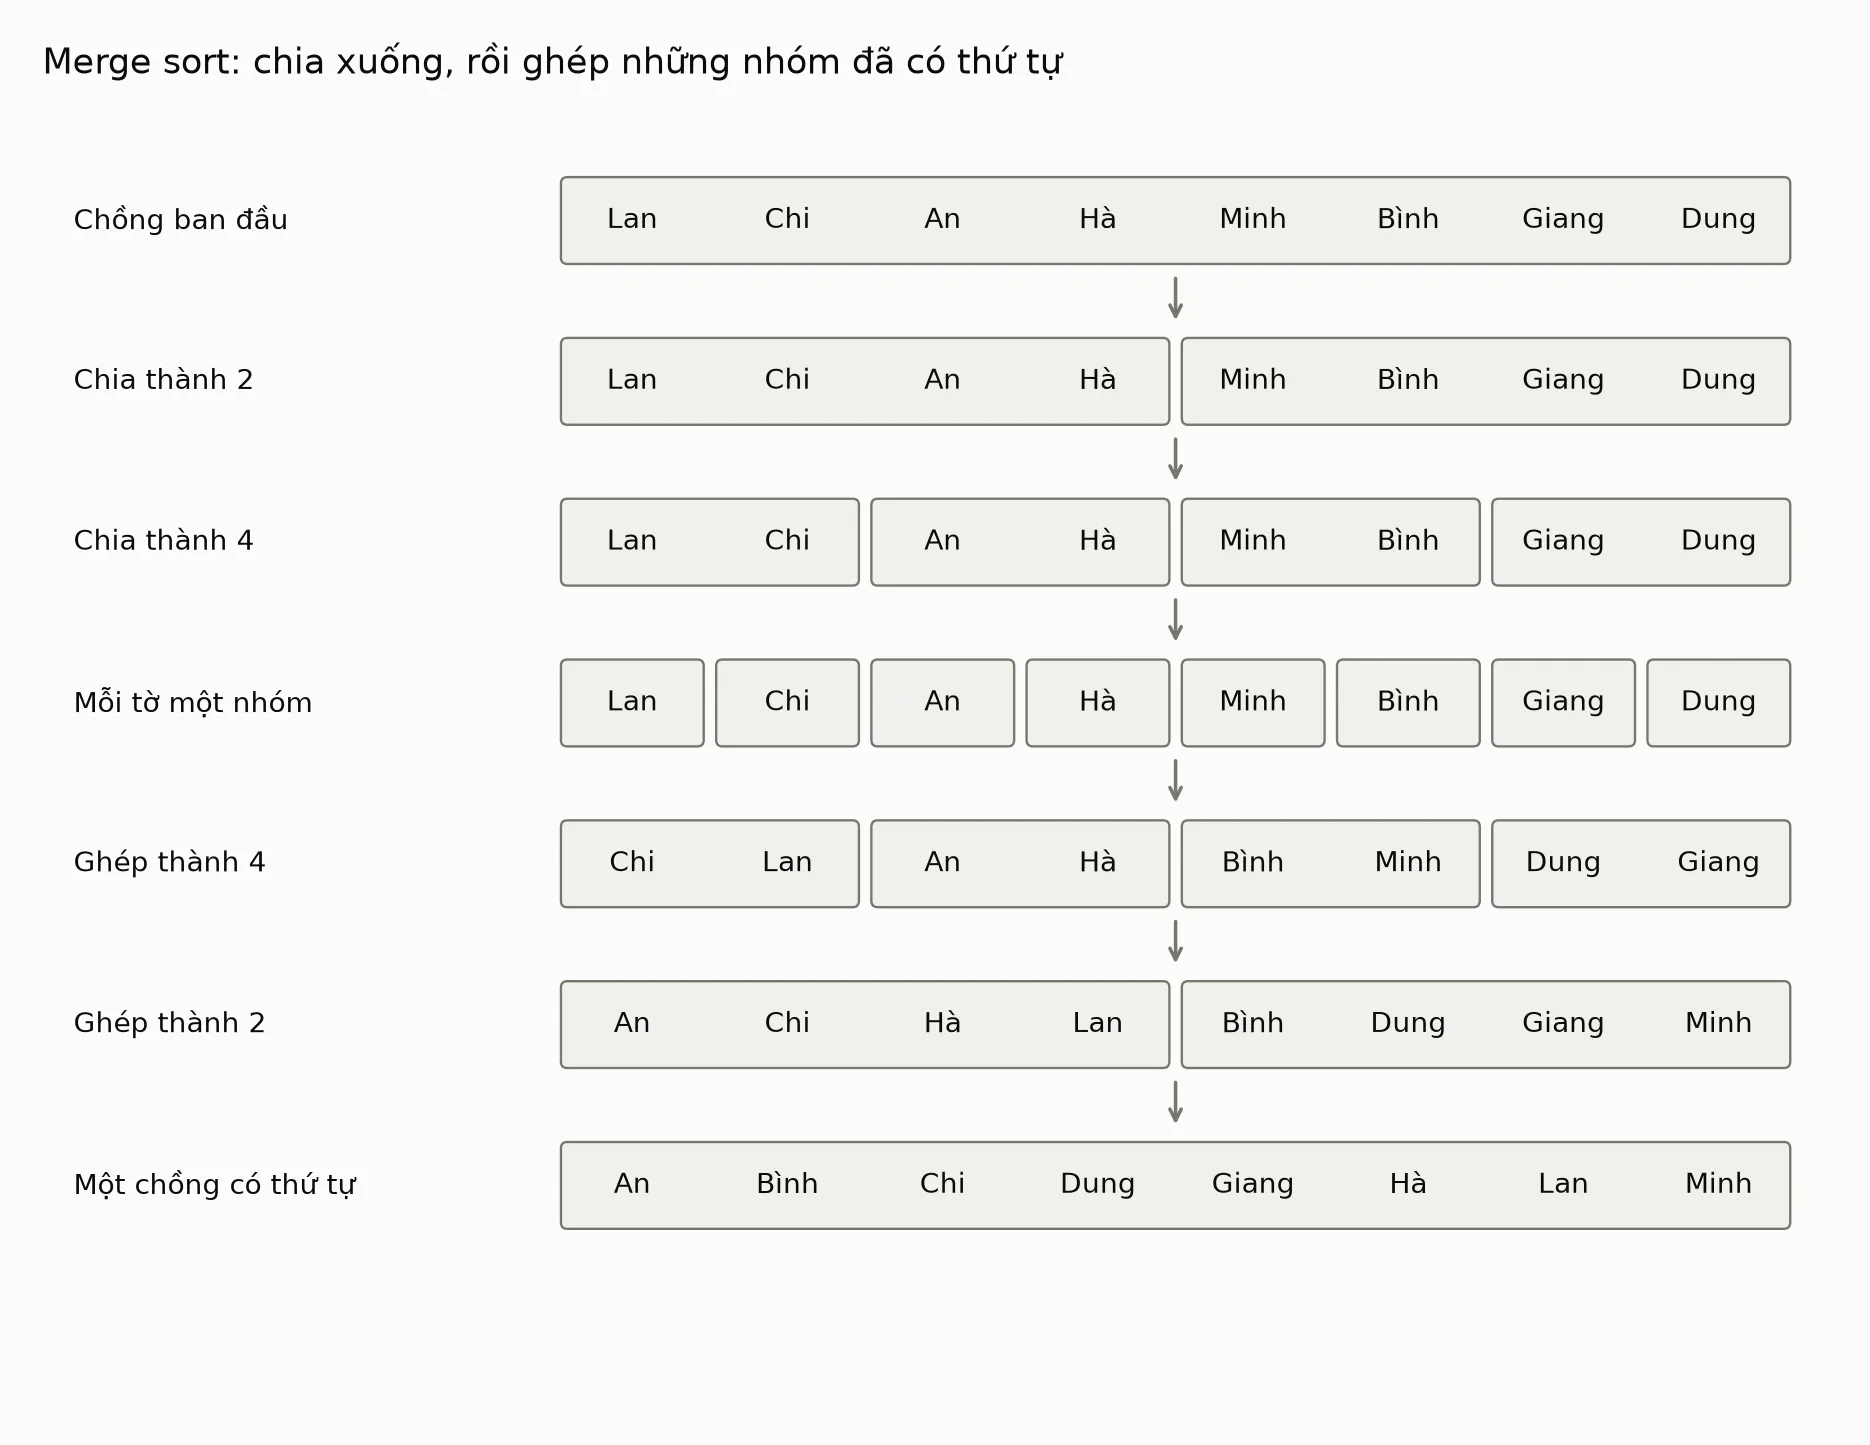
Hình vẽ trải mọi nhóm ra để dễ theo dõi. Một chương trình đệ quy thường xử lý xong nhánh trái, rồi nhánh phải, rồi mới ghép. Nó không nhất thiết giữ nguyên cả bảy hàng trong bộ nhớ.
Cũng có thể bỏ phần đi xuống và bắt đầu ngay từ các nhóm một tờ. Ghép từng cặp, rồi từng nhóm bốn, tám, cứ thế lớn dần. Đó là merge sort từ dưới lên; cách viết không dùng đệ quy nhưng vẫn giữ nguyên cấu trúc ghép [1].
Vì vậy, đệ quy là một cách tổ chức chương trình, không phải phép màu tạo ra hiệu quả. Bạn có thể ghi công việc lên giấy hoặc làm tuần tự bằng các vòng lặp. Điều quyết định vẫn là những nhóm nhỏ được xử lý thế nào và đáp án của chúng nối lại ra sao.
Chia nhiều lượt, vì sao tổng việc lại ít hơn?
Thoạt nhìn, merge sort có vẻ làm việc vòng vèo. Chia ba lượt rồi ghép ba lượt, trong khi cách tìm tên nhỏ nhất cứ làm thẳng. Nhưng ta cần đếm mỗi lượt phải nhìn lại bao nhiêu tờ.
Với cách chọn tên đứng đầu, tám tờ cần bảy phép so sánh để tìm người đầu tiên. Bảy tờ còn lại cần sáu phép để tìm người tiếp theo. Tổng là 7 + 6 + 5 + 4 + 3 + 2 + 1 = 28 phép so sánh.
Đây là cách đếm của sắp xếp chọn (selection sort): mỗi vòng tìm mục nhỏ nhất trong phần chưa xếp, như rút lần lượt từng hồ sơ ra khỏi chồng. Số phép so sánh theo cách này không giảm chỉ vì đầu vào tình cờ đã có thứ tự [2].
Với merge sort, mỗi tầng ghép đều chỉ xử lý tổng cộng tám tờ. Tầng đầu có bốn cặp, tầng sau có hai nhóm bốn, tầng cuối có một nhóm tám. Số nhóm giảm đi nhưng tổng số giấy không tăng.
Số tầng cũng tăng chậm. Tám tờ cần ba tầng ghép; mười sáu tờ cần bốn; ba mươi hai tờ cần năm. Gấp đôi chồng giấy chỉ thêm một tầng, chứ không gấp đôi số tầng.
Đến đây mới cần ký hiệu. Gọi số hồ sơ là . Số lần chia đôi để còn một tờ là khi là lũy thừa của 2. Logarit ở đây chỉ là cách đếm số lượt chia đôi, không phải một thao tác mới với hồ sơ.
Mỗi tầng ghép làm lượng việc tỷ lệ với , có khoảng tầng. Vì thế, lượng việc tăng theo , thay vì gần phép so sánh của sắp xếp chọn [1] [2].
Độ phức tạp (complexity) mô tả kiểu tăng ấy. Nó giống dự tính lượng công việc khi chồng giấy dày lên, không phải dùng đồng hồ đo một người cụ thể. Ký hiệu cho biết một mức chặn trên về tốc độ tăng, không khẳng định số giây bằng đúng biểu thức đó.
| Số hồ sơ minh họa | So sánh của sắp xếp chọn: | Mốc để hình dung quy mô |
|---|---|---|
| 8 | 28 | 24 |
| 1.024 | 523.776 | 10.240 |
| 1.048.576 | 549.755.289.600 | 20.971.520 |
Cột cuối là mốc tính từ công thức, không phải số phép so sánh chính xác của mọi lần chạy merge sort. Với tám tên trong hình, chương trình cuối bài thực sự dùng 17 phép so sánh: bốn ở tầng ghép cặp, sáu ở tầng tiếp theo và bảy ở tầng cuối.
Chênh lệch về số phép so sánh chưa chuyển thẳng thành tỷ lệ tăng tốc. Máy còn phải đọc, ghi và chuyển dữ liệu; so tên dài cũng khác so một số nguyên. Nhưng khi đầu vào lớn dần, tránh được việc quét lại gần cả chồng ở mỗi vòng tạo ra khác biệt về quy mô.
Bạn có thể nhớ đến tìm kiếm nhị phân trong cơ sở dữ liệu, nơi cũng xuất hiện việc chia đôi. Khác biệt là tìm kiếm chỉ theo một nửa phù hợp và bỏ nửa kia. Sắp xếp phải xử lý cả hai nửa, nên công việc không chỉ còn logarit.
Nếu chồng hồ sơ không vừa chiếc bàn?
Một máy tính cần sắp xếp tệp nhật ký theo thời điểm. Giả sử minh họa tệp lớn 100 GB, nhưng chương trình chỉ có thể dành một phần RAM cho việc sắp xếp. RAM giống mặt bàn làm việc: dữ liệu phải được đưa lên đó để xử lý thuận tiện, trong khi ổ lưu trữ giống tủ chứa hồ sơ.
Không thể giả vờ cả tủ đều nằm trên bàn. Ta đọc từng phần vừa bộ nhớ, sắp xếp phần ấy, rồi ghi ra ổ lưu trữ thành một đoạn có thứ tự. Sau đó lấy phần tiếp theo.
Các đoạn đã xếp gọi là run. Hãy hình dung nhiều hộp hồ sơ, mỗi hộp đã theo tên nhưng giữa các hộp chưa có thứ tự chung. Việc còn lại chính là ghép chúng [3].
Muốn ghép hai tệp, chương trình không cần nạp cả hai. Nó giữ một phần đầu của mỗi tệp trong bộ đệm (buffer), như lấy một xấp nhỏ từ mỗi hộp lên bàn. Lấy mục đứng trước, ghi vào bộ đệm đầu ra; xấp nào hết thì đọc tiếp xấp ấy.
Khi bộ đệm đầu ra đầy, ghi nó xuống ổ lưu trữ rồi tiếp tục. Nhờ vậy, tệp kết quả có thể lớn hơn RAM nhiều lần. Điều cần vừa bộ nhớ là các phần đang xử lý, không phải toàn bộ dữ liệu [3].
Đó là sắp xếp ngoài (external sorting): sắp dữ liệu không vừa bộ nhớ chính bằng cách phối hợp xử lý trong RAM và đọc, ghi ở bộ nhớ ngoài. Các phần ban đầu có thể được sắp bằng một thuật toán khác; điều được giữ lại ở đây là lợi thế ghép những đoạn đã có thứ tự.
Vì sao không chỉ ghép từng đôi?
Nếu có nhiều đoạn, ghép hai đoạn một lần có thể cần nhiều lượt qua toàn bộ dữ liệu. Mỗi lượt lại phải đọc rồi ghi các bản trung gian. Lúc này, số chuyến đi giữa tủ và bàn có thể đáng quan tâm hơn vài phép so tên.
Có thể ghép nhiều đoạn cùng lúc, miễn RAM đủ chỗ cho các bộ đệm và thông tin quản lý. Chương trình chọn mục nhỏ nhất trong những đầu đoạn đang có. Càng ghép được nhiều đoạn trong một lượt, càng có cơ hội giảm số lượt đọc, ghi toàn bộ dữ liệu [3].
Tuy nhiên, thêm đoạn cũng cần thêm bộ đệm và chi phí chọn mục tiếp theo. Tệp tạm chiếm dung lượng ổ lưu trữ; việc phân chia RAM phải tính cả dữ liệu phụ. Không nên lấy “máy có 16 GB RAM” làm lý do để đọc đúng 16 GB tệp vào một lần.
Câu chuyện đã đổi thứ cần đếm: từ số lần so tên sang cả lượng dữ liệu phải di chuyển. Cấu trúc chia và ghép vẫn hữu ích, nhưng thiết kế thực tế phải phù hợp với chiếc bàn và cái tủ đang dùng.
Chia để trị có phải cứ thêm người là nhanh?
Hai chồng độc lập cho phép hai người sắp cùng lúc. Nhưng nếu chỉ một người làm, người ấy vẫn có thể sắp chồng trái rồi chồng phải. Thuật toán vẫn giảm được công việc so với cách chọn từng tên, dù không có ai hỗ trợ.
Xử lý song song (parallel processing) là dùng nhiều người hoặc nhiều bộ xử lý làm đồng thời. Nó là một cơ hội từ cấu trúc bài toán, không phải điều tự xảy ra khi ta chia đôi danh sách. Chương trình cần cách giao việc, chờ kết quả và phối hợp bộ nhớ.
Ngay cả khi hai người sắp hai nửa rất nhanh, bước ghép cuối theo cách đơn giản vẫn do một người làm. Với chồng nhỏ, thời gian chia việc và bàn giao có thể lớn hơn phần tiết kiệm. Vì thế, không thể nhìn cây chia đôi rồi suy ra cứ gấp đôi người là hoàn thành trong nửa thời gian.
Chia nhỏ còn có hai giới hạn khác. Thứ nhất là chi phí ghép: nếu mỗi lần ghép phải đem tất cả hồ sơ ra sắp lại bằng cách chậm ban đầu, công sức ở các nhánh có thể bị xóa mất. Lợi thế của merge sort nằm ở việc không làm như vậy.
Thứ hai là chỗ chứa. Bản merge sort thông thường dùng vùng nhớ phụ tỷ lệ với số phần tử [1]. Trên bàn, đó là khoảng trống để đặt chồng kết quả trong khi hai chồng nguồn vẫn còn. Bài toán không chỉ hỏi “so ít hơn không?”, mà còn hỏi “có chỗ để thực hiện cách ghép này không?”.
Nếu các việc nhỏ cứ lặp lại thì sao?
Trong ví dụ hồ sơ, hai nửa chứa những tờ khác nhau. Dù hai tờ cùng ghi tên Lan, chúng vẫn là hai hồ sơ riêng, không phải cùng một yêu cầu được giao hai lần.
Có bài toán lại liên tục hỏi đúng một việc nhỏ đã giải. Giống hai người cùng nhờ bạn đếm cùng một hộp hồ sơ: đếm xong rồi cất kết quả sẽ hợp lý hơn mỗi lần mở hộp ra đếm lại.
Đó là chỗ nên nghĩ đến ghi nhớ và quy hoạch động (dynamic programming). Bài Tháp Hà Nội và cách nhớ lại thay vì tính lại đi sâu vào dạng câu hỏi ấy. Có bài toán con lặp là dấu hiệu để xem xét tái sử dụng, không phải bảo đảm chỉ cần lập bảng là mọi thứ sẽ nhanh.
Bởi vậy, “chia nhỏ” chưa phải một lời giải hoàn chỉnh. Ta phải biết các phần có nhỏ đi thật không, có bị giải đi giải lại không, và kết quả của chúng có ghép được với chi phí hợp lý không.
Tự tay vẽ các tầng chia và ghép
Đoạn Python dưới đây tạo đúng Hình 1 và đếm số phép so sánh tên trong các lượt ghép. Nó dùng tám tên cố định, không có dữ liệu ngẫu nhiên. Chỉ cần matplotlib; chạy từ thư mục mà bạn muốn lưu thư mục images/.
Phần đi xuống dựng các nhóm nhỏ. Phần đi lên ghép từng cặp nhóm bằng hai vị trí i, j, giống hai ngón tay đặt trên đầu hai chồng. Đây là minh họa giữ lại mọi hàng để vẽ, không phải bản triển khai tiết kiệm bộ nhớ cho tệp lớn.
from pathlib import Pathimport matplotlibmatplotlib.use("Agg")import matplotlib.pyplot as pltfrom matplotlib.patches import FancyBboxPatch
names = ["Lan", "Chi", "An", "Hà", "Minh", "Bình", "Giang", "Dung"]comparisons = 0

def merge(left, right):    global comparisons    result, i, j = [], 0, 0    while i < len(left) and j < len(right):        comparisons += 1        if left[i] <= right[j]:            result.append(left[i])            i += 1        else:            result.append(right[j])            j += 1    return result + left[i:] + right[j:]

rows = [[names]]while any(len(group) > 1 for group in rows[-1]):    smaller = []    for group in rows[-1]:        mid = len(group) // 2        smaller.extend([group[:mid], group[mid:]])    rows.append(smaller)
runs = rows[-1]while len(runs) > 1:    runs = [merge(runs[i], runs[i + 1]) for i in range(0, len(runs), 2)]    rows.append(runs)
assert runs[0] == sorted(names)assert comparisons == 17print("Kết quả:", ", ".join(runs[0]))print("Số phép so sánh khi ghép:", comparisons)
plt.rcParams.update({"font.family": "DejaVu Sans", "font.size": 12})fig, ax = plt.subplots(figsize=(11, 8.5), dpi=170)fig.patch.set_facecolor("#fcfcfb")ax.set(xlim=(-3.3, 8.2), ylim=(-0.8, 7.2))ax.axis("off")labels = ["Chồng ban đầu", "Chia thành 2", "Chia thành 4", "Mỗi tờ một nhóm",          "Ghép thành 4", "Ghép thành 2", "Một chồng có thứ tự"]for row, (groups, label) in enumerate(zip(rows, labels)):    y, x = 6.3 - row, 0    ax.text(-3.1, y + 0.25, label, va="center", color="#0b0b0b")    for group in groups:        width = len(group)        box = FancyBboxPatch((x + 0.06, y), width - 0.12, 0.5,                             boxstyle="round,pad=0.02,rounding_size=0.04",                             facecolor="#f0f0eb", edgecolor="#77776f", lw=1)        ax.add_patch(box)        for offset, name in enumerate(group):            ax.text(x + offset + 0.5, y + 0.25, name, ha="center",                    va="center", color="#0b0b0b")        x += width    if row < len(rows) - 1:        ax.annotate("", xy=(4, y - 0.4), xytext=(4, y - 0.08),                    arrowprops={"arrowstyle": "->", "color": "#77776f", "lw": 1.5})ax.set_title("Merge sort: chia xuống, rồi ghép những nhóm đã có thứ tự",             loc="left", fontsize=15, color="#0b0b0b", pad=18)fig.tight_layout(pad=1.5)output = Path("images/chia-de-tri/chia-va-ghep.png")output.parent.mkdir(parents=True, exist_ok=True)fig.savefig(output)plt.close(fig)
Kết quả chạy:
Kết quả: An, Bình, Chi, Dung, Giang, Hà, Lan, MinhSố phép so sánh khi ghép: 17Python so chuỗi theo thứ tự mã ký tự, không tự áp dụng đầy đủ quy tắc xếp tên tiếng Việt. Tám tên được chọn có chữ cái đầu khác nhau và cho đúng thứ tự đang minh họa. Ngoài ra, phần dựng hình này được viết riêng cho tám tên, không phải hàm sắp xếp tổng quát để thay danh sách dài tùy ý.
Bạn có thể đổi thứ tự tám tên rồi bỏ dòng kiểm tra comparisons == 17 để quan sát số so sánh thay đổi. Kết quả cuối vẫn được kiểm tra với sorted(names), nhưng đường đi và số so sánh không nhất thiết giữ nguyên.
Trở lại chồng hồ sơ trên bàn
Ban đầu, bạn chỉ có một chồng giấy và cách làm quen thuộc: tìm người đứng đầu, rút ra, rồi tìm lại. Merge sort không làm bạn đọc tên nhanh hơn. Nó thay đổi cách tổ chức để bạn không phải liên tục lục lại những tờ đã nhìn.
Khi chồng giấy lớn hơn mặt bàn, cấu trúc ấy còn cho phép làm từng phần rồi ghép dần từ các hộp. Nhưng lợi ích không đến miễn phí: phải có chỗ đặt kết quả, phải di chuyển giấy, và phải chọn cách ghép phù hợp.
Bởi vậy, câu hỏi đáng giữ lại không chỉ là “chia việc này thành mấy phần?”. Hãy hỏi thêm: khi các phần đã xong, mình có thể dùng kết quả của chúng để hoàn thành việc lớn mà không làm lại từ đầu không?
Vẽ minh họa hình học miễn phí cho học sinh và giáo viên: EyeViz.
Tài liệu tham khảo
- [1]Robert Sedgewick và Kevin Wayne. Mergesort. Algorithms, 4th Edition, Princeton University.
- [2]Robert Sedgewick và Kevin Wayne. Elementary Sorts. Algorithms, 4th Edition, Princeton University.
- [3]External Sorting. OpenDSA, Virginia Tech.