Vector database: tìm gần nghĩa, sao vẫn sai tài liệu?
Thiết kế vector database mức trung cấp: chọn HNSW hay IVF, lọc quyền truy cập, đồng bộ embedding và đo chất lượng tìm kiếm ngoài độ trễ.
Mục lục
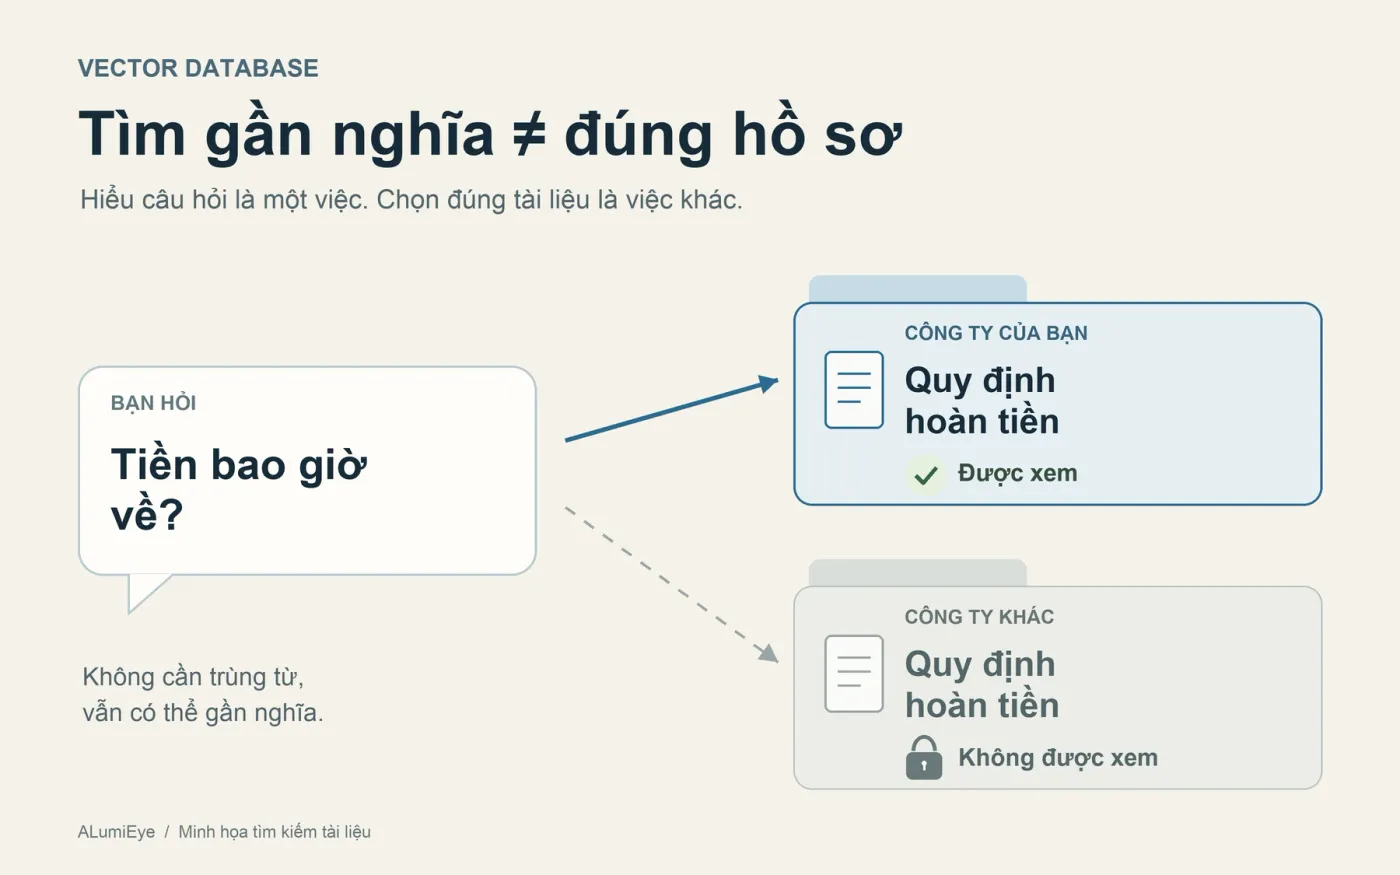
Một nhân viên hỏi: “Khách trả hàng thì bao lâu nhận lại tiền?”. Ô tìm kiếm hiểu “nhận lại tiền” gần nghĩa với “hoàn tiền”. Nhưng tài liệu đứng đầu lại thuộc công ty khác, còn hướng dẫn đúng đang nằm ngoài danh sách. Vector database vẫn có thể tìm sai tài liệu dù tính khoảng cách đúng, vì gần nghĩa chưa đồng nghĩa với đúng khách hàng, đúng phiên bản và đủ quyền xem.
Muốn thiết kế hệ thống này, cần ghép ba việc: biểu diễn nội dung thành dãy số, tìm các dãy số gần nhau, rồi quản lý dữ liệu và điều kiện truy cập. Bài này đi theo một kho tài liệu doanh nghiệp giả định. Câu hỏi xuyên suốt là: làm sao trả về những đoạn gần nghĩa trong đúng tập tài liệu được phép, ngay cả khi dữ liệu đang thay đổi?
Vector database khác một thư viện tìm kiếm ở đâu?
Hãy hình dung thủ thư nhận câu hỏi “tiền bao giờ về?” rồi tìm quy định “thời hạn hoàn tiền”. Hai câu không trùng nhiều từ, nhưng nói về cùng một việc. Embedding là dãy số do mô hình tạo ra để biểu diễn nội dung, giống tọa độ trên bản đồ chủ đề. Những đoạn có nội dung liên quan được kỳ vọng nằm gần nhau theo thước đo đã chọn; đó không phải lời bảo đảm rằng chúng cùng đúng.
Bài tìm kiếm bằng hình ảnh đã giải thích trực giác tọa độ và hàng xóm gần nhất. Ở đây, phần khó bắt đầu sau khi đã có tọa độ. Một thư viện như FAISS có thể giúp tìm điểm gần. Còn hệ thống phục vụ thật phải giải quyết thêm việc lưu bền, cập nhật, lọc, phục hồi và phân phối truy vấn.
Vector database là cơ sở dữ liệu hỗ trợ lưu và truy vấn vector cùng các thông tin đi kèm. Nó giống thư viện có cả bản đồ tìm sách lẫn sổ quản lý sách: cuốn nào còn hiệu lực, thuộc chi nhánh nào, ai được đọc. Sản phẩm có thể là một hệ chuyên dụng hoặc một cơ sở dữ liệu quen thuộc được bổ sung khả năng vector, chẳng hạn PostgreSQL với pgvector[1].
Cơ sở dữ liệu không nhất thiết tự tạo embedding. Mô hình có thể chạy ở dịch vụ khác. Đổi nơi lưu không sửa được mô hình biểu diễn kém; tăng tốc tìm kiếm cũng không biến tài liệu cũ thành chính sách mới.
Trước khi chọn chỉ mục, ô tìm kiếm phải hứa điều gì?
Đặt một bài toán minh họa: kho có 10 triệu đoạn tài liệu của nhiều doanh nghiệp. Mỗi truy vấn cần tối đa 10 kết quả, chỉ từ doanh nghiệp của người đang đăng nhập và những tài liệu họ được đọc. Nội dung mới được phép xuất hiện chậm một chút; thu hồi quyền thì không được để lộ nội dung trong khoảng chờ ấy.
Nhóm thiết kế đặt mục tiêu giả định: 95% truy vấn hoàn tất trong 300 mili giây, thay đổi nội dung có thể tìm thấy trong 60 giây. Đây là yêu cầu để bàn thiết kế, không phải số đo của một sản phẩm. “95% trong 300 mili giây” nghĩa là xếp thời gian các truy vấn từ nhanh đến chậm, mốc 95% không vượt giới hạn đó.
Cần tách ba lời hứa khác nhau. Đúng phạm vi là không trả tài liệu ngoài quyền, như thủ thư không đưa hồ sơ phòng nhân sự cho người chưa được phép. Đúng hàng xóm là tìm được những vector gần nhất trong phạm vi ấy. Hữu ích là những đoạn tìm được thực sự trả lời câu hỏi. Hai đoạn gần nhau về ngôn ngữ vẫn có thể nói về chính sách của hai năm khác nhau.
Luồng đọc vì thế không dừng ở một lệnh tìm vector. Dịch vụ xác thực xác định doanh nghiệp và quyền từ phía máy chủ. Câu hỏi được biến thành vector bằng cấu hình tương thích với kho. Hệ thống tìm ứng viên trong phạm vi hợp lệ, xếp hạng, kiểm tra phiên bản và quyền hiện hành, rồi mới đọc nội dung để trả về.
Nếu dùng các đoạn ấy làm tài liệu cho chatbot, kiểm tra phải xảy ra trước khi đưa chúng cho mô hình sinh câu trả lời. Lọc lại câu trả lời cuối không thu hồi được dữ liệu đã gửi sang một dịch vụ khác. Bộ lọc doanh nghiệp cũng không được lấy nguyên từ tham số người dùng tự khai.
Một tài liệu nên có mấy tọa độ?
Một quy trình hoàn tiền dài có thể chứa điều kiện đổi trả, thời gian xử lý và ngoại lệ cho từng phương thức thanh toán. Nén cả tài liệu thành một vector giống ghi cả cuốn sổ tay lên một thẻ mục lục: chủ đề chung còn đó, chi tiết nhỏ dễ chìm. Vì vậy hệ thống thường chia tài liệu thành đoạn truy xuất (chunk), như đánh dấu từng mục trong sổ để tra riêng.
Đoạn quá ngắn làm mất điều kiện đi kèm. Đoạn quá dài trộn nhiều chủ đề. Cắt theo đề mục hoặc đoạn văn là điểm bắt đầu hợp lý, rồi kiểm bằng câu hỏi thật. Phần chồng lấn giữa hai đoạn giúp giữ ngữ cảnh ở đường cắt, nhưng tạo kết quả gần trùng. Khi trả lời, cần gom theo tài liệu hoặc bỏ trùng, tránh đưa mười bản gần giống của cùng một đoạn.
Mỗi bản ghi cần đủ thông tin để quay về nguồn và nhận ra dữ liệu đã cũ:
| Nhóm thông tin | Ví dụ minh họa | Để làm gì? |
|---|---|---|
| Danh tính | Doanh nghiệp A, tài liệu 42, đoạn 3 | Không nhầm đoạn giữa các khách hàng |
| Phiên bản nội dung | Bản 7, dấu kiểm tra nội dung | Không dùng embedding của bản 6 cho văn bản bản 7 |
| Biểu diễn | Không gian embedding E2, cách chia đoạn C3 | Biết cấu hình nào tạo ra vector |
| Điều kiện truy cập | Nhóm được đọc, trạng thái còn hiệu lực | Lọc và kiểm quyền |
| Nội dung | Văn bản hoặc con trỏ tới đúng bản nguồn | Hiển thị, trích dẫn, đọc lại |
Không gian embedding giống hệ tọa độ của một bản đồ. Hai mô hình cùng trả dãy 768 số không có nghĩa là hai bản đồ dùng chung tọa độ. Cần ghi phiên bản mô hình, cách xử lý văn bản, quy tắc tạo vector cho câu hỏi và tài liệu, cùng thước đo khoảng cách. Một số mô hình có cách nhập câu hỏi khác cách nhập tài liệu; phải giữ đúng cặp cấu hình của chúng.
Cosine so hướng của hai vector, giống so hai mũi tên chĩa cùng phía đến đâu. Khoảng cách Euclid đo đoạn thẳng giữa hai điểm. Chọn thước đo theo mô hình và kiểm thử, không theo mặc định của cơ sở dữ liệu. Qdrant hỗ trợ nhiều vector có tên trên cùng một điểm, với kích thước và thước đo riêng; điều đó giúp lưu nhiều biểu diễn tách biệt, không làm chúng tự so sánh được với nhau[3].
Vì sao lấy 10 rồi lọc lại không ra 10?
Bạn nhờ thủ thư lấy mười cuốn gần chủ đề nhất trong toàn thư viện, rồi mới bỏ sách thuộc phòng đọc không được vào. Có thể cả mười cuốn đều bị bỏ. Trong khi đó, trên kệ bạn được đọc vẫn có sách phù hợp, chỉ chưa được lấy ra.
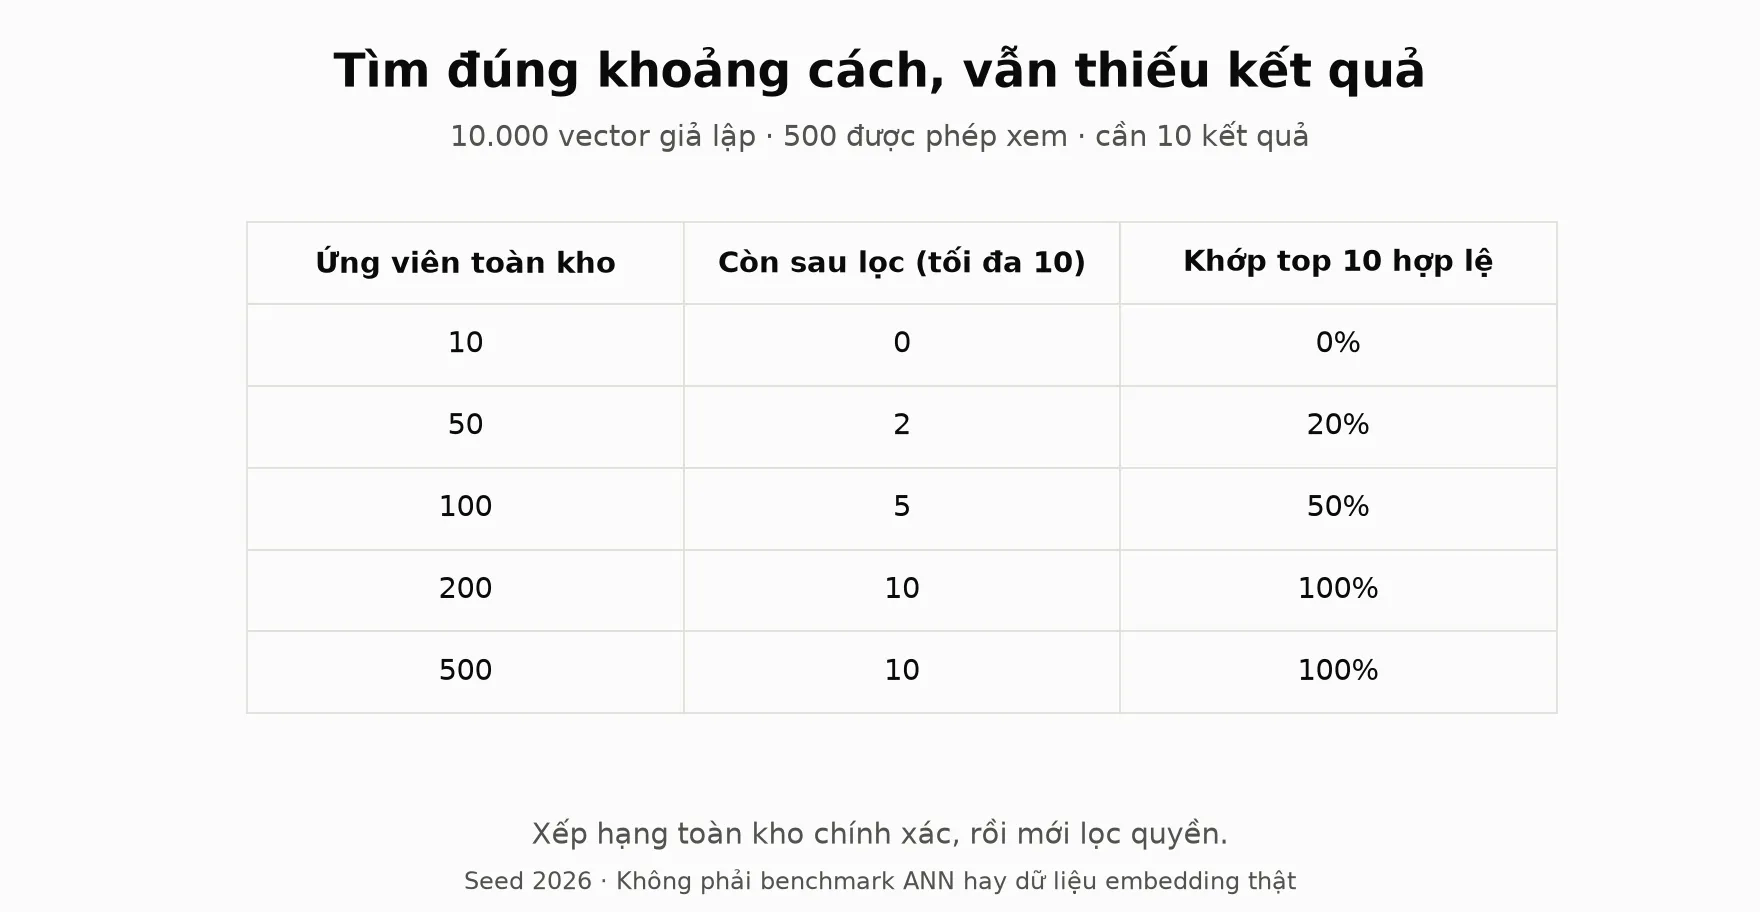
Đó là lỗi của lọc sau (post-filtering): lấy một tập ứng viên rồi áp điều kiện. Hình dưới cố tình dùng xếp hạng khoảng cách chính xác, chưa có sai số thuật toán gần đúng. Trong 10.000 vector giả lập, 500 vector được phép xem. Lấy 10 ứng viên toàn kho rồi lọc còn 0; lấy 100 thì còn 5.
Lọc trước (pre-filtering) xác định kệ được đọc rồi mới tìm trên kệ ấy. Nếu điều kiện chỉ để lại một tập nhỏ, tính khoảng cách chính xác trên tập đó có thể hợp lý hơn đi qua chỉ mục toàn kho. pgvector khuyến nghị cân nhắc chỉ mục cho cột điều kiện và tìm chính xác khi điều kiện khớp ít bản ghi[1].
Còn lọc trong khi tìm giống thủ thư tiếp tục đi tìm khi gặp sách không hợp lệ, thay vì dừng sau mười cuốn đầu. Cách triển khai phụ thuộc hệ thống. pgvector có chế độ quét lặp cho chỉ mục gần đúng: tiếp tục tìm khi chưa đủ kết quả, nhưng vẫn dừng ở giới hạn tài nguyên. Vì vậy bật chế độ này không bảo đảm luôn đủ mười[1].
Một mẹo là lấy dư ứng viên. Nếu khoảng 5% ứng viên hợp lệ, muốn mười kết quả thì có thể nghĩ đến khoảng 200 ứng viên. Nhưng phép tính ấy chỉ là kỳ vọng khi tỷ lệ hợp lệ quanh truy vấn giống tỷ lệ đã ước lượng. Quyền và chủ đề thường liên quan nhau: tài liệu doanh nghiệp khác có thể chiếm gần hết vùng gần nhất. Không được biến mẹo này thành lời bảo đảm.
Cần kiểm chỉ mục trên điều kiện thực tế: từng doanh nghiệp, nhóm quyền và trạng thái tài liệu. Đồng thời phân biệt hai lỗi: kết quả ngoài quyền là lỗi bảo mật; trả thiếu dù có tài liệu hợp lệ là lỗi truy xuất. Lấy dư giúp lỗi thứ hai, không thay thế kiểm soát lỗi thứ nhất.
HNSW hay IVF: đổi tài nguyên nào lấy độ tìm đủ?
Tìm chính xác đo khoảng cách tới mọi vector trong tập đủ điều kiện, như kiểm từng cuốn trên đúng kệ. Nó tạo đáp án chuẩn để đối chiếu. Với tập lớn, tìm hàng xóm gần đúng (ANN) bỏ qua một phần việc để giảm chi phí, chấp nhận có thể bỏ sót vài hàng xóm gần nhất[1].
HNSW tổ chức vector thành đồ thị nhiều tầng, giống đi đường lớn để tới khu phố rồi rẽ vào đường nhỏ. Tầng thưa giúp nhảy xa, tầng dày giúp tìm kỹ[2]. Tham số xây dựng quyết định số đường nối và mức tìm kiếm lúc thêm điểm. Tham số tìm kiếm quyết định giữ bao nhiêu hướng ứng viên khi truy vấn. Tăng ngân sách thường giúp tìm đủ hơn, nhưng tốn công và bộ nhớ hơn.
IVF chia vector thành các cụm, giống xếp sách vào những gian theo chủ đề. Truy vấn chọn một số gian gần nhất rồi kiểm sách bên trong. Với IVFFlat của pgvector, cần dữ liệu để học các cụm; tăng số cụm được thăm khi truy vấn giúp tăng độ tìm đủ nhưng tăng việc phải làm. Tài liệu pgvector mô tả IVFFlat có chi phí dựng và bộ nhớ thấp hơn HNSW, còn HNSW có đánh đổi tốc độ và độ tìm đủ tốt hơn trong triển khai đó[1].
Đây không phải bảng xếp hạng cho mọi bộ dữ liệu. Cần đo cả lúc hệ thống vừa truy vấn vừa cập nhật. Dữ liệu mới lệch khỏi các cụm đã học có thể khiến cấu hình IVF cũ kém phù hợp. HNSW không cần bước học cụm ấy, nhưng thêm, xóa và duy trì đồ thị vẫn có chi phí. Không nên suy từ “thêm được điểm” thành “không bao giờ cần bảo trì”.
Với giả định 10 triệu vector, mỗi vector 768 số float32, riêng các tọa độ cần 30,72 tỷ byte, tức khoảng 30,7 GB theo đơn vị thập phân. Chưa có đường nối đồ thị, thông tin lọc, nội dung, bản sao hay vùng trống khi dựng lại. Đừng chọn máy bằng kích thước vector thô. Nén tọa độ có thể tiết kiệm chỗ, như rút bản ghi thành mã ngắn, nhưng phải đo lại chất lượng và chi phí xếp hạng bằng dữ liệu gốc nếu có.
Cập nhật một đoạn, vì sao phải quản lý cả phiên bản?
Tài liệu nguồn đổi từ “hoàn trong bảy ngày” sang “hoàn trong ba ngày”. Công việc tạo embedding bản mới chạy chậm hơn dự kiến. Nếu ghi văn bản mới trước nhưng giữ vector cũ, hệ thống đang tìm bằng tọa độ của một câu và trả nội dung của câu khác.
Một thiết kế có thể dùng kho tài liệu làm nguồn chuẩn, còn kho vector là bản phục vụ tìm kiếm được dựng từ nguồn ấy. Sự kiện thay đổi đi qua hàng đợi bền, như phiếu việc được giữ lại đến khi xử lý. Cơ chế ghi nguồn và phát phiếu phải tránh mất sự kiện; chi tiết có trong bài inverted index và luồng cập nhật tìm kiếm.
Mỗi công việc mang mã tài liệu và phiên bản. Worker đọc đúng bản nguồn, chia đoạn, tạo vector rồi ghi các đoạn với khóa xác định từ doanh nghiệp, tài liệu, phiên bản và số đoạn. Chạy lại cùng công việc phải không sinh thêm bản trùng. Công việc bản 6 hoàn tất sau bản 7 cũng không được đưa bản đang phục vụ lùi về 6.
Khi một tài liệu có nhiều đoạn, không coi “ghi xong đoạn đầu” là “cập nhật xong tài liệu”. Có thể dựng đủ bộ đoạn mới rồi đổi con trỏ phiên bản đang phục vụ bằng thao tác có điều kiện. Truy vấn chỉ nhận các đoạn thuộc bản hiện hành, giống thủ thư thay cả bộ tờ hướng dẫn rồi mới đổi nhãn “đang áp dụng”. Nếu các kho không hỗ trợ đổi đồng thời, phải thiết kế bước kiểm phiên bản và chấp nhận trả thiếu trong lúc chuyển, thay vì giả vờ có giao dịch xuyên kho.
Xóa tài liệu cũng cần dấu xóa có phiên bản để công việc cũ không làm nó xuất hiện lại. Thu hồi quyền nên cập nhật luồng quyền độc lập, không chờ tạo lại embedding. Kiểm tra quyền hiện hành ở cửa trả nội dung; nếu không xác minh được thì không trả. Bộ nhớ đệm kết quả cũng phải gắn với phạm vi và phiên bản quyền, hoặc bị vô hiệu hóa khi quyền đổi.
Đổi mô hình là một lần chuyển bản đồ. Dựng không gian mới, nạp lại dữ liệu, bắt kịp các cập nhật phát sinh, thử truy vấn trên cả hai và so chất lượng. Chỉ chuyển luồng đọc khi bản mới đạt yêu cầu. Giữ khả năng quay lại trong thời gian phù hợp; không trộn vector cũ và mới vào cùng phép xếp hạng chỉ vì chúng có cùng số chiều.
Một câu gần nghĩa có tìm được mã hợp đồng không?
Câu “bao lâu nhận lại tiền?” hợp với tìm kiếm theo nghĩa. Còn mã “HD-2026-0042” cần giữ đúng ký tự. Hai mã chỉ khác một số có thể rất gần về cách viết nhưng là hai hồ sơ khác nhau.
Tìm kiếm kết hợp (hybrid search) giống hỏi hai thủ thư: một người tra từ và mã chính xác, người kia tra chủ đề. Nhánh từ khóa dùng chỉ mục đảo; nhánh vector tìm theo biểu diễn nội dung. Hai nhánh phải cùng áp phạm vi quyền, phiên bản và trạng thái tài liệu trước khi kết quả được dùng.
Điểm của hai nhánh không mặc nhiên cùng thang. Không nên cộng thẳng điểm từ khóa với độ tương đồng vector rồi gọi đó là độ liên quan. RRF, một cách gộp theo thứ hạng, giống chấm điểm từ vị trí trên hai bảng đề cử thay vì so trực tiếp hai loại điểm. Qdrant hỗ trợ ghép các tập ứng viên bằng RRF trong truy vấn kết hợp[4].
Sau khi gộp và bỏ trùng, có thể dùng mô hình xếp hạng lại: cho nó đọc cả câu hỏi lẫn từng đoạn, như nhờ người đọc kỹ những cuốn đã chọn. Bước này có chi phí riêng và chỉ sắp lại những gì đã lấy được. Tài liệu bị bỏ sót ở cả hai nhánh không tự xuất hiện nhờ xếp hạng lại. Mã định danh có thể cần một nhánh tra chính xác riêng, thay vì hy vọng tìm gần nghĩa xử lý mọi truy vấn.
Khi nào cần thêm máy, khi nào cần đổi cách đo?
Ban đầu, PostgreSQL cùng pgvector có thể giúp giữ nội dung, điều kiện và giao dịch trong một hệ. Đây là lựa chọn để thử nếu nó đáp ứng tải và yêu cầu vận hành, không phải cam kết rằng mọi quy mô đều vừa. Hệ chuyên dụng đáng cân nhắc khi đo đạc cho thấy cần cách quản lý chỉ mục, phân phối tải hoặc vận hành mà kiến trúc hiện tại khó đáp ứng.
Chia mảnh (sharding) là chia kho thành nhiều phần, như nhiều chi nhánh thư viện. Nếu biết doanh nghiệp nào chứa tài liệu, có thể định tuyến tới phần tương ứng. Doanh nghiệp lớn có thể cần nhiều mảnh; gom mọi khách hàng theo cách thiếu cân nhắc cũng dễ tạo một máy quá tải còn máy khác rảnh.
Nếu phải hỏi nhiều mảnh, bộ điều phối thu ứng viên rồi gộp. Với cùng thước đo và tìm chính xác, top k mỗi mảnh đủ để gộp thành top k toàn cục, nếu xử lý hòa điểm nhất quán. Nhưng ANN ở mỗi mảnh có thể bỏ sót, và lọc sau ở mỗi mảnh có thể trả thiếu. Thêm mảnh không tự sửa được hai lỗi đó; thời gian toàn truy vấn còn chịu ảnh hưởng của mảnh chậm nhất.
Bản sao (replica) giống bản kho đặt ở chi nhánh dự phòng, giúp phục vụ tải hoặc chịu lỗi tùy thiết kế. Đổi lại, chúng tốn chỗ và có thể chưa nhận cùng một cập nhật. Cần xác định lúc nào một ghi được xác nhận, lúc nào tìm thấy được và khi đọc sang bản sao khác có thể thấy gì. Có bản sao cũng chưa thay thế bản sao lưu và diễn tập phục hồi.
Đo chất lượng phải tách hai sổ điểm. ANN recall@k là phần hàng xóm chuẩn mà tìm gần đúng lấy lại được, như đối chiếu mười cuốn nó lấy với mười cuốn gần nhất khi kiểm hết kệ. Đáp án chuẩn phải tính trên cùng tập đủ điều kiện, cùng phiên bản và cùng thước đo, không phải top k toàn kho trước khi lọc.
Sổ còn lại là bộ câu hỏi được đánh giá về mức hữu ích: đoạn đúng chính sách có xuất hiện không, có đứng đủ cao không, có đủ ngữ cảnh không. ANN recall cao chỉ chứng minh thuật toán gần với phép đo khoảng cách đã chọn. Nó không chứng minh embedding hiểu tốt câu hỏi, càng không chứng minh câu trả lời sau đó đúng.
Khi kiểm tải, theo dõi cả thời gian tạo vector câu hỏi, lấy ứng viên, lọc, xếp hạng lại và đọc nội dung. Tách số liệu theo doanh nghiệp lớn nhỏ, điều kiện lọc rộng hẹp và truy vấn có mã. Theo dõi tỷ lệ trả thiếu, độ trễ cập nhật, lỗi phiên bản và số lần chặn kết quả ngoài quyền. Một con số thời gian trung bình có thể che hết những nhóm đang gặp lỗi.
Tự tay chạy: xếp hạng đúng nhưng vẫn trả thiếu
Đoạn Python dưới dùng numpy và matplotlib. Nó tạo 10.000 vector 24 chiều, chuẩn hóa độ dài, rồi xếp toàn kho bằng tích vô hướng. Với các vector đã chuẩn hóa này, thứ tự ấy cũng là thứ tự cosine. Cứ mỗi 20 bản ghi có một bản được phép xem, độc lập với tọa độ giả lập.
Đáp án chuẩn là mười vector gần nhất trong 500 bản ghi được phép. Chương trình thử lấy dư ứng viên toàn kho rồi mới lọc. Nó cố tình không dùng HNSW hay IVF để tách riêng lỗi thứ tự lọc khỏi sai số ANN. Chạy từ thư mục gốc EyeBlogs sẽ xuất hình đã dùng ở trên.
from pathlib import Pathimport numpy as npimport matplotlibmatplotlib.use("Agg")import matplotlib.pyplot as plt
rng = np.random.default_rng(2026)x = rng.normal(size=(10_000, 24))x /= np.linalg.norm(x, axis=1, keepdims=True)q = rng.normal(size=24)q /= np.linalg.norm(q)
allowed = np.zeros(len(x), dtype=bool)allowed[::20] = True  # Chính xác 5% bản ghi được phép xem.order = np.argsort(-(x @ q), kind="stable")k = 10truth = order[allowed[order]][:k]rows = []for budget in [10, 50, 100, 200, 500]:    candidates = order[:budget]    hits = candidates[allowed[candidates]][:k]    recall = len(set(hits) & set(truth)) / len(truth)    rows.append([str(budget), str(len(hits)), f"{recall:.0%}"])    print(f"Lấy {budget:3} ứng viên: còn {len(hits):2}, khớp {recall:.0%}")
# Bảng đơn sắc: mọi giá trị đều đọc trực tiếp, không mã hóa bằng màu.surface, ink, muted = "#fcfcfb", "#0b0b0b", "#52514e"plt.rcParams.update({"font.family": "DejaVu Sans", "font.size": 14})fig, ax = plt.subplots(figsize=(11, 5.7), dpi=160, facecolor=surface)ax.set_axis_off()table = ax.table(    cellText=rows,    colLabels=["Ứng viên toàn kho", "Còn sau lọc (tối đa 10)", "Khớp top 10 hợp lệ"],    cellLoc="center", colLoc="center", bbox=[0.02, 0.14, 0.96, 0.70],)table.auto_set_font_size(False)table.set_fontsize(13)for (row, col), cell in table.get_celld().items():    cell.set_facecolor(surface)    cell.set_edgecolor("#e1e0d9")    cell.set_linewidth(0.8)    cell.set_text_props(color=ink, weight="bold" if row == 0 else "normal")fig.suptitle("Tìm đúng khoảng cách, vẫn thiếu kết quả", y=0.95,             fontsize=21, color=ink, weight="bold")fig.text(0.5, 0.84, "10.000 vector giả lập · 500 được phép xem · cần 10 kết quả",         ha="center", fontsize=13, color=muted)fig.text(0.5, 0.075, "Xếp hạng toàn kho chính xác, rồi mới lọc quyền.",         ha="center", color=muted, fontsize=13)fig.text(0.5, 0.025, "Seed 2026 · Không phải benchmark ANN hay dữ liệu embedding thật",         ha="center", color=muted, fontsize=11)out = Path("images/vector-database")out.mkdir(parents=True, exist_ok=True)fig.savefig(out / "loc-ung-vien.png", facecolor=surface)plt.close(fig)
Kết quả lần lượt còn 0, 2, 5, 10 và 10 bản ghi. Ở lần chạy này, lấy 200 ứng viên đã thu đủ top 10 hợp lệ. Không thể suy ra quy tắc “lấy dư 20 lần là đủ”: đổi seed, tỷ lệ quyền hoặc tương quan giữa quyền và chủ đề sẽ đổi kết quả.
Trong phép thử này, đã tính khoảng cách và sắp toàn bộ dữ liệu trước khi cắt ứng viên. Vì vậy bảng chỉ chứng minh cắt ứng viên trước khi lọc có thể làm mất đáp án, không chứng minh lấy 200 nhanh hơn quét 500 bản ghi hợp lệ. Muốn chọn cấu hình thật, phải chạy trên chỉ mục thật với tải và bộ lọc thật.
Trở lại câu hỏi “bao lâu nhận lại tiền?”
Ô tìm kiếm tốt không chỉ nhận ra “nhận lại tiền” gần với “hoàn tiền”. Nó còn biết nhân viên đang hỏi trong kho nào, quy định nào còn hiệu lực và những đoạn nào họ được đọc. Nếu chưa xác minh được quyền, không có kết quả còn tốt hơn một trích đoạn không được phép xuất hiện.
Vector database làm cho một kiểu tra cứu mới trở nên khả thi. Nhưng việc đưa đúng tài liệu tới đúng người vẫn là bài toán của cả hệ thống. Mô hình tạo tọa độ, chỉ mục tìm ứng viên, luồng cập nhật giữ phiên bản. Phép đo cuối cùng kiểm xem người đọc có thực sự nhận được câu trả lời.
Vẽ minh họa hình học miễn phí cho học sinh và giáo viên: EyeViz.
Tài liệu tham khảo
- [1]pgvector: Indexing, Filtering, Multitenancy and Iterative Index Scans. pgvector.
- [2]Yu. A. Malkov và D. A. Yashunin. Efficient and robust approximate nearest neighbor search using Hierarchical Navigable Small World graphs. IEEE Transactions on Pattern Analysis and Machine Intelligence, 2020.
- [3]Vectors: Named vectors. Qdrant Documentation.
- [4]Hybrid and Multi-Stage Queries. Qdrant Documentation.