Inverted index: tìm tài liệu mà không đọc cả kho
Inverted index giúp ô tìm kiếm tra từ ra tài liệu. Từ ví dụ cà phê sữa, thiết kế luồng cập nhật, chia dữ liệu, xếp hạng và kiểm soát quyền truy cập.
Mục lục
Bạn nhớ công ty có một tài liệu hướng dẫn hoàn tiền, nhưng không nhớ ai viết hay lưu ở đâu. Bạn gõ “hoàn tiền” vào ô tìm kiếm. Nếu mỗi lần như vậy, hệ thống phải mở từng tài liệu để đọc, kho càng lớn thì công việc càng nhiều.
Chỉ mục đảo (inverted index) giải quyết bằng cách chuẩn bị một cuốn sổ tra ngược: mỗi từ đi kèm danh sách tài liệu chứa nó. Thay vì hỏi “tài liệu này có những từ nào?”, hệ thống hỏi “từ này nằm trong những tài liệu nào?”. Nó giống phần tra cứu cuối sách: tìm tên một chủ đề trước, rồi mới mở những trang được chỉ tới.
Nhưng cuốn sổ ấy mới giải quyết bước tìm ứng viên. Muốn thiết kế cả hệ thống tìm kiếm, ta còn phải trả lời: ai cập nhật sổ, khi nào thấy bản mới, chia sổ cho nhiều máy thế nào, và làm sao không đưa tài liệu riêng cho nhầm người.
Inverted index đảo ngược điều gì?
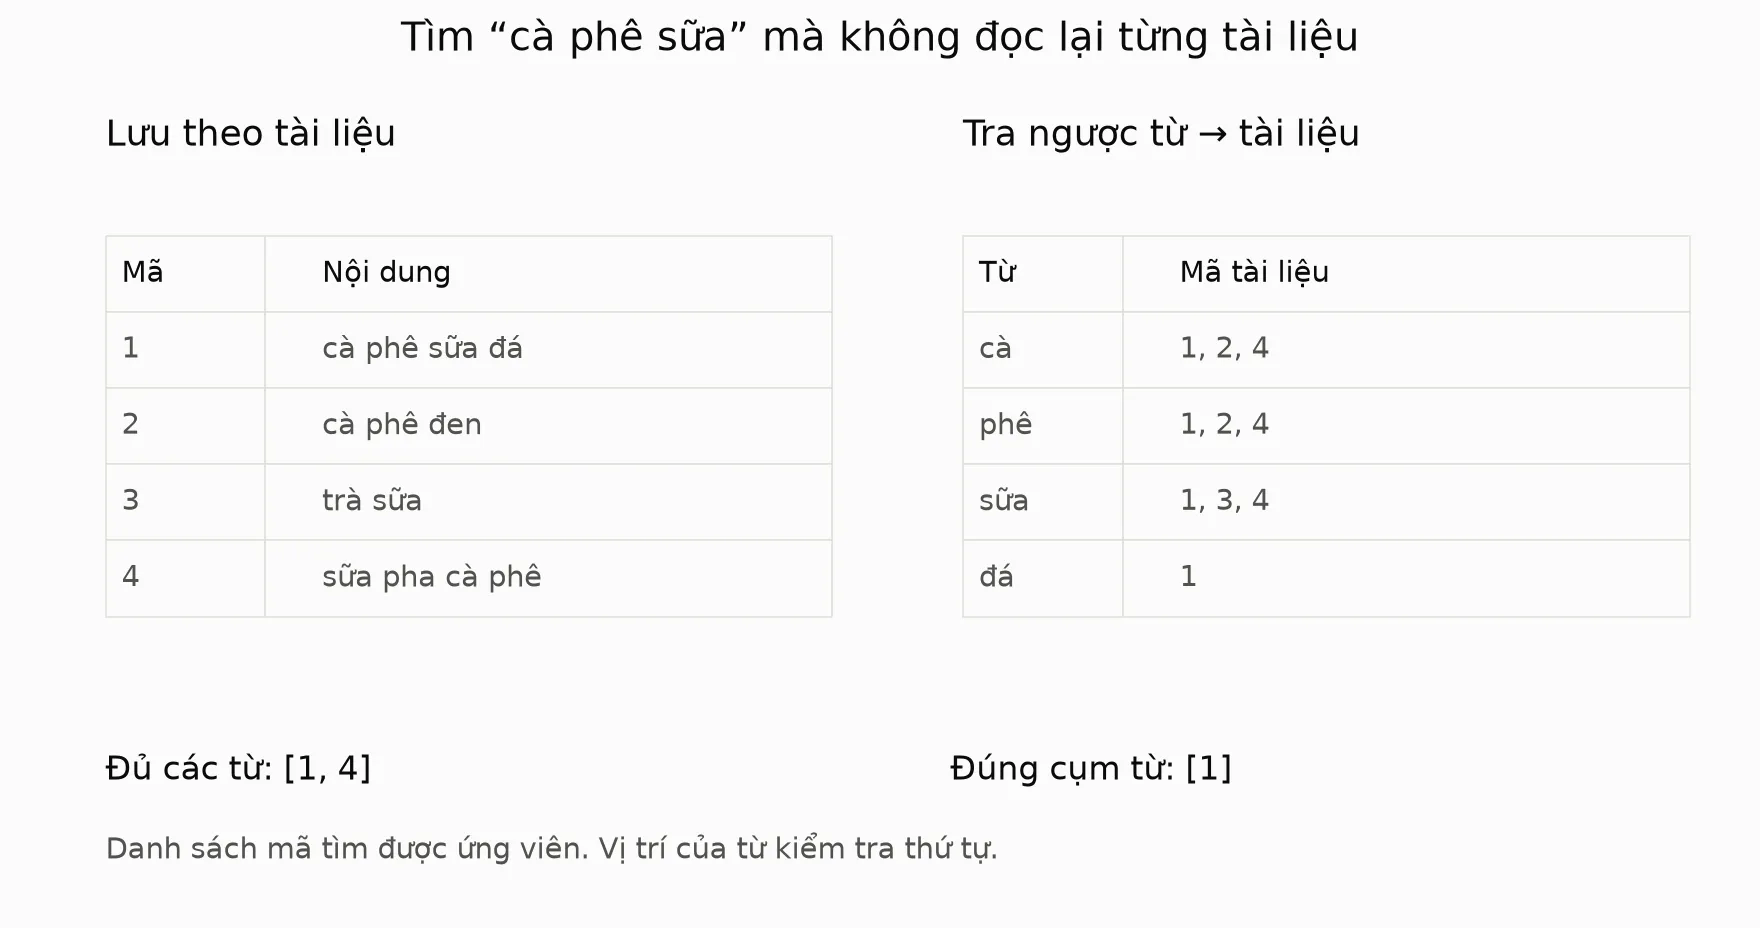
Thử thu nhỏ kho tài liệu thành bốn dòng thực đơn. Những con số trong ví dụ là dữ liệu minh họa, không phải số liệu của một dịch vụ thật.
| Mã tài liệu | Nội dung |
|---|---|
| 1 | cà phê sữa đá |
| 2 | cà phê đen |
| 3 | trà sữa |
| 4 | sữa pha cà phê |
Cách lưu thông thường đi từ mã tài liệu tới nội dung. Chỉ mục đảo bổ sung chiều ngược lại:
| Từ | Danh sách mã tài liệu chứa từ |
|---|---|
| cà | 1, 2, 4 |
| phê | 1, 2, 4 |
| sữa | 1, 3, 4 |
| đá | 1 |
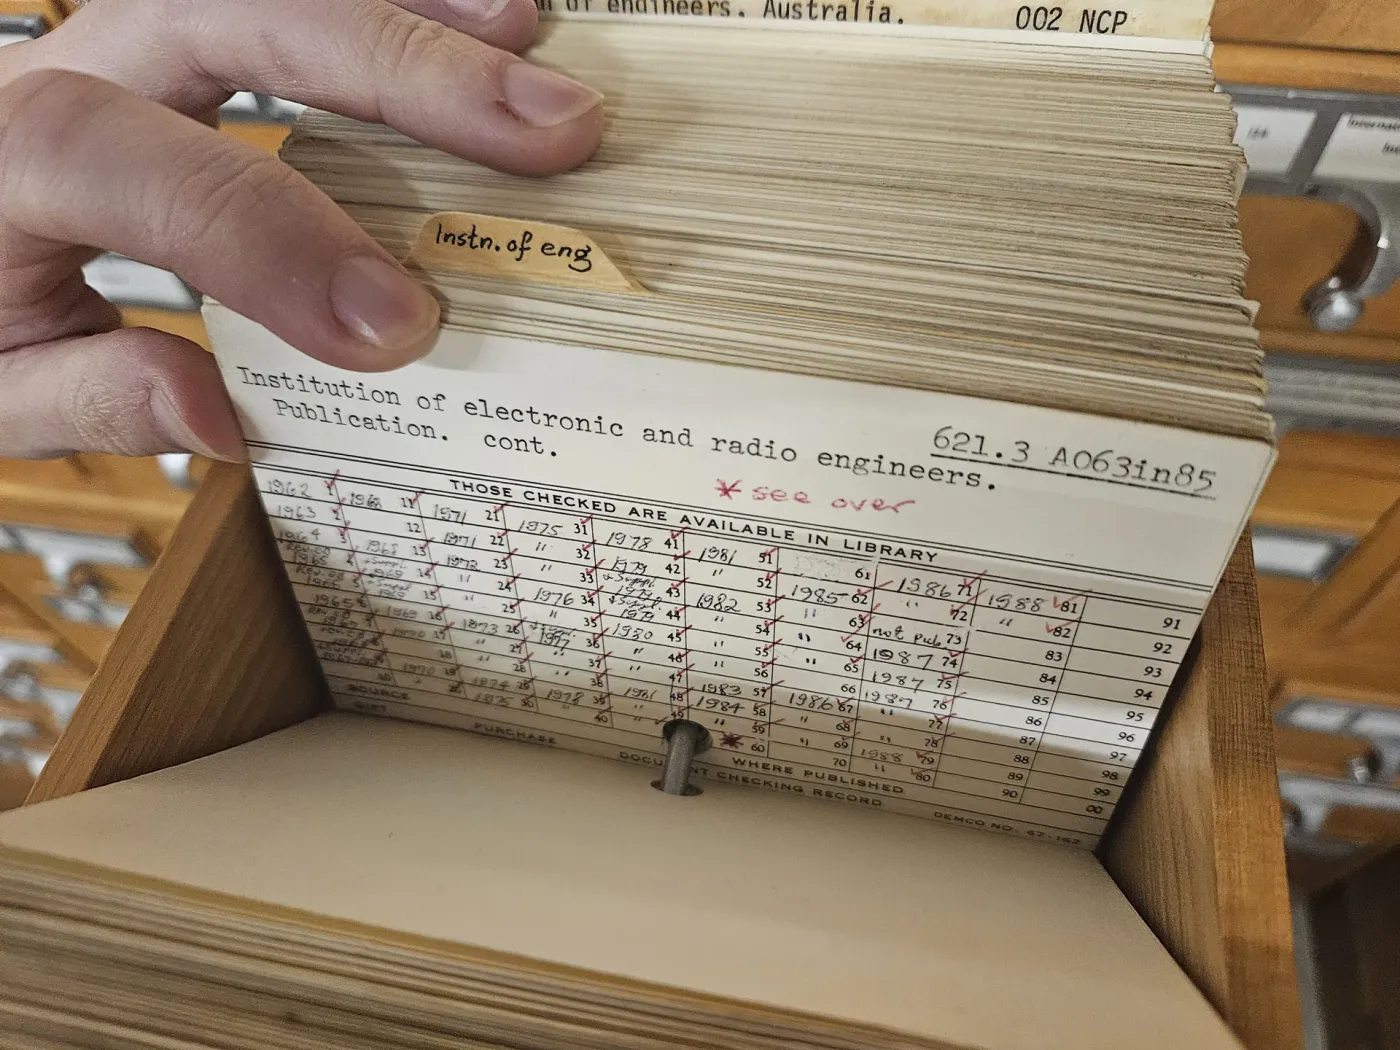
Mỗi danh sách ấy gọi là posting list, như một tờ giấy ghi các số trang cần mở. Phần chứa các từ để tra gọi là từ điển của chỉ mục, giống các nhãn trong tủ phiếu thư viện. PostgreSQL cũng mô tả chỉ mục GIN cho tìm kiếm văn bản theo nguyên lý này: mỗi từ có mục chỉ dẫn tới các bản ghi phù hợp[1].
Nếu người dùng muốn đủ ba từ “cà”, “phê”, “sữa”, ta giữ những mã có mặt trong cả ba danh sách. Kết quả là tài liệu 1 và 4. Đây là phép giao, giống chọn những người vừa có tên trong danh sách đăng ký, vừa có tên trong danh sách đã thanh toán.
Nếu chấp nhận chỉ cần một trong các từ, ta lấy phép hợp: gom các mã xuất hiện ở bất kỳ danh sách nào. Hai quy tắc cho kết quả khác nhau. Ô tìm kiếm cần chọn cách hiểu, chứ cấu trúc dữ liệu không tự quyết định hộ sản phẩm.
Vì sao “sữa pha cà phê” chưa phải “cà phê sữa”?
Chỉ biết các từ cùng xuất hiện chưa đủ để biết thứ tự. Tài liệu 4 chứa đủ từ, nhưng không chứa nguyên cụm “cà phê sữa”. Đây là khác biệt giữa tìm đủ từ và tìm đúng cụm từ.
Ta có thể ghi thêm vị trí của từ, giống ghi cả số trang lẫn dòng trong cuốn sổ tra cứu. Đánh số từ từ 0, tài liệu 1 có “cà” ở 0, “phê” ở 1 và “sữa” ở 2. Ba vị trí liên tiếp đúng thứ tự, nên nó chứa cụm cần tìm. Trong tài liệu 4, “sữa” lại đứng trước “cà”.
Ghi thêm vị trí tốn chỗ và công cập nhật. Đổi lại, hệ thống kiểm tra được cụm từ, mức gần nhau và một số kiểu truy vấn khác. Muốn tìm được gì thì phải giữ đủ thông tin cho việc đó, không chỉ giữ một tập mã rồi hy vọng suy ra mọi thứ.
Ô tìm kiếm phải hứa điều gì trước khi chọn máy chủ?
Quay lại kho tài liệu công ty. Trước khi chọn công cụ, hãy chốt một hợp đồng nhỏ với người dùng. Trong thiết kế minh họa này, ô tìm kiếm trả tài liệu theo từ khóa, cho lọc phòng ban và chỉ hiển thị nội dung người dùng được phép xem.
Giả sử mục tiêu đặt ra là: tài liệu sửa xong xuất hiện trong tìm kiếm sau tối đa 5 giây trong điều kiện vận hành bình thường; 95% truy vấn hoàn thành trong 300 mili giây ở mức tải đã thống nhất. Đây là mục tiêu giả định để thiết kế và kiểm thử, không phải kết quả đo hay cam kết của Elasticsearch.
Quyền truy cập cần một lời hứa riêng. Chậm thấy một đoạn văn mới có thể chấp nhận được. Tiếp tục lộ đoạn trích sau khi quyền xem bị thu hồi thì không thể coi là cùng loại chậm trễ.
Cũng cần phân biệt hai việc: tìm được mọi tài liệu có chữ “hoàn tiền”, và đưa hướng dẫn hoàn tiền đúng lên đầu. Cái đầu là điều kiện khớp; cái sau là chất lượng xếp hạng. Một hệ thống trả nhanh nhưng toàn kết quả sai ý vẫn chưa đạt yêu cầu.
Một cuốn sổ tra cứu nằm ở đâu trong kiến trúc?
Thiết kế khởi đầu nên có ít thành phần nhất đáp ứng yêu cầu. Hãy tách hai đường đi: cập nhật tài liệu và tìm kiếm tài liệu.
| Đường đi | Các bước trong thiết kế minh họa |
|---|---|
| Ghi | Người dùng sửa → lưu tài liệu và sự kiện thay đổi → bộ lập chỉ mục đọc sự kiện → cập nhật chỉ mục |
| Đọc | Người dùng tìm → xác thực và xác định phạm vi quyền → phân tích câu tìm → tra chỉ mục, lọc và xếp hạng → kiểm tra quyền hiện hành trước khi trả nội dung |
Bộ lập chỉ mục (indexer) giống người thủ thư cập nhật tủ phiếu khi có sách mới. Nó đọc văn bản, tách các đơn vị để tìm và ghi lại những tài liệu tương ứng. Phần tìm kiếm sử dụng cuốn sổ đã chuẩn bị ấy, thay vì tự xây lại mỗi lần có câu hỏi.
Trong kiến trúc đang xét, kho tài liệu gốc giữ nội dung và phiên bản chính thức. Chỉ mục là dữ liệu suy ra, có thể xây lại từ nguồn. Giống tủ phiếu bị hỏng thì còn sách để làm lại, nhưng không nên vì vậy mà xem việc làm lại là miễn phí.
Ta không nhất thiết cần một cụm tìm kiếm riêng ngay từ đầu. PostgreSQL có tìm kiếm toàn văn và chỉ mục GIN[1]. Nếu nhu cầu còn gọn, dùng chung cơ sở dữ liệu có thể giảm việc đồng bộ và vận hành. Chọn công cụ riêng khi các yêu cầu về tìm kiếm, tải hoặc cách mở rộng thực sự cần nó.
Cũng đừng mặc định mọi câu lệnh tìm trong SQL đều quét hết dữ liệu. Khả năng dùng chỉ mục phụ thuộc kiểu truy vấn và loại chỉ mục. Điều cần bỏ là việc đọc lại toàn bộ văn bản cho mọi lần tìm, không phải bỏ cơ sở dữ liệu quan hệ.
“Cà phê” là một từ hay hai từ?
Người Việt nhận ra “cà phê” là một cụm có nghĩa. Máy chỉ thấy chuỗi ký tự. Nếu tách theo dấu cách, nó nhận “cà” và “phê” riêng; điều đó vẫn tạo được chỉ mục, nhưng không tương đương hiểu các từ ghép tiếng Việt.
Phân tích văn bản (text analysis) giống thống nhất cách ghi tên trong sổ khách hàng: “LAN” và “Lan” có được tính là một không? Quy trình thường gồm tách văn bản thành đơn vị tìm kiếm, gọi là token, rồi chuẩn hóa chúng. Elastic mô tả các bước này ở cả lúc lập chỉ mục và lúc tìm[2].
Kho được ghi theo một cách, câu hỏi được đọc theo cách không tương thích, thì một từ nhìn giống nhau vẫn có thể không khớp. Tuy nhiên, không bắt buộc hai phía dùng quy tắc giống hệt: chẳng hạn, hệ thống có thể mở rộng từ đồng nghĩa lúc tìm. Điều bắt buộc là hiểu chúng phối hợp ra sao.
Với tiếng Việt, hạ chữ hoa thành chữ thường thường dễ giải thích. Bỏ dấu lại là một lựa chọn sản phẩm. “Ma”, “má”, “mã” có thể bị nhập làm một; tiện cho người gõ không dấu nhưng có thể làm kết quả kém chính xác.
Một cách là giữ trường có dấu để khớp chính xác, thêm trường không dấu để hỗ trợ và cho điểm thấp hơn. Mã tài liệu thì cần quy tắc khác: mã “HD-001” giống số căn cước của tài liệu, không nên bị xử lý như câu văn. Không có một bộ tách từ phù hợp mọi trường dữ liệu.
Lưu xong rồi, sao tìm vẫn chưa thấy?
Tài liệu gốc và chỉ mục là hai nơi khác nhau. Lưu thành công ở nơi thứ nhất không chứng minh nơi thứ hai đã cập nhật.
Giả sử ứng dụng làm hai việc rời nhau: lưu tài liệu rồi gửi thông báo cho indexer. Nếu ứng dụng ngừng chạy đúng giữa hai bước, tài liệu mới có thể không bao giờ được lập chỉ mục. Gửi thông báo trước cũng không giải quyết được, vì bước lưu phía sau có thể thất bại.
Một cách thiết kế là hộp thư giao dịch (transactional outbox): lưu tài liệu và một dòng “cần cập nhật chỉ mục” trong cùng giao dịch cơ sở dữ liệu. Giống quầy tiếp nhận chỉ đóng dấu hoàn tất khi cả hồ sơ lẫn phiếu chuyển việc đã được ghi. Một tiến trình khác chuyển các phiếu đã lưu sang bộ lập chỉ mục.
Cách này xử lý khoảng hở giữa lưu dữ liệu và ghi nhận việc cần làm. Nó không có nghĩa mọi thông báo chỉ đến đúng một lần. Tiến trình có thể gửi xong rồi ngừng chạy trước khi ghi nhận đã gửi, nên lần sau gửi lại.
Ta dùng mã tài liệu ổn định và phiên bản tăng dần. Bản số 8 được gửi lại thì không tạo tài liệu thứ hai; bản số 7 đến muộn không được ghi đè bản số 8. Đây là cùng tinh thần của idempotency khi chuyển tiền: xử lý lại mà không nhân đôi hậu quả.
Việc xóa cũng cần giữ dấu phiên bản đủ lâu, như để lại phiếu “hồ sơ đã rút” thay vì xóa cả dấu vết. Nếu không, thông báo cũ đến muộn có thể đưa tài liệu trở lại. Thời gian giữ dấu phải phù hợp khả năng phát lại và độ trễ của luồng sự kiện.
Đến chỉ mục rồi cũng chưa chắc tra được ngay
Trong Elasticsearch, thao tác refresh làm các thay đổi mới khả dụng cho tìm kiếm. Cơ chế này liên quan tới việc mở những phần chỉ mục mới để đọc, không phải cứ nhận một lần ghi là mọi truy vấn lập tức thấy nó[3].
Có thể hình dung thủ thư đã ghi xong một tập phiếu mới nhưng chưa đặt tập ấy vào ngăn tra cứu. Nhận ghi, nhìn thấy khi tìm, và lưu bền vững là những mốc khác nhau. Không nên dùng một thông báo “thành công” để thay cho cả ba.
Ép làm mới liên tục có thể đổi độ trễ lấy chi phí lập chỉ mục. Với mục tiêu giả định 5 giây, cần đo cả thời gian chờ chuyển sự kiện, chờ indexer và chờ thấy qua truy vấn thật. Một dòng báo “đã gửi” chưa đo hết đường đi.
Bên trong Lucene, dữ liệu chỉ mục được giữ trong các segment bất biến, giống những tập phiếu đã đóng thành quyển, không sửa từng dòng tại chỗ. Các tập nhỏ được gộp dần thành tập lớn; quá trình gộp còn loại bỏ dữ liệu đã đánh dấu xóa[6]. Vì vậy, tài liệu không còn được trả về khi tìm chưa chắc đã được thu hồi hết dung lượng trên đĩa.
Việc gộp cần đọc và ghi dữ liệu, cạnh tranh tài nguyên với tìm kiếm và lập chỉ mục. Refresh quá dày có thể tạo nhiều tập nhỏ cần gộp hơn. Đây là lý do một lựa chọn tưởng chỉ liên quan tới “thấy bản mới nhanh hơn” còn ảnh hưởng tới tải ghi và dung lượng trống.
Kho lớn lên, chia theo từ hay theo tài liệu?
Cuốn sổ quá lớn thì cần chia nhỏ. Phân mảnh (sharding) giống chia kho sách cho nhiều phòng: mỗi phòng giữ một phần dữ liệu và có thể làm việc song song.
Ta có hai hướng dễ nghĩ tới. Chia theo từ thì phòng A giữ các từ đầu bảng chữ cái, phòng B giữ các từ tiếp theo. Chia theo tài liệu thì phòng A giữ một nhóm tài liệu, phòng B giữ nhóm khác; mỗi phòng có chỉ mục riêng cho phần mình.
| Cách chia | Thuận lợi | Điều phải trả giá |
|---|---|---|
| Theo từ | Biết từ nào thì biết nơi tra danh sách của từ đó | Câu hỏi nhiều từ có thể cần trao đổi danh sách giữa các máy; từ phổ biến dễ tạo điểm nóng |
| Theo tài liệu | Mỗi mảnh tự tìm và xếp hạng trong phần tài liệu mình | Truy vấn có thể phải hỏi nhiều mảnh rồi gom kết quả |
Với kho đang xét, ta chọn chia theo tài liệu. Một bộ điều phối giống thủ thư trưởng: gửi cùng câu hỏi tới các phòng liên quan, nhận ứng viên rồi chọn kết quả chung. Elasticsearch cũng tổ chức việc đọc qua các shard và một nút điều phối kết quả[4].
Không nhất thiết gửi tới mọi mảnh nếu đã biết phạm vi hẹp hơn. Chẳng hạn, định tuyến theo công ty khách hàng giúp chỉ hỏi nơi giữ dữ liệu của công ty đó. Đổi lại, một khách hàng lớn có thể chiếm quá nhiều tải. Chia đều số khách hàng không bảo đảm chia đều công việc.
Bài consistent hashing bàn thêm về chuyện ánh xạ dữ liệu sang máy. Ở đây, điều quan trọng hơn là chọn đơn vị chia phù hợp cách tìm. Một phép băm không tự giải quyết truy vấn phải hỏi bao nhiêu nơi.
Bản sao không phải một phần dữ liệu mới
Bản sao (replica) giống một tủ phiếu dự phòng chứa cùng phần sách, khác với mảnh giữ phần sách khác. Bản sao giúp chia lượt đọc và có nơi thay thế khi máy gặp sự cố. Nó cũng cần được cập nhật, nên tốn dung lượng và công ghi[4].
Thêm bản sao có thể tăng khả năng phục vụ đọc. Thêm mảnh giúp phân chia dữ liệu và công việc. Hai thao tác không thay thế nhau, và thêm quá nhiều mảnh cũng tăng chi phí điều phối.
Nếu một mảnh không trả lời, hệ thống phải chọn: báo không hoàn thành hoặc trả phần kết quả đã có kèm thông báo thiếu. Không nên âm thầm hiển thị “không tìm thấy” khi thực ra chưa hỏi hết kho. Tài liệu Elastic lưu ý một phản hồi tìm kiếm vẫn có thể mang mã thành công HTTP trong khi chỉ chứa kết quả một phần[4].
Tìm đúng từ rồi, tài liệu nào lên đầu?
Một hướng dẫn hoàn tiền ngắn và một bản tổng hợp dài đều có chữ “hoàn tiền”. Khớp từ chưa đủ để chọn thứ hữu ích hơn.
Xếp hạng (ranking) giống chọn cuốn sách nên đưa trước trong số sách có cùng chủ đề. Một cách chấm điểm phổ biến là BM25, cũng là lựa chọn mặc định được tài liệu Elasticsearch mô tả[5]. Trực giác của nó là cân nhắc từ hiếm hay phổ biến, số lần xuất hiện và độ dài văn bản; lặp từ nhiều thêm không được cộng điểm mãi theo tỷ lệ thẳng.
Ta cũng có thể cho từ khớp trong tiêu đề trọng số cao hơn từ khớp trong thân bài, như ưu tiên sách có đúng chủ đề ghi trên bìa. Nhưng đây là giả thuyết cần kiểm thử bằng các câu hỏi thực tế, không phải quy tắc luôn đúng.
Khi chia nhiều mảnh, điểm còn phụ thuộc thống kê được dùng. Một từ hiếm ở mảnh này chưa chắc hiếm trong cả kho. Muốn so sánh điểm tốt hơn có thể cần thêm bước thu thập thống kê; đổi lại là thêm trao đổi giữa các máy.
Giả sử cần 10 kết quả và điểm đã có thể so sánh thống nhất. Mỗi mảnh lấy 10 kết quả tốt nhất, bộ điều phối gộp chúng rồi chọn 10 kết quả chung. Cách đó không còn đủ một cách máy móc nếu phía sau còn loại tài liệu theo quyền hoặc đổi cách chấm điểm. Khi có bước lọc sau, phải biết lấy thêm ứng viên hoặc tiếp tục tìm.
Vì vậy, nên áp dụng những điều kiện lọc đã biết ngay trong truy vấn. Lấy 10 tài liệu trước rồi bỏ 9 tài liệu không đúng phòng ban không tương đương tìm 10 tài liệu tốt nhất của phòng ban ấy.
Quyền truy cập có được chậm như nội dung không?
Một tài liệu bị thu hồi quyền nhưng chỉ mục chưa biết. Nếu hệ thống trả tiêu đề và đoạn trích từ chỉ mục cũ, nội dung đã lộ trước khi người dùng bấm mở.
Trong thiết kế này, phạm vi công ty và quyền xem được dùng để lọc ứng viên. Trước khi trả tiêu đề, đoạn trích và đường dẫn, dịch vụ còn kiểm tra quyền hiện hành ở nguồn được chọn làm căn cứ. Nếu kiểm tra thất bại, không trả nội dung đó. Không đợi tới lúc mở tài liệu mới kiểm tra.
Giới hạn của cách này cần nói rõ: bộ lọc quyền cũ có thể bỏ sót tài liệu vừa được cấp quyền. Để không lộ thống kê, các số đếm, gợi ý và thông tin phụ cũng phải tuân theo cùng chính sách; không thể chỉ bảo vệ danh sách kết quả.
Nếu lưu lại kết quả để trả nhanh lần sau, khóa lưu phải phân biệt phạm vi tài khoản và quyền phù hợp. Chuyện này nối với bài cache và những bản sao chưa kịp đổi. Chậm cập nhật một bức ảnh và chậm cập nhật quyền xem không có cùng mức rủi ro.
Chỉ mục đảo tiết kiệm gì, và không tiết kiệm gì?
Gần cuối bài mới cần nhìn vào thuật toán. Với hai danh sách mã đã sắp tăng dần, ta có thể dùng hai con trỏ: mã nào nhỏ hơn thì tiến ở phía đó, bằng nhau thì giữ lại. Giống đối chiếu hai danh sách khách mời đã xếp theo số thứ tự.
Nếu độ dài hai danh sách là và , phép giao đơn giản mất tối đa số bước tỷ lệ với . Với nhiều từ, xét danh sách ngắn trước có thể giúp thu hẹp ứng viên sớm. Cấu trúc thực tế còn có cách nhảy qua đoạn không cần đọc và nén danh sách.
Chỉ mục đảo không biến mọi câu tìm thành một lần tra có chi phí cố định. Một từ xuất hiện khắp kho vẫn có danh sách dài. Đúng cụm từ cần xét vị trí; xếp hạng, lọc quyền và đọc nội dung đều có chi phí riêng.
Lợi ích chính là chuyển công việc từ lúc tìm sang lúc chuẩn bị. Ta trả thêm dung lượng, công lập chỉ mục và đồng bộ để bớt đọc văn bản lặp lại. Muốn ghi thêm một tài liệu, hệ thống phải cập nhật nhiều mục từ, chứ không chỉ thêm một hàng tên tài liệu.
Khi đổi quy tắc tách từ, ta có thể phải xây lại chỉ mục. Cách triển khai an toàn hơn là xây một bản mới bên cạnh bản cũ, theo kịp các cập nhật trong lúc xây, kiểm tra rồi chuyển nơi phục vụ. Giống làm tủ phiếu mới mà thư viện vẫn mở cửa, phần khó là không bỏ sót sách vừa nhập trong thời gian ấy.
Theo dõi vận hành cũng nên đi theo lời hứa ban đầu: độ trễ từ sửa tới tìm thấy, thời gian truy vấn ở nhóm chậm, số lần trả thiếu mảnh và chất lượng các kết quả đầu. Chạy thử thêm lúc xây lại chỉ mục hoặc khi một bản sao ngừng hoạt động. Đo mỗi thời gian tra một từ trong bộ nhớ chưa đủ để kết luận cả hệ thống đáp ứng yêu cầu.
Tự tay dựng cuốn sổ tra ngược
Đoạn Python sau tạo chỉ mục từ đúng bốn tài liệu đầu bài. Mỗi mục giữ mã tài liệu và vị trí xuất hiện. Chương trình kiểm tra tìm đủ từ, kiểm tra đúng cụm từ, rồi xuất hình 1 vào kho ảnh. Chỉ cần thư viện matplotlib; dữ liệu cố định nên không cần số ngẫu nhiên.
Đây là mô hình để thấy cơ chế, không có luồng cập nhật, phân mảnh hay chấm điểm BM25. Nó cũng chỉ tách theo khoảng chữ, chưa phải bộ tách từ tiếng Việt. Chạy từ thư mục gốc blog để ảnh được lưu đúng vị trí.
from collections import defaultdictfrom pathlib import Pathimport reimport unicodedata
import matplotlibmatplotlib.use("Agg")import matplotlib.pyplot as plt

def tokens(text):    # Giữ dấu tiếng Việt; đây chỉ là cách tách theo khoảng chữ.    return re.findall(r"\w+", unicodedata.normalize("NFC", text).lower())

docs = {    1: "cà phê sữa đá",    2: "cà phê đen",    3: "trà sữa",    4: "sữa pha cà phê",}index = defaultdict(dict)for doc_id, text in docs.items():    for position, term in enumerate(tokens(text)):        index[term].setdefault(doc_id, []).append(position)
query = tokens("cà phê sữa")candidates = set.intersection(*(set(index.get(t, {})) for t in query))phrase_hits = []for doc_id in sorted(candidates):    starts = index[query[0]][doc_id]    if any(all(p + i in index[t][doc_id] for i, t in enumerate(query))           for p in starts):        phrase_hits.append(doc_id)print("Đủ các từ:", sorted(candidates))print("Đúng cụm từ:", phrase_hits)
# Sơ đồ xuất từ chính các danh sách đã tính, không dùng dữ liệu ngẫu nhiên.surface, ink, muted = "#fcfcfb", "#0b0b0b", "#52514e"plt.rcParams.update({"font.family": "DejaVu Sans", "font.size": 13})fig, axes = plt.subplots(1, 2, figsize=(11, 5.8), facecolor=surface)rows = [([[str(i), text] for i, text in docs.items()], ["Mã", "Nội dung"]),        ([[t, ", ".join(map(str, sorted(index[t])))]          for t in ["cà", "phê", "sữa", "đá"]], ["Từ", "Mã tài liệu"])]for ax, (data, headers), title in zip(    axes, rows, ["Lưu theo tài liệu", "Tra ngược từ → tài liệu"]):    ax.axis("off")    ax.set_title(title, loc="left", color=ink, fontsize=16, pad=18)    table = ax.table(cellText=data, colLabels=headers, cellLoc="left",                     colLoc="left", bbox=[0, 0.14, 1, 0.76], colWidths=[0.22, 0.78])    table.auto_set_font_size(False)    table.set_fontsize(13)    for (r, c), cell in table.get_celld().items():        cell.set_facecolor(surface)        cell.set_edgecolor("#e1e0d9")        cell.set_text_props(color=ink if r == 0 else muted)        cell.set_linewidth(0.7)fig.suptitle("Tìm “cà phê sữa” mà không đọc lại từng tài liệu", color=ink,             fontsize=18, y=0.98)fig.text(0.06, 0.16, f"Đủ các từ: {sorted(candidates)}", color=ink, fontsize=15)fig.text(0.54, 0.16, f"Đúng cụm từ: {phrase_hits}", color=ink, fontsize=15)fig.text(0.06, 0.075, "Danh sách mã tìm được ứng viên. Vị trí của từ kiểm tra thứ tự.",         color=muted, fontsize=13)fig.subplots_adjust(top=0.80, bottom=0.26, left=0.06, right=0.96, wspace=0.18)out = Path("images/inverted-index")out.mkdir(parents=True, exist_ok=True)fig.savefig(out / "tu-va-tai-lieu.png", dpi=160, facecolor=surface)plt.close(fig)
Kết quả đã chạy: tìm đủ từ trả về [1, 4], tìm đúng cụm trả về [1]. Bạn có thể đổi thứ tự từ trong tài liệu 4 rồi chạy lại để thấy: các mã trong posting list có thể giữ nguyên, trong khi kết quả tìm cụm thay đổi.
Trở lại tài liệu hoàn tiền bị thất lạc
Ô tìm kiếm không cần đọc lại cả kho mỗi lần bạn gõ. Một phần công việc đã được làm từ trước: đọc tài liệu, ghi từ, giữ danh sách mã và vị trí cần thiết. Đến lúc hỏi, hệ thống mở đúng những trang có khả năng chứa câu trả lời.
Nhưng tìm nhanh chỉ là một phần. Cuốn sổ còn phải theo kịp tài liệu mới, phối hợp được giữa nhiều nơi và không chỉ tới trang người hỏi không được phép đọc. Đó là bước chuyển từ hiểu một cấu trúc dữ liệu sang thiết kế một hệ thống: không chỉ hỏi tra bằng cách nào, mà còn hỏi kết quả ấy đúng trong những điều kiện nào.
Vẽ minh họa hình học miễn phí cho học sinh và giáo viên: EyeViz.
Tài liệu tham khảo
- [1]Preferred Index Types for Text Search. PostgreSQL Documentation.
- [2]Text analysis. Elastic Documentation.
- [3]Near real-time search. Elastic Documentation.
- [4]Reading and writing documents. Elastic Documentation.
- [5]Similarity settings. Elastic Documentation.
- [6]Merge settings. Elastic Documentation.