Bài toán xét nghiệm và nghịch lý Simpson: hai bẫy thống kê
Vì sao xét nghiệm chính xác 99% vẫn có thể báo nhầm phần lớn ca dương tính, và vì sao tỷ lệ thành công đảo chiều khi gộp nhóm? Hiểu qua số dễ tính.
Mục lục
Bạn đi khám sức khỏe định kỳ và nhận tờ kết quả ghi “dương tính” với một bệnh hiếm. Bác sĩ nói xét nghiệm này đúng 99%. Phần lớn chúng ta sẽ nghĩ ngay: vậy khả năng mình mắc bệnh là 99%.
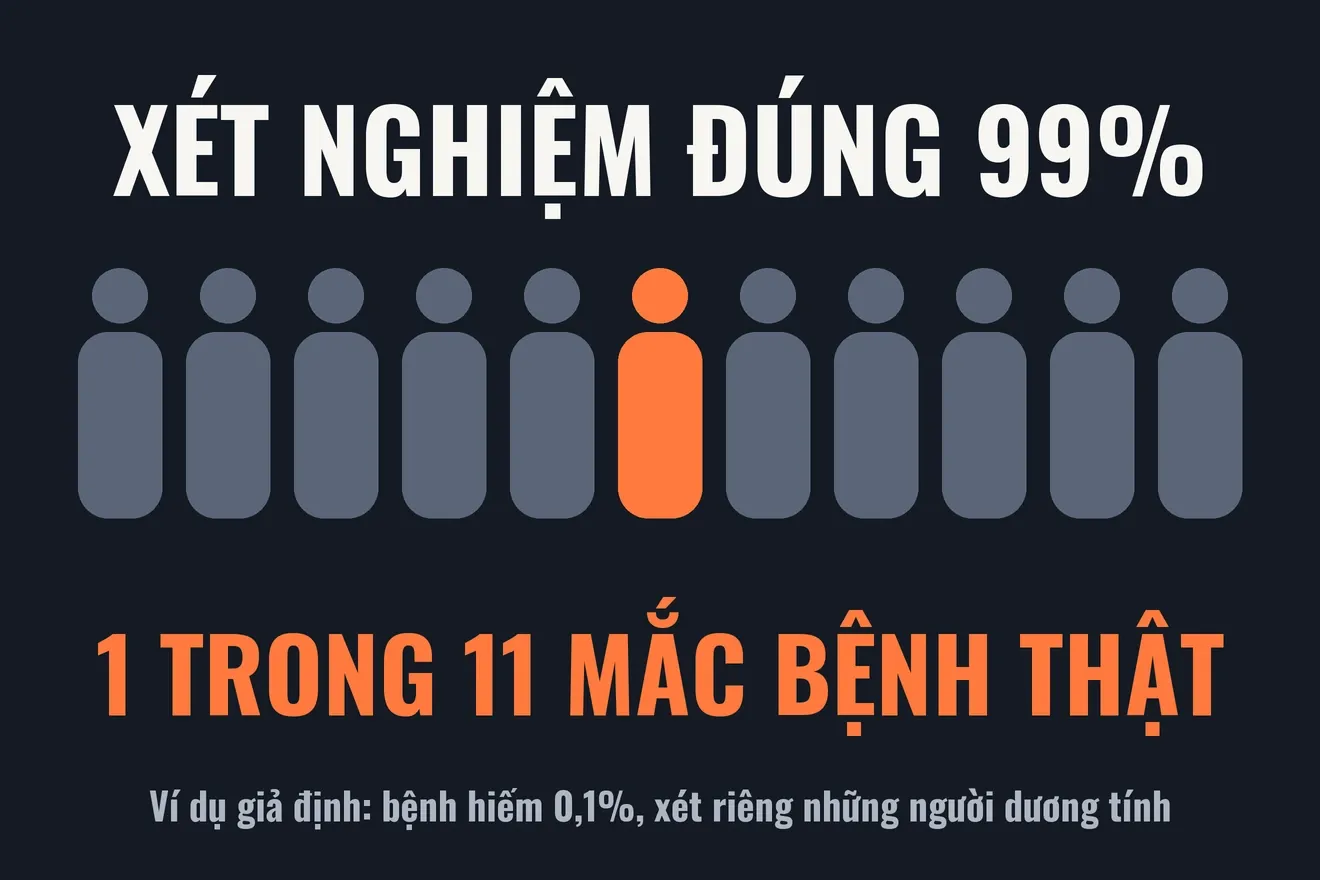
Đáp án của bài toán xét nghiệm này có thể khác rất xa. Nếu cứ 1.000 người chỉ có 1 người mắc bệnh, thì trong ví dụ giả định dưới đây, một kết quả dương tính chỉ tương ứng với khoảng 9% khả năng mắc bệnh thật. Xét nghiệm không hề kém. Con số 99% trả lời một câu hỏi, còn người cầm tờ kết quả đang hỏi một câu khác.
Bẫy thứ hai có tên là nghịch lý Simpson: một cách điều trị có tỷ lệ thành công cao hơn ở nhóm bệnh nhẹ, cao hơn ở nhóm bệnh nặng, nhưng thấp hơn khi gộp chung. Bài này giải cả hai bẫy bằng một câu hỏi duy nhất: tỷ lệ này được chia cho ai? Cuối bài, ta dùng đúng câu hỏi ấy cho một tín hiệu cổ phiếu bằng dữ liệu thật.
Xét nghiệm đúng 99% thì dương tính có chắc mắc bệnh không?
Hãy tưởng tượng cổng chống trộm ở siêu thị. Cứ 1.000 khách đi qua thì có 1 người giấu đồ trong túi. Cổng gần như luôn kêu với người đó, nhưng cũng kêu nhầm với 1% khách bình thường. Trong 1.000 khách, khoảng 10 người lương thiện làm cổng kêu, còn người giấu đồ chỉ có 1. Tiếng chuông rất nhạy, vậy mà đa số người bị giữ lại không làm gì sai.
Xét nghiệm cũng vậy. Ta đổi sang 100.000 người cho dễ đếm và giả định ba con số, chỉ để minh họa:
- Tỷ lệ mắc bệnh là 0,1%, tức 100 người mắc và 99.900 người không mắc.
- Trong số người mắc, xét nghiệm phát hiện 99%.
- Trong số người không mắc, xét nghiệm báo âm tính đúng 99%.
| Nhóm 100.000 người | Dương tính | Âm tính | Tổng |
|---|---|---|---|
| Mắc bệnh | 99 | 1 | 100 |
| Không mắc bệnh | 999 | 98.901 | 99.900 |
| Tổng | 1.098 | 98.902 | 100.000 |
Có 1.098 người nhận kết quả dương tính, nhưng chỉ 99 người mắc bệnh thật. Tỷ lệ là 99 / 1.098, tức khoảng 9%. Con số 99% nằm trong hai hàng của bảng, còn người cầm tờ kết quả đang đứng ở cột “Dương tính”. Hàng và cột có mẫu số khác nhau, nên đáp án khác nhau.
Cách kẻ bảng theo số người này được gọi là tần suất tự nhiên (natural frequencies). Giống như chia một nồi xôi cho cả xóm: đếm số suất dễ hơn nhiều so với cộng các phần trăm. Các nghiên cứu cho thấy người ta suy luận theo Bayes đúng hơn khi thông tin được trình bày theo cách này[3].
Độ nhạy, độ đặc hiệu và giá trị dự báo khác nhau thế nào?
Ba thuật ngữ này nghe giống nhau, nhưng mẫu số của chúng khác nhau[1][2].
Độ nhạy (sensitivity) là tỷ lệ phát hiện được trong số người thật sự mắc bệnh. Ở cổng siêu thị, đó là phần trăm người giấu đồ làm cổng kêu.
Độ đặc hiệu (specificity) là tỷ lệ báo âm tính đúng trong số người không mắc bệnh. Ở cổng siêu thị, đó là phần trăm khách bình thường đi qua yên ổn.
Giá trị dự báo dương (positive predictive value, PPV) là tỷ lệ mắc bệnh thật trong số người có kết quả dương tính. Ở cổng siêu thị, đó là phần trăm người bị giữ lại thật sự giấu đồ. Đây mới là con số người cầm tờ kết quả cần biết.
Độ nhạy và độ đặc hiệu mô tả xét nghiệm trong điều kiện đã đo. Giá trị dự báo dương còn phụ thuộc vào tỷ lệ nền (base rate), tức khả năng mắc bệnh trước khi làm xét nghiệm. Vì thế một xét nghiệm không có một PPV cố định cho mọi người[2]. Bỏ quên tỷ lệ nền là một lỗi quen thuộc, gọi là ngụy biện tỷ lệ nền (base rate fallacy)[3].
Vì sao cùng một xét nghiệm lại cho kết quả khác nhau ở mỗi người?
Giữ nguyên xét nghiệm, chỉ đổi người được xét nghiệm:
| Khả năng mắc trước xét nghiệm | Dương tính mà mắc bệnh thật |
|---|---|
| 0,1% | 9,0% |
| 1% | 50,0% |
| 10% | 91,7% |
| 20% | 96,1% |
| 50% | 99,0% |
Khi tầm soát cả một cộng đồng khỏe mạnh, bệnh hiếm khiến dương tính giả chiếm số đông. Khi một người đã có triệu chứng rõ và bác sĩ nghi ngờ sau khi khám, khả năng mắc ban đầu cao hơn nhiều, nên cùng kết quả dương tính lại mang ý nghĩa mạnh hơn. Trevethan cũng lưu ý rằng các chỉ số này phụ thuộc vào ngưỡng của xét nghiệm và mẫu người được nghiên cứu, nên không nên xem chúng là thuộc tính bất biến[1].
Điều này giải thích vì sao bác sĩ không chỉ đọc một dòng kết quả. Họ hỏi triệu chứng, tuổi, tiền sử gia đình và thường yêu cầu xét nghiệm xác nhận. Đó chính là cách đưa tỷ lệ nền vào phép tính, dù trên giấy không cần viết công thức nào.
Trong ví dụ trên, người có kết quả dương tính bước vào lần xét nghiệm thứ hai với khả năng mắc khoảng 9% thay vì 0,1%. Nếu lần thứ hai cũng dương tính, và sai số của hai lần thật sự độc lập, khả năng mắc tăng lên khoảng 90,7%. Chữ “độc lập” rất quan trọng. Lặp lại đúng một xét nghiệm có thể lặp lại đúng nguyên nhân gây sai, nên xét nghiệm xác nhận thường cần một cách đo khác.
Bạn có thể xem công thức Bayes đầy đủ trong bài toán Monty Hall. Ở đây chỉ cần viết gọn đúng phép đếm trên bảng:
Trong đó là độ nhạy, là độ đặc hiệu, là tỷ lệ nền. Tử số là số người dương tính thật. Mẫu số là toàn bộ người dương tính, gồm thật và giả.
Nghịch lý Simpson là gì?
Bẫy thứ nhất đến từ việc đọc nhầm mẫu số. Bẫy thứ hai đến từ việc trộn các mẫu số có cơ cấu khác nhau.
Hình dung hai thợ sửa xe trong cùng một khu phố, với số liệu tự đặt để minh họa. Thợ An nhận 90 xe khó và 10 xe dễ. Thợ Bình nhận 10 xe khó và 90 xe dễ.
| Loại xe | Thợ An | Thợ Bình |
|---|---|---|
| Xe khó | 54/90 = 60% | 5/10 = 50% |
| Xe dễ | 10/10 = 100% | 81/90 = 90% |
| Gộp chung | 64/100 = 64% | 86/100 = 86% |
Ở từng loại xe, An đều sửa tốt hơn. Khi gộp chung, An lại thua xa. Không có phép tính nào sai. An bị kéo xuống vì nhận phần lớn việc khó, còn Bình được kéo lên vì nhận phần lớn việc dễ.
Đó là nghịch lý Simpson: một xu hướng xuất hiện trong từng nhóm nhưng biến mất hoặc đảo chiều khi gộp các nhóm lại[5]. Edward Simpson mô tả hiện tượng này trong một bài báo kỹ thuật năm 1951[4]. Karl Pearson và Udny Yule đã nhắc tới các hiệu ứng tương tự từ trước đó, còn tên gọi “nghịch lý Simpson” do Colin Blyth đưa ra năm 1972[5].
Biến ẩn phía sau, ở đây là độ khó của xe, được gọi là biến gây nhiễu (confounder). Nó vừa ảnh hưởng tới việc xe được giao cho ai, vừa ảnh hưởng tới kết quả sửa. Giống như so sánh điểm trung bình của hai lớp mà quên rằng một lớp thi đề khó hơn.
Nghịch lý Simpson trong điều trị sỏi thận
Năm 1986, Charig và cộng sự công bố kết quả điều trị sỏi thận trên 1.052 bệnh nhân. Mổ mở thành công 273/350 ca, tức 78%. Lấy sỏi qua da thành công 289/350 ca, tức 83%. Thành công được định nghĩa là sỏi hết hoặc còn dưới 2 mm sau ba tháng[7].
Julious và Mullee sau đó dùng số liệu này để minh họa nhiễu và nghịch lý Simpson[8]. Khi tách theo kích thước sỏi, thứ tự đổi chiều[5]:
| Kích thước sỏi | Mổ mở | Lấy sỏi qua da |
|---|---|---|
| Sỏi nhỏ | 81/87 = 93% | 234/270 = 87% |
| Sỏi lớn | 192/263 = 73% | 55/80 = 69% |
| Gộp chung | 273/350 = 78% | 289/350 = 83% |
Mổ mở nhận nhiều ca sỏi lớn, vốn khó hơn. Lấy sỏi qua da nhận nhiều ca sỏi nhỏ, vốn dễ hơn. Câu chuyện giống hệt hai thợ sửa xe.
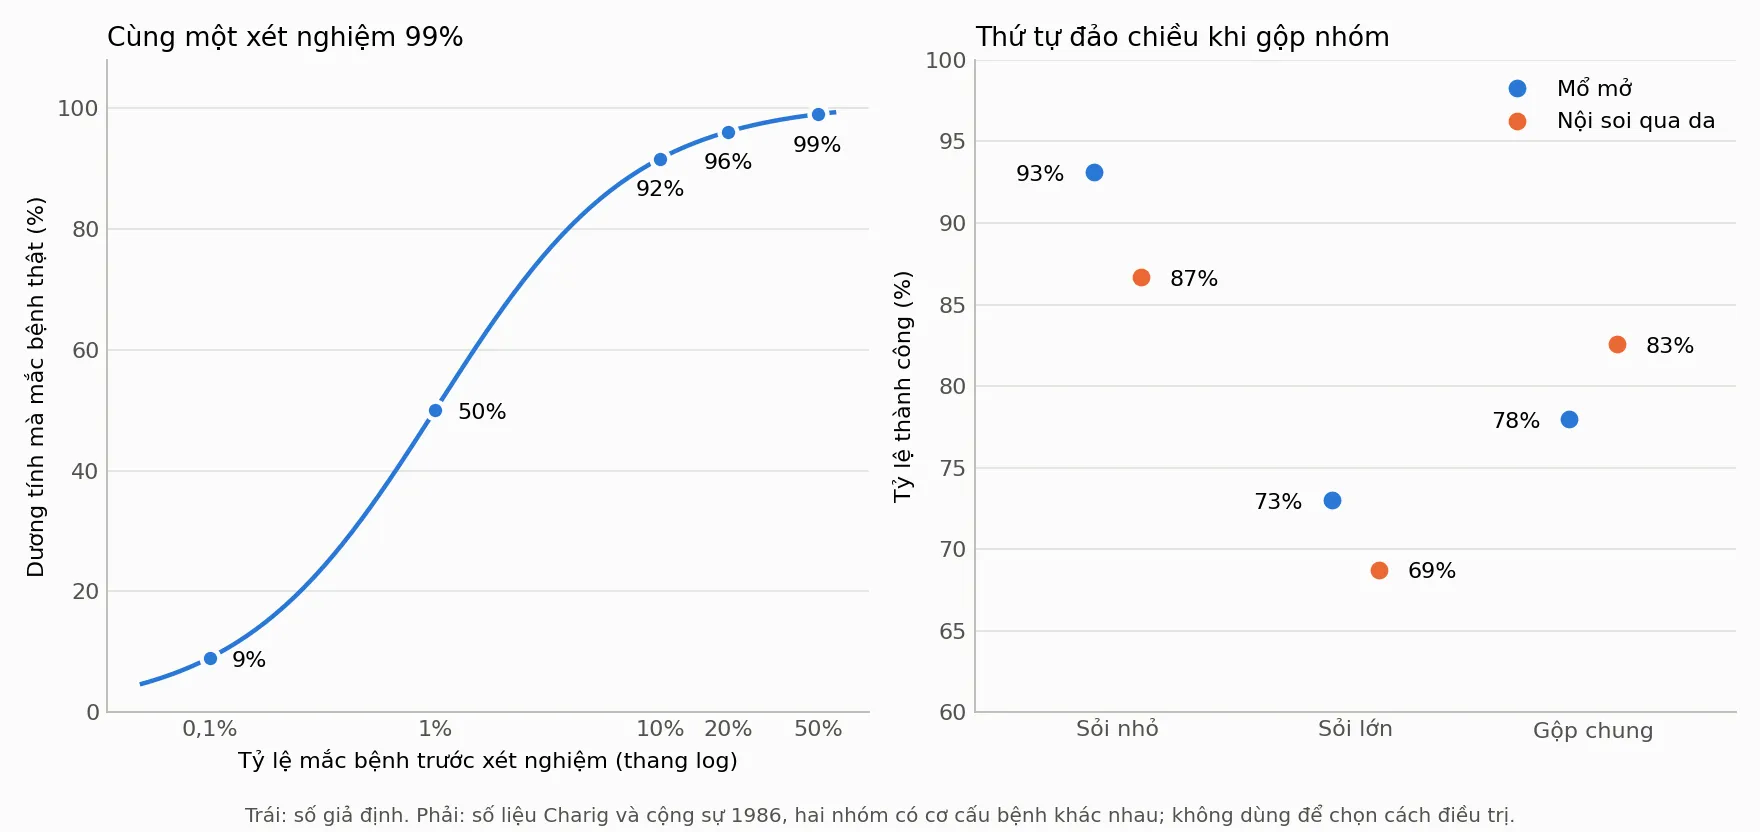
Nếu đưa cả hai phương pháp về cùng một cơ cấu sỏi, chẳng hạn cơ cấu chung của 700 ca, mổ mở đạt khoảng 83,3%, còn lấy sỏi qua da đạt khoảng 77,9%. Phép tính này chỉ cho thấy cơ cấu bệnh nhân đã tạo ra đảo chiều. Nó không kết luận phương pháp nào nên dùng hôm nay. Muốn biết điều đó cần nhiều dữ liệu hơn, gồm biến chứng, chi phí, thời gian hồi phục và các kỹ thuật mới. Chính bài của Charig cũng ghi nhận mức chi phí và thời gian hồi phục khác nhau giữa các phương pháp[7].
Berkeley có thật sự phân biệt giới tính khi tuyển sinh?
Mùa thu năm 1973, số liệu tuyển sinh sau đại học của Đại học California, Berkeley cho thấy 44% nam được nhận, so với 35% nữ. Chênh lệch này đủ lớn để khó giải thích bằng ngẫu nhiên[5]. Nhìn vào con số gộp, kết luận tự nhiên là trường thiên vị nam.
Bickel và cộng sự xem xét theo từng khoa[6]. Nữ có xu hướng nộp vào các khoa cạnh tranh hơn, nơi tỷ lệ nhận thấp cho mọi người. Nam có xu hướng nộp vào các khoa dễ được nhận hơn. Khi đã tính tới khoa, bức tranh chung không cho thấy trường thiên vị nam như con số gộp gợi ý. Trong toàn bộ 85 khoa, có 4 khoa lệch đáng kể bất lợi cho nữ và 6 khoa lệch đáng kể bất lợi cho nam[5].
Câu chuyện không dừng ở chỗ “gộp là sai”. Câu hỏi tiếp theo vẫn còn nguyên: vì sao nữ tập trung nộp vào những khoa khó được nhận hơn? Thống kê tách nhóm chỉ đẩy câu hỏi tới đúng chỗ hơn, không xóa nó đi.
Khi nào nên tách nhóm, khi nào không?
Một cách hiểu sai phổ biến là “luôn tách nhóm thì an toàn”. Thật ra, muốn chọn con số nào phải biết các biến liên hệ với nhau ra sao, và chỉ dữ liệu trong bảng thì không đủ cho biết điều đó[5].
Kích thước sỏi có trước khi điều trị, nên nó có thể ảnh hưởng tới việc chọn phương pháp. Đây là biến gây nhiễu, và tách theo nó là hợp lý.
Bây giờ xét một ví dụ giả định khác. Một loại thuốc hạ huyết áp, và nhờ đó giảm biến chứng. Nếu tách bệnh nhân theo huyết áp sau khi uống thuốc, ta có thể làm biến mất đúng con đường mà thuốc phát huy tác dụng. Giống như muốn biết phân bón có giúp lúa hay không, nhưng chỉ so các thửa có cùng chiều cao cây vào cuối vụ. Chiều cao ấy đã là kết quả của phân bón, nên không còn là điều kiện ban đầu. Trường hợp này con số gộp mới trả lời đúng câu hỏi.
Hai ví dụ dùng cùng phép tính nhưng dẫn tới hai lựa chọn ngược nhau. Khác biệt nằm ở câu chuyện nhân quả: biến dùng để tách có trước hay có sau nguyên nhân ta đang xét. Đây cũng là lý do thử nghiệm ngẫu nhiên có đối chứng được coi trọng: phân nhóm ngẫu nhiên làm các nhóm tương đồng về cả những biến ta chưa nghĩ tới.
Có thể rút ra ba câu hỏi ngắn trước khi tin một tỷ lệ:
- Mẫu số là ai? Người mắc bệnh, người dương tính, hay toàn bộ người được xét nghiệm?
- Tỷ lệ nền là bao nhiêu? Sự kiện này vốn hiếm hay phổ biến?
- Các nhóm có cùng cơ cấu không? Nếu không, biến khác nhau xảy ra trước hay sau nguyên nhân đang xét?
Câu hỏi thứ ba cũng gần với survivorship bias: trước khi đọc kết quả, phải hỏi dữ liệu trước mặt đã được chọn lọc thế nào. Khi cần so sánh trước và sau một hành động, bài hồi quy về trung bình nói về một cái bẫy khác có thể xuất hiện cùng lúc.
Tín hiệu cổ phiếu có phải một xét nghiệm dương tính không?
Một tín hiệu đầu tư cũng giống một xét nghiệm. “Bệnh” là biến cố ta muốn dự báo, còn “dương tính” là ngày tín hiệu xuất hiện. Mình thử trên giá đóng cửa của FPT từ tháng 1/2020 đến tháng 12/2025. Quy tắc được chốt trước khi xem kết quả, và mình không thử biến thể khác:
- Tín hiệu: giá đóng cửa hôm nay vượt mức cao nhất của 20 phiên liền trước.
- Biến cố: sau đúng 20 phiên, giá đóng cửa cao hơn hôm nay ít nhất 10%.
Trong 1.479 phiên đo được, biến cố xảy ra ở 229 phiên, nên tỷ lệ nền là 15,5%. Tín hiệu xuất hiện 221 lần, và 35 lần trong đó có biến cố theo sau.
| Năm | Số lần có tín hiệu | Biến cố khi có tín hiệu | Biến cố khi không có tín hiệu |
|---|---|---|---|
| 2020 | 35 | 14,3% | 19,4% |
| 2021 | 41 | 26,8% | 17,2% |
| 2022 | 28 | 17,9% | 11,8% |
| 2023 | 46 | 8,7% | 12,8% |
| 2024 | 54 | 18,5% | 28,1% |
| 2025 | 17 | 0,0% | 4,2% |
| Gộp chung | 221 | 15,8% | 15,4% |
Con số 15,8% gần như trùng tỷ lệ nền. Tín hiệu xuất hiện ở 15,3% phiên có biến cố và 14,9% phiên không có biến cố. Khi hai tỷ lệ này gần bằng nhau, “dương tính” không làm thay đổi đáng kể niềm tin của ta, cũng như một xét nghiệm kêu với người bệnh và người khỏe gần như nhau.
Bảng theo năm cho thấy thêm một điều. Gộp sáu năm, ngày có tín hiệu nhỉnh hơn 0,4 điểm phần trăm. Nhưng tín hiệu kém hơn ở bốn trong sáu năm, và nếu lấy trung bình chênh lệch từng năm theo số phiên, nó thấp hơn khoảng 1,2 điểm phần trăm. Đây không phải một nghịch lý Simpson trọn vẹn, vì 2021 và 2022 đi theo chiều ngược lại. Nó chỉ cho thấy cơ chế ấy ở mức nhỏ: tín hiệu xuất hiện nhiều trong năm 2024, năm có tỷ lệ nền cao, nên con số gộp được nâng lên. Với dữ liệu này, điều trung thực nhất là nói tín hiệu không cho thấy lợi thế rõ ràng.
Tự tay chạy: vẽ hai bẫy thống kê
Đoạn Python dưới đây chỉ cần matplotlib. Nó tính bảng giá trị dự báo dương, tính bảng sỏi thận và xuất đúng Hình 1. Không có yếu tố ngẫu nhiên nên chạy lại vẫn ra cùng kết quả.
import matplotlib.pyplot as plt
# Phần 1: xét nghiệm giả định, độ nhạy 99%, độ đặc hiệu 99%def ppv(prevalence, sens=0.99, spec=0.99):    true_pos = sens * prevalence    false_pos = (1 - spec) * (1 - prevalence)    return true_pos / (true_pos + false_pos)
marks = [0.001, 0.01, 0.1, 0.2, 0.5]for p in marks:    print(f"Tỷ lệ mắc {p:6.1%} -> dương tính mắc bệnh thật {ppv(p):6.1%}")print(f"Xét nghiệm độc lập lần hai: {ppv(ppv(0.001)):.1%}")
# Phần 2: bảng sỏi thận, (số ca thành công, số ca)data = {"Mổ mở": {"Sỏi nhỏ": (81, 87), "Sỏi lớn": (192, 263)},        "Nội soi qua da": {"Sỏi nhỏ": (234, 270), "Sỏi lớn": (55, 80)}}groups = ["Sỏi nhỏ", "Sỏi lớn"]size = {g: sum(data[t][g][1] for t in data) for g in groups}total = sum(size.values())rates = {}for t, row in data.items():    wins = sum(a for a, _ in row.values())    cases = sum(b for _, b in row.values())    fixed_mix = sum(row[g][0] / row[g][1] * size[g] / total for g in groups)    rates[t] = [row[g][0] / row[g][1] for g in groups] + [wins / cases]    print(f"{t}: gộp {wins}/{cases} = {wins / cases:.1%}, cùng cơ cấu = {fixed_mix:.1%}")
# Phần 3: vẽ hai ô, mỗi ô một câu hỏi, không dùng hai trục tungfig, (left, right) = plt.subplots(1, 2, figsize=(11, 5.2), dpi=160, facecolor="#fcfcfb")xs = [0.0005 * 1.05 ** i for i in range(146)]left.semilogx(xs, [ppv(x) * 100 for x in xs], color="#2a78d6", lw=2)for p in marks:    y = ppv(p) * 100    left.plot(p, y, "o", color="#2a78d6", ms=8, mec="#fcfcfb", mew=2)    left.annotate(f"{y:.0f}%", (p, y), (0, -17) if p >= 0.1 else (10, -4),                  textcoords="offset points", ha="center" if p >= 0.1 else "left", fontsize=10)left.set_xticks(marks, ["0,1%", "1%", "10%", "20%", "50%"])left.minorticks_off()left.set_ylim(0, 108)left.set_xlabel("Tỷ lệ mắc bệnh trước xét nghiệm (thang log)")left.set_ylabel("Dương tính mà mắc bệnh thật (%)")left.set_title("Cùng một xét nghiệm 99%", loc="left", fontsize=12)
names = ["Sỏi nhỏ", "Sỏi lớn", "Gộp chung"]for t, color, offset in [("Mổ mở", "#2a78d6", -0.1), ("Nội soi qua da", "#eb6834", 0.1)]:    ys = [r * 100 for r in rates[t]]    right.plot([i + offset for i in range(3)], ys, "o", color=color, ms=10,               mec="#fcfcfb", mew=2, label=t)    for i, y in enumerate(ys):        right.annotate(f"{y:.0f}%", (i + offset, y), (-24 if offset < 0 else 24, -4),                       textcoords="offset points", ha="center", fontsize=10)right.set_xticks(range(3), names)right.set_xlim(-0.6, 2.6)right.set_ylim(60, 100)right.set_ylabel("Tỷ lệ thành công (%)")right.set_title("Thứ tự đảo chiều khi gộp nhóm", loc="left", fontsize=12)right.legend(frameon=False, loc="upper right")
for ax in (left, right):    ax.set_facecolor("#fcfcfb")    ax.grid(axis="y", color="#e4e3df", lw=0.8)    ax.spines[["top", "right"]].set_visible(False)    ax.spines[["left", "bottom"]].set_color("#b8b7b0")    ax.tick_params(colors="#52514e", length=0)fig.text(0.5, 0.012, "Trái: số giả định. Phải: số liệu Charig và cộng sự 1986, hai nhóm có cơ cấu bệnh khác nhau; không dùng để chọn cách điều trị.",         ha="center", color="#52514e", fontsize=9)fig.tight_layout(rect=(0, 0.04, 1, 1))fig.savefig("bay-ti-le.png", facecolor="#fcfcfb")
Tỷ lệ mắc 0.1% -> dương tính mắc bệnh thật 9.0%Tỷ lệ mắc 1.0% -> dương tính mắc bệnh thật 50.0%Tỷ lệ mắc 10.0% -> dương tính mắc bệnh thật 91.7%Tỷ lệ mắc 20.0% -> dương tính mắc bệnh thật 96.1%Tỷ lệ mắc 50.0% -> dương tính mắc bệnh thật 99.0%Xét nghiệm độc lập lần hai: 90.7%Mổ mở: gộp 273/350 = 78.0%, cùng cơ cấu = 83.3%Nội soi qua da: gộp 289/350 = 82.6%, cùng cơ cấu = 77.9%Thử đổi độ đặc hiệu từ 0,99 thành 0,999 và giữ tỷ lệ mắc 0,1%. Giá trị dự báo dương tăng lên khoảng 50%, dù độ đặc hiệu chỉ nhích thêm chưa tới một điểm phần trăm. Với bệnh hiếm, số dương tính giả mới là thứ quyết định.
Trở lại tờ kết quả xét nghiệm
Tờ giấy ghi “dương tính” và con số 99% đều không sai. Thứ còn thiếu là một câu hỏi: 99% của ai? Với một bệnh hiếm và một người không có triệu chứng, nhóm đang đứng cùng bạn gồm rất nhiều người khỏe mạnh nhận kết quả dương tính giả. Vì thế bước tiếp theo là xét nghiệm xác nhận, không phải tự kết luận.
Thợ An, bệnh nhân sỏi lớn và các khoa khó vào ở Berkeley đều cho thấy cùng một điều ở chiều ngược lại. Một tỷ lệ gộp có thể phản ánh việc ai được xếp vào nhóm nào nhiều hơn phản ánh chất lượng của thứ đang được đo.
Trước khi tin một phần trăm, hãy đọc mẫu số của nó.
Vẽ minh họa hình học miễn phí cho học sinh và giáo viên: EyeViz.
Tài liệu tham khảo
- [1]Robert Trevethan. Sensitivity, Specificity, and Predictive Values: Foundations, Pliabilities, and Pitfalls in Research and Practice. Frontiers in Public Health, 5, 307, 2017.
- [2]Positive and negative predictive values. Wikipedia, 2026.
- [3]Base rate fallacy. Wikipedia, 2026.
- [4]Edward H. Simpson. The Interpretation of Interaction in Contingency Tables. Journal of the Royal Statistical Society, Series B, 13(2), 238–241, 1951.
- [5]Simpson's paradox. Wikipedia, 2026.
- [6]P. J. Bickel, E. A. Hammel, J. W. O'Connell. Sex Bias in Graduate Admissions: Data from Berkeley. Science, 187(4175), 398–404, 1975.
- [7]C. R. Charig, D. R. Webb, S. R. Payne, J. E. Wickham. Comparison of treatment of renal calculi by open surgery, percutaneous nephrolithotomy, and extracorporeal shockwave lithotripsy. British Medical Journal, 292(6524), 879–882, 1986.
- [8]Steven A. Julious, Mark A. Mullee. Confounding and Simpson's paradox. BMJ, 309(6967), 1480–1481, 1994.